Como fazer upgrade major do PostgreSQL sem downtime em um cluster distribuído
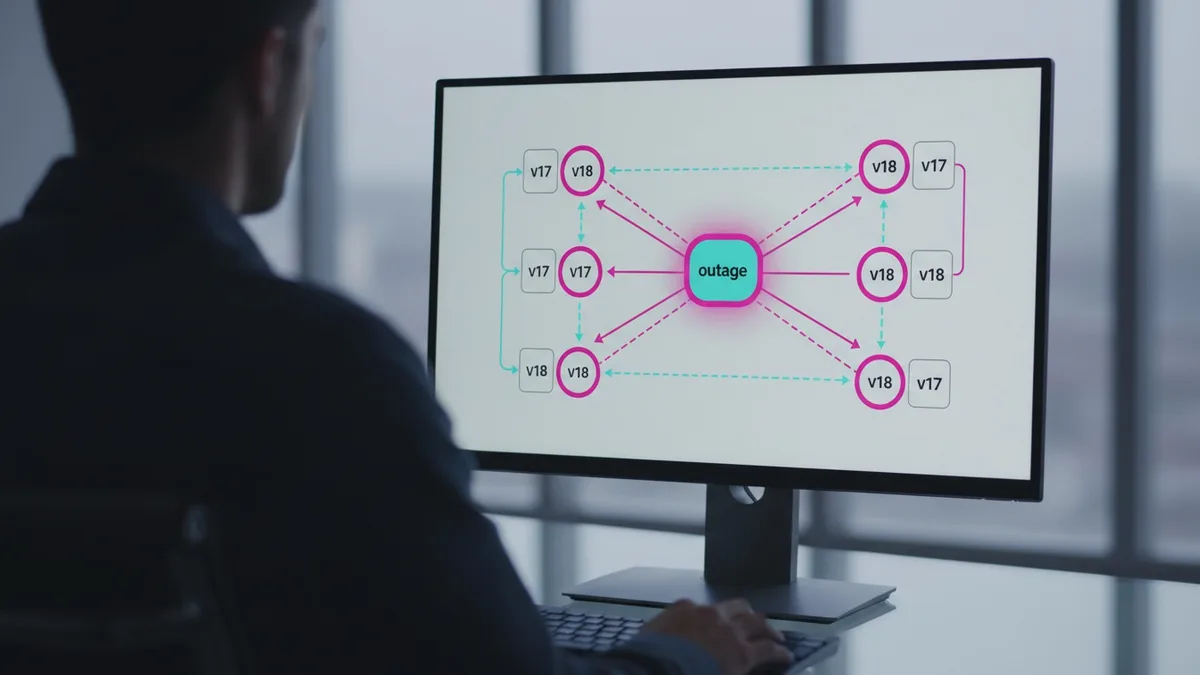
Um teste publicado pela pgEdge em 5 de novembro mostra como atualizar um nó de PostgreSQL 17 para 18 sem copiar o banco inteiro, usando as outras réplicas do cluster multi-master para segurar a aplicação enquanto o nó some por alguns minutos.
- Leitura
- 7 min
- Tabelas
- 1
- Código
- 3
- Fontes
- 1
Um teste publicado pela pgEdge em 5 de novembro mostra como atualizar um nó de PostgreSQL↳PostgreSQL11 conteúdosPostgreSQL via SSL com GolangData · abr 20195 itens legais sobre data types do PostgreSQLData · mar 20195 serviços gratuitos na cloud para bancos de dados PostgresData · fev 2025Ver tudo em Data → 17 para 18 sem copiar o banco inteiro, usando as outras réplicas do cluster multi-master para segurar a aplicação enquanto o nó some por alguns minutos.
Em post publicado em 5 de novembro de 2026 no Planet PostgreSQL, Ahsan Hadi e Susan Douglas, da pgEdge, documentam uma segunda forma de fazer upgrade major em um cluster distribuído: atualizar cada nó no próprio lugar, em vez de subir uma máquina nova para cada um. É a continuação de um post anterior dos mesmos autores sobre upgrade por rotação (rolling), e resolve um problema prático: nem todo time tem hardware sobrando para manter uma cópia extra do banco durante a migração.
O cenário usado no teste é um cluster Spock de três nós (a extensão de replicação lógica multi-master da pgEdge), rodando em duas VMs Rocky Linux↳Linux34 conteúdosKali Linux em um Servidor VPS: como, quando e por que usar?DevSecOps · dez 2024Construindo um Windows Service ou Linux Daemon com Worker Service & .NET Core – Parte 2Dev (Back & Front) · jul 2020Criando uma WebApi utilizando .NET, Linux e VSCodeDev (Back & Front) · ago 2019Ver tudo em DevSecOps → ARM64. Um dos nós, com um standby físico gerenciado por Patroni, saiu do PostgreSQL 17.10 e chegou ao 18.6 com pg_upgrade --link. O resultado funcionou, mas a estrada tinha buracos que o --check do pg_upgrade não avisa.
Duas estratégias, um trade-off direto
A diferença entre as duas abordagens é hardware contra tempo de operação manual. Na rotação, você sobe um nó novo já na versão alvo, deixa o Spock sincronizar e aposenta o antigo: zero indisponibilidade até para o próprio nó, mas exige uma máquina extra por nó durante a transição. No in-place, o nó sai do ar por alguns minutos, mas os outros continuam aceitando escrita o tempo todo.
| Abordagem | Hardware extra | Nó fica indisponível | Esforço manual |
|---|---|---|---|
| Rolling (nó novo) | Sim, uma máquina por nó | Não | Menor |
In-place (pg_upgrade --link) | Não | Sim, minutos | Maior, com passos não documentados |
Em resumo: se o banco é grande demais para duplicar ou o orçamento de infraestrutura não permite uma cópia temporária, o caminho in-place é a opção; o preço é mais trabalho manual e mais pontos de atenção.
O roteiro, nó a nó
O processo descrito é sequencial e exige pelo menos três nós no cluster, para que dois sigam de pé enquanto um é atualizado:
- Drenar tráfego do nó, pausar o Patroni, parar primeiro o standby e depois o nó principal.
- Instalar o PostgreSQL 18, rodar
initdbem um diretório novo e colocar as configurações do Spock nele. - Rodar
pg_upgrade --link, que faz hard link dos arquivos de dados em vez de copiá-los. - Subir o nó na versão 18 e restaurar manualmente o progresso de replicação do Spock.
- Devolver o nó ao Patroni e reconstruir o standby a partir dele.
Antes de começar, o post recomenda checar server_encoding, a versão do spock instalada via pg_extension e o checksum version com pg_controldata. A nova versão precisa bater exatamente com esses três valores.
A armadilha do checksum por padrão
Desde o PostgreSQL 18, o initdb ativa checksums de página por padrão. Se o cluster antigo não usa checksums, só rodar initdb sem flag não resolve, e o pg_upgrade --check para na hora com o erro "old cluster does not use data checksums but the new one does". A correção é explícita:
O nó atualizado fica offline, mas em um cluster multi-master os outros nós continuam aceitando escritas o tempo todo, então a aplicação nunca perde um endpoint gravável.
No original: The node being upgraded does go down, but in a multi-master cluster the other nodes keep taking writes the whole time, so the application never loses a writable endpoint.
/usr/pgsql-18/bin/initdb -D ~/n3data_new --encoding=UTF8 --no-data-checksumsO segundo bloqueio de configuração é o Spock. A extensão precisa estar em shared_preload_libraries antes de rodar o pg_upgrade, senão o check falha com "spock is not in shared_preload_libraries". As configurações do nó antigo (incluindo wal_level = logical, track_commit_timestamp = on e max_replication_slots) precisam estar copiadas no postgresql.conf do novo diretório antes do upgrade rodar, não depois.
O ponto que decide se a técnica funciona: replication origins
Esta é a parte mais importante do post: o pg_upgrade só preserva slots de replicação lógica nativos do PostgreSQL. Ele carrega os slots do Spock (se a origem for PostgreSQL 17; em 15 ou 16 nem isso acontece), mas não carrega os replication origins, que são o mecanismo que o Spock usa para saber até onde cada assinatura já aplicou mudanças.
Sem os origins, o nó atualizado passa a enviar alterações normalmente, mas para de aplicar as que recebe dos outros nós, e nada no status de subscrição avisa isso. No teste, spock.sub_show_status() mostrava os outros nós como "replicating" enquanto o log do nó recém-atualizado acusava:
ERROR: replication origin "spk_testdb_n1_sub_n1_n3" does not existA correção é recriar cada origin na posição em que o slot do lado provedor confirmou pela última vez (o confirmed_flush_lsn, que sobrevive ao upgrade porque está no slot, não no origin):
L1=$(psql -h 192.168.169.158 -p 5432 -d testdb -Atc \
 "SELECT confirmed_flush_lsn FROM pg_replication_slots WHERE slot_name='spk_testdb_n1_sub_n1_n3';")

psql -p 5442 -d testdb \
 -c "SELECT pg_replication_origin_create('spk_testdb_n1_sub_n1_n3');" \
 -c "SELECT pg_replication_origin_advance('spk_testdb_n1_sub_n1_n3', '$L1');"
A parte mais importante deste post é esta. O Spock controla até onde cada assinatura aplicou usando replication origins, e o pg_upgrade não os carrega. Ele faz isso só para assinaturas nativas do PostgreSQL.
pgEdge (post assinado por Ahsan Hadi e Susan Douglas)This is the most important part of this post. Spock tracks how far each subscription has applied using replication origins, and pg_upgrade does not carry them over. It only does that for native PostgreSQL subscriptions.
A lição prática para quem opera isso: nunca confiar só no status da subscrição depois de um upgrade. O teste recomendado é escrever em um nó e conferir se a escrita aparece no nó recém-atualizado, em ambas as direções, antes de seguir para o próximo da fila.
Patroni também tem surpresas
Devolver o nó ao Patroni não é só trocar data_dir e bin_dir no YAML; um patronictl reload não é suficiente, é preciso reiniciar o processo do Patroni. E aí vem outro obstáculo: o pg_upgrade gera um novo identificador de sistema (system ID) para o cluster, e o etcd ainda guarda o antigo. Resumir o Patroni nesse estado faz ele simplesmente sair do ar.
A solução é remover o registro do cluster do etcd com patronictl remove e deixar o Patroni adotar a instância em execução de novo. Isso só funciona de forma limpa se as configurações do Spock (wal_level, shared_preload_libraries) estiverem na seção bootstrap.dcs do YAML do Patroni; sem isso, o Patroni sobrescreve essas configurações com os próprios padrões ao adotar o nó.
Standby não acompanha a versão nova sozinho
Um standby físico não consegue seguir um primário que passou por um upgrade major: o identificador de sistema mudou, e tentar um reinit pelo Patroni resulta em "system ID mismatch". A saída é apagar o diretório de dados antigo do standby e deixar o Patroni rodar pg_basebackup sozinho a partir do novo líder, o que acontece automaticamente quando ele encontra um diretório vazio.
Vale lembrar ainda que tudo configurado via ALTER SYSTEM fica no postgresql.auto.conf, e esse arquivo não é transportado pelo pg_upgrade. Parâmetros como synchronized_standby_slots, usados para garantir que os outros nós Spock não avancem além do standby, precisam ser reaplicados manualmente depois do upgrade.
Checklist final antes de avançar pro próximo nó
O próprio pg_upgrade lista três tarefas finais, que o post reforça como obrigatórias antes de considerar o nó pronto:
psql -f update_extensions.sqlpara atualizar extensões cuja versão mudou entre os builds.- Dois
vacuumdb(um com--analyze-in-stages --missing-stats-only, outro com--analyze-only) para reconstruir estatísticas que o upgrade não transporta. - Apagar o cluster antigo só depois de confirmar que o novo está estável.
Quando faz sentido escolher este caminho
Essa técnica é específica de um cluster distribuído com Spock da pgEdge, não um recurso genérico de streaming replication do PostgreSQL vanilla. Ela compensa quando faltam recursos para duplicar hardware ou quando o volume de dados torna inviável manter uma cópia completa rodando em paralelo durante a migração. Em troca, exige disciplina em cada um dos pontos acima: checksums, ordem das configurações, origins recriados manualmente, etcd limpo e standby reconstruído do zero.
Quem tem orçamento para subir uma máquina extra por nó, mesmo que temporária, sai ganhando com a simplicidade do caminho de rotação descrito no post anterior dos mesmos autores. O caminho in-place só vale a complexidade quando essa máquina extra não é uma opção.
Fonte: Planet PostgreSQL
Highlights
- pgEdge testa upgrade in-place de PostgreSQL 17.10 para 18.6 usando pg_upgrade --link em cluster Spock
- pg_upgrade não transporta replication origins do Spock; precisam ser recriados manualmente para sincronização funcionar
- Nó fica offline minutos, mas outros nós multi-master continuam aceitando escrita sem interrupção para aplicação
- Standby físico não segue versão nova sozinho; requer pg_basebackup limpo pelo Patroni após atualização
- Técnica compensa quando falta hardware extra, mas exige disciplina em checksums, configurações e sincronização manual
Este artigo foi escrito por Roberto Diniz, colunista de banco de dados. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Como o GitLab apagaria uma tabela de 4 TB no PostgreSQL sem travar as réplicas
Um teste real em PostgreSQL 18.6 mostra o que o DROP TABLE custa em lock, WAL e réplicas, a partir de um caso levado pelo GitLab ao PGConf.EU em Valencia. A resposta certa quase sempre passa por particionar antes de apagar.