O reserved_connections do PostgreSQL 16 garante conexão para monitoramento e backup quando a aplicação esgota o pool
Lançado no PostgreSQL 16, em 2023, o parâmetro cria uma segunda reserva de conexões, separada da do superusuário, para que monitoramento, backup e DBA ainda consigam entrar quando a aplicação consome todo o pool.
Christophe Pettus, consultor de PostgreSQL↳PostgreSQL11 conteúdosPostgreSQL via SSL com GolangData · abr 20195 itens legais sobre data types do PostgreSQLData · mar 20195 serviços gratuitos na cloud para bancos de dados PostgresData · fev 2025Ver tudo em Data → pela PGX Inc., publicou no Planet PostgreSQL um detalhamento técnico do reserved_connections, parâmetro incluído no PostgreSQL 16 (lançado em 2023) e ainda pouco usado em produção. O texto é parte de uma série sobre GUCs (os parâmetros de configuração do Postgres) e nasce de um problema concreto: a aplicação satura o max_connections, e nesse momento o monitoramento, o pg_dump do backup e o humano com o pager descobrem que também não conseguem entrar.
O reserve que protegia a conta errada
Desde o PostgreSQL 7.3, o superuser_reserved_connections reserva algumas conexões, mas só para contas com o atributo SUPERUSER. Pettus observa que isso protege a conta errada: ninguém conecta em produção como superusuário se puder evitar, e em serviço gerenciado ninguém consegue mesmo. Quem precisa entrar quando o pool está cheio é o agente de monitoramento, o job de backup e o DBA de plantão, todos com papéis comuns, sem privilégio de superusuário.
Esses papéis ficam trancados do lado de fora junto com a aplicação. O reserved_connections resolve isso criando uma segunda reserva, posicionada à frente da reserva de superusuário, para papéis escolhidos pelo administrador.
Um portão, não uma cota
O mecanismo não é uma cota reservada antecipadamente: é um portão verificado no momento da conexão. O backend↳Back-end49 conteúdosIntegração front-end com backend: 7 decisões que evitam caos entre APIs, BFF e GraphQLDev (Back & Front) · abr 2026Como criar uma FAKE API REST para testes — JSONPlaceholderDev (Back & Front) · set 2025Construindo um aplicativo de bate-papo de IA simples com Spring AI e AngularDev (Back & Front) · jul 2025Ver tudo em Dev (Back & Front) → novo já tomou um slot do pool regular depois de autenticar; só então o Postgres conta quantos slots livres sobraram e compara esse número às duas reservas.
Se sobrarem menos slots livres que superuser_reserved_connections, só um superusuário pode ficar com a conexão; qualquer outro papel recebe FATAL: remaining connection slots are reserved for roles with the SUPERUSER attribute. Se sobrar um número entre as duas reservas somadas, a conexão vai para superusuários e para papéis com os privilégios do papel predefinido pg_use_reserved_connections; qualquer outro papel recebe FATAL: remaining connection slots are reserved for roles with privileges of the "pg_use_reserved_connections" role.
Superusuários pulam essa verificação inteira, o que significa que também podem consumir todos os slots e, aí sim, esbarrar no genérico sorry, too many clients already como qualquer um. As três mensagens carregam o mesmo SQLSTATE 53300, então qualquer alerta de exaustão de conexão que já monitore esse código captura também este caso.
A aritmética em números
Num max_connections = 100 com superuser_reserved_connections no padrão de 3 e reserved_connections = 10, a distribuição fica assim:
| Papel | Slots efetivamente disponíveis |
|---|---|
| Papéis comuns (aplicação) | 87 |
Membros de pg_use_reserved_connections | 97 |
| Superusuários | 100 |
O número que o portão enxerga é o de slots livres no pool regular: max_connections menos cada backend de cliente que já ocupa um, incluindo conexões ainda em autenticação (que o pg_stat_activity não mostra antes da versão 18) e conexões já saindo. Conexões existentes de papéis privilegiados não são descontadas da reserva, então um papel de monitoramento com vazamento de conexão pode comer sua própria reserva sem perceber. O parâmetro garante uma coisa só: papéis sem privilégio não tomam os últimos N slots. Nada além disso.
Configurando na prática
O contexto do parâmetro é postmaster, então ativá-lo exige reiniciar o servidor, e o momento em que se descobre a necessidade da reserva nunca é um momento em que dá para reiniciar. O planejamento precisa vir antes do incidente, não depois.
-- contexto postmaster: exige restart do servidor
ALTER SYSTEM SET reserved_connections = 10;GRANT pg_use_reserved_connections TO monitoring_role, dba_role, backup_role;A restrição de valor é estrita: superuser_reserved_connections mais reserved_connections precisa ficar estritamente menor que max_connections; se não ficar, o postmaster se recusa a subir e explica por quê. No PostgreSQL 14 e 15, que não têm o parâmetro, a reserva de superusuário continua sendo a única disponível.
Um detalhe que custa caro: o teste usa a mesma verificação de membership por herança do resto do sistema de privilégios. Um papel NOINHERIT ao qual se concedeu pg_use_reserved_connections é recusado exatamente como um papel que nunca recebeu a concessão, e SET ROLE não resolve, porque a recusa acontece antes de existir uma sessão para rodar SET ROLE. Vale checar rolinherit no papel protegido, e, desde a versão 16, a opção INHERIT na própria concessão, antes de confiar que o GRANT funciona.
O que a reserva não cobre
Walsenders, workers de autovacuum e background workers (parallel workers inclusos) usam cada um seu próprio pool de slots de processo e não entram nessa contagem nem nessa checagem. Uma réplica em streaming ou um pg_basebackup conecta mesmo quando um papel comum não consegue, porque não competem pelo mesmo pool; já o pg_dump rodando como papel comum é apenas um cliente qualquer e fica de fora se a reserva estiver fechada.
Até as versões de manutenção de fevereiro de 2025 (16.7, 17.3, 15.11 e 14.16), essa exclusão tinha uma falha: um parallel worker disparado em nome de um usuário sem privilégio, lançado enquanto o pool já estava dentro de uma faixa reservada, podia ser recusado e derrubar a query junto. Quem está atrasado em patches de manutenção carrega esse risco sem saber.
De onde veio o parâmetro
O reserved_connections nasceu de um e-mail de janeiro de 2023 de Robert Haas listando o que ainda impedia um administrador com CREATEROLE de servir como substituto utilizável do superusuário. Um dos pontos: CONNECTION LIMIT limita cada papel individualmente, e nenhuma soma de limites individuais reserva slots em conjunto para o papel que precisa entrar por último. O patch de Nathan Bossart foi aplicado quatro dias depois, o que dá a medida de como a lacuna já era antiga.
Serviços gerenciados chegaram lá primeiro: a RDS já resolvia o mesmo problema para seu quase-superusuário com rds.rds_superuser_reserved_connections (padrão 2, para rds_superuser), razão pela qual a contagem de conexões não-superusuário na RDS é max_connections menos 3 menos 2, e não só menos 3.
O que fazer com isso
Vale corrigir também uma conta usada no dimensionamento de max_connections: desde o PostgreSQL 12, walsenders saem de um pool próprio, dimensionado por max_wal_senders, e não contam contra max_connections. Quem já somou conexões de replicação nessa conta deve tirá-las do cálculo.
A recomendação prática de Pettus é direta: ligar o reserved_connections, dimensionando-o pelo mesmo punhado de slots que já se reservaria informalmente para humanos e monitoramento; conceder pg_use_reserved_connections ao papel de monitoramento, ao papel de DBA e ao papel que roda pg_dump; e nunca conceder esse privilégio ao papel da aplicação, porque uma aplicação que alcança a reserva deixa de ter reserva.
Manter o superuser_reserved_connections em 3 como última linha atrás disso, e manter o CONNECTION LIMIT por papel do lado da aplicação: os dois mecanismos trabalham de pontas opostas para a mesma garantia. Com o parâmetro zerado, como vem por padrão, ninguém além da conta de superusuário que ninguém usa em produção está protegido.
Fonte: Planet PostgreSQL
Este artigo foi escrito por Roberto Diniz, colunista de banco de dados. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
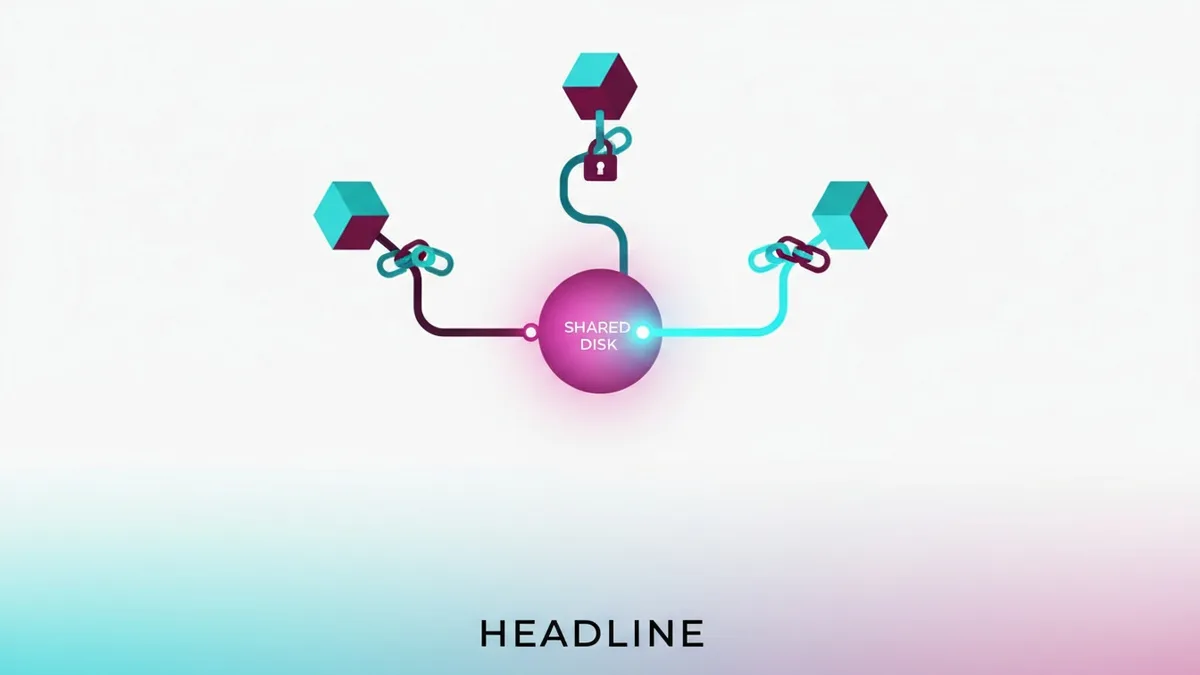
PolarFS implementa lease Disk-Paxos para evitar split-brain em disco compartilhado
O PolarFS, sistema de arquivos por trás do PolarDB, passou a gravar um protocolo Disk-Paxos no próprio bloco compartilhado para garantir que só um nó escreva por vez. A mudança, descrita em post publicado em 24 de outubro de 2026, fecha uma falha que só travava dois processos no mesmo host, não em hosts diferentes.