

Thermocline propõe tiering como alternativa a sharding em réplica MongoDB sem memória
- Leitura
- 7 min
- Tabelas
- 1
- Fontes
- 1
Prova de conceito da Percona testa uma camada de tiering na frente de um replica set MongoDB saturado, sem mudar a aplicação, e mede ganhos de até 5,2x em operações por segundo.
A réplica que não cabe mais na memória
Todo replica set do MongoDB↳MongoDB19 conteúdosMongoDB e LGPD: Quais os recursos disponíveis?Data · jul 2019Laravel & MongoDB: saiba mais sobre embedded documentsData · abr 2021LEFT JOIN no MongoDB, não é magia… É Aggregation Framework!!!Data · set 2019Ver tudo em Data → começa pequeno: o working set cabe no cache do WiredTiger, as leituras saem da memória e ninguém se preocupa com disco. O problema aparece depois, quando pedidos, eventos e logs se acumulam por anos e a coleção fica dez vezes maior que o cache.
A partir daí, toda leitura de um documento que não está em cache vira leitura de disco, e a latência passa a seguir o disco, não o índice da query. É esse o cenário descrito por Zelmar Michelini, da Percona, em post publicado em 2 de novembro no blog da empresa: num cluster de teste, um p95 de leitura de 70 ms não era sintoma de índice ruim, e sim de um disco no limite de IOPS.
A resposta padrão para esse quadro é o sharding. Funciona, mas custa caro: chave de partição difícil de mudar depois, roteadores mongos, servidores de configuração e queries que precisam incluir a shard key para continuar rápidas. Michelini parte de uma observação comum em bases que crescem por acumulação de tempo:
a maioria das leituras é sobre dados recentes, e os dados antigos atrapalham
Zelmar Michelini, autor do teste, Perconamost reads are for recent data, and old data is in the way
A pergunta que motivou o experimento: dá pra manter o replica set que já existe, pôr os dados recentes num lugar rápido na frente dele, e fazer isso sem tocar na aplicação?
Thermocline: tiering por idade, não por partição
Thermocline, nome dado ao projeto, é uma camada de tiering de armazenamento para MongoDB. O cluster que já existe vira o arquivo, exatamente como está. Um replica set novo e menor, à frente dele, guarda os documentos recentes. A aplicação deixa de falar com o cluster antigo e passa a falar com um proxy.
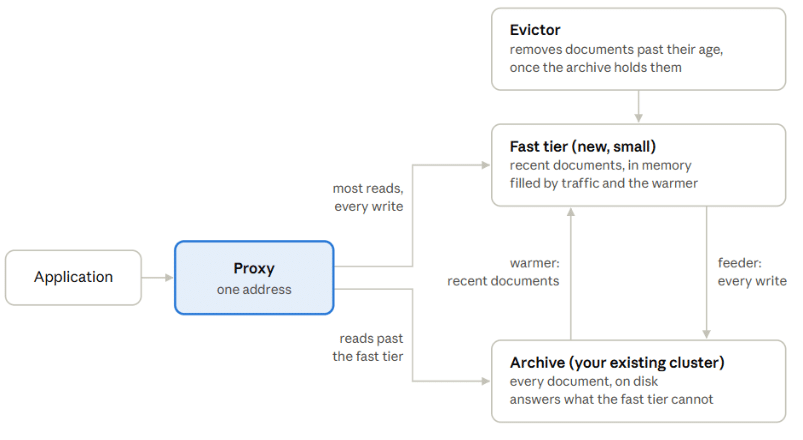
Quatro componentes mantêm as duas camadas coerentes:
a maioria das leituras é sobre dados recentes, e os dados antigos atrapalham
No original: most reads are for recent data, and old data is in the way
- Proxy: fala o protocolo wire do MongoDB; manda a query para a camada rápida quando ela consegue provar que tem a resposta inteira, e para o arquivo quando não consegue. Escritas vão para a camada rápida.
- Feeder: lê o change stream da camada rápida e espelha toda escrita no arquivo, garantindo que o arquivo sempre tenha todos os documentos.
- Evictor: remove da camada rápida os documentos mais velhos que a idade configurada para a coleção, depois de confirmar que o arquivo já os tem.
- Warmer: preenche a camada rápida a partir do arquivo com tudo que é mais novo que essa idade.
Nada é carregado manualmente: a camada rápida começa vazia e se preenche sozinha, tanto pelo warmer quanto pelos próprios documentos acessados pelo tráfego.
O teste: hardware deliberadamente limitado
Michelini rodou o teste na Hetzner Cloud, com um cluster desenhado para reproduzir o problema, não para favorecer o resultado:
- O cluster existente: replica set de três membros com 40 milhões de pedidos simulados, 47 GB de dados. Cada membro limitado a 2,5 GB de memória (cache do WiredTiger de 1 GB) e 3.000 leituras por segundo no disco de dados, um dataset cerca de 47 vezes o tamanho do cache.
- A camada rápida: segundo replica set de três membros, vazio no início.
- A carga: YCSB 0.17 com 64 threads, execuções de dez minutos, duas rodadas por lado. Cada documento carrega uma data espalhada ao longo do último ano, para que "recente" signifique algo mensurável.
Foram testados três mixes de carga, cada um estressando um padrão de leitura diferente.
Os números: ganho cresce com a concentração temporal
| Mix de carga | Perfil de leitura | Ganho de throughput observado | Latência de leitura (p95) |
|---|---|---|---|
| Online store (85% leitura, 10% update, 5% insert) | Leituras favorecem os documentos mais novos | 1,6x mais operações/s | 70,5 ms → 2,8 ms (na mesma carga fixa) |
| Read-heavy (95% leitura, 5% update) | Mesma distribuição por recência, sem concentração extra | Entre os dois extremos; a fonte não detalha o número | Não informado pela fonte |
| Read-heavy concentrado (95% leitura, 5% update, 99% da atividade nos 9% mais novos) | Quase todo o tráfego cai no recorte recente | 5,2x mais operações/s (4.447 → 23.340 op/s) | 86 ms → 6 ms |
No mix concentrado, o p99 caiu de 92 ms para 8 ms. No mix online store, testado à mesma carga fixa de 6.165 operações por segundo (o máximo que o cluster antigo sozinho suportava), o cluster sozinho entregou 6.086 operações com p95 de 70,5 ms; atrás do Thermocline, entregou 6.156 e 6.159 em duas rodadas, com p95 de 2,8 ms e 2,1 ms. O disco do arquivo, nesse teste, fez 1.838 leituras por segundo em vez de 2.704: menos pressão também em quem fica atrás.
Há ainda o cenário de partida a frio, que é o realista para quem for adotar: camada rápida vazia, preenchida só por tráfego e pelo warmer. Em 30 minutos do mix online store a todo vapor, a dupla fez em média 8.221 operações por segundo, 42% a mais que o cluster antigo sozinho com cache frio (5.803). Superou o número do cluster antigo depois de 100 segundos, com média de 6.417 operações nos primeiros cinco minutos e 9.146 nos últimos cinco, copiando 271.271 documentos do arquivo para a camada rápida nesse intervalo.
Onde o ganho não aparece
O ganho vem das leituras que a camada rápida consegue responder sozinha. Tudo o mais ainda cai no cluster existente, e é isso que define os limites do método:
- Escritas continuam chegando ao arquivo. Toda escrita é espelhada para o cluster existente, e espelhar um update significa que o arquivo precisa primeiro ler aquele documento do disco. No mix online store, as escritas rodaram na velocidade do cluster antigo, e o p99 de update ficou pior com o Thermocline (455 a 472 ms contra 104 a 189 ms sozinho). Michelini afirma estar trabalhando nessa cauda agora.
- Leituras de dados antigos continuam tão lentas quanto antes. Uma query que busca algo que a camada rápida não guarda vai parar no arquivo. Se as leituras da aplicação estão espalhadas igualmente por todo o histórico, o ganho é pequeno.
- As duas camadas precisam rodar a mesma versão do MongoDB. O arquivo responde às mesmas queries da aplicação, então precisa entendê-las; adotar isso sobre um cluster antigo implica atualizá-lo primeiro.
- É uma prova de conceito. Tem suíte de testes extensa, segundo o autor, mas nunca rodou em produção. Apontar tráfego real para o Thermocline hoje não é recomendado pelo próprio autor do projeto.
O que isso muda para quem decide entre escalar e particionar
Para quem mantém um replica set que estourou o cache, o Thermocline não é uma opção de produção pronta para usar amanhã, mas é um terceiro caminho conceitual entre comprar máquina maior e assumir o custo operacional do sharding. A diferença central: a aplicação não muda uma linha de código, porque fala sempre o protocolo wire do MongoDB, só que agora com um proxy no meio.
Isso tem implicações concretas para quem opera a stack. Qualquer decisão de adotar esse padrão, seja o Thermocline, seja um equivalente construído internamente, implica monitorar duas réplicas em vez de uma, validar que o feeder não acumula atraso no change stream sob pico de escrita, e desenhar a idade de corte por coleção de acordo com o padrão real de acesso, não com um valor arbitrário.
Vale olhar o projeto com a régua certa: é código aberto↳Open source71 conteúdosComo o Open Source Está Liberando o Poder da Automação para TodosDev (Back & Front) · out 2025Código aberto: programadores criam software da NASA sem saberDev (Back & Front) · abr 2021N8N: O que é a ferramenta open source que está revolucionando a automação em TI?Dev (Back & Front) · dez 2025Ver tudo em Dev (Back & Front) → sob licença Apache 2.0, disponível no GitHub em github.com/zelmario/thermocline, com README explicando como rodar. Michelini pede explicitamente relatos de workloads onde a abordagem falha, o que é um convite raro: testar os próprios números antes de confiar nos do autor é exatamente o que a conclusão do post recomenda.
Fonte: Percona Database Blog
Highlights
- Thermocline, prova de conceito de tiering para MongoDB, multiplica throughput por até 5,2x quando leituras concentram em dados recentes
- Latência de leitura (p95) caiu de 86 ms para 6 ms no cenário de máxima concentração temporal (99% do tráfego em 9% dos dados)
- Aplicação não muda código: proxy fala protocolo wire do MongoDB e roteia queries entre camadas rápida e arquivo
- Em partida a frio (camada rápida vazia), superou performance do cluster antigo depois de 100 segundos, atingindo 8.221 op/s médias
- Projeto aberto sob Apache 2.0 no GitHub (github.com/zelmario/thermocline); ainda é prova de conceito sem testes em produção
Este artigo foi escrito por Roberto Diniz, colunista de banco de dados. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Extensão pg_vexec afirma superar ClickHouse em benchmark feito pelo próprio criador
O desenvolvedor Igor Suhorukov embutiu execução vetorizada no PostgreSQL e, em testes conduzidos por ele mesmo, superou o ClickHouse lendo arquivos Parquet e chegou perto no motor MergeTree. Para quem decide onde rodar analytics, o resultado chama atenção, mas ainda não é motivo para trocar de banco.