Por que Postgres parece lento quando o problema é o storage, segundo benchmark apresentado na POSETTE
Benchmark apresentado por Sai Srirampur na POSETTE 2026, detalhado em post da ClickHouse, comparou o mesmo workload de 3,3 bilhões de linhas em EBS e NVMe local e encontrou diferença de até 9,24 vezes no throughput.

Quando um banco PostgreSQL↳PostgreSQL11 conteúdosPostgreSQL via SSL com GolangData · abr 20195 itens legais sobre data types do PostgreSQLData · mar 20195 serviços gratuitos na cloud para bancos de dados PostgresData · fev 2025Ver tudo em Data → começa a engasgar em produção, o instinto comum é procurar o problema na query, no índice ou na versão do banco. Um benchmark apresentado por Sai Srirampur na conferência POSETTE 2026 e detalhado em post da ClickHouse publicado em agosto de 2026 sugere outro ponto de partida: a camada de storage.
O argumento não é novo para quem já debugou banco de dados grande, mas o dado é concreto. Rodando o mesmo workload de 3,3 bilhões de linhas, a mesma configuração de PostgreSQL teve throughput de 1.734 TPS em gp3 da AWS↳AWS20 conteúdosE-mails de verificação com AWS SES + Lambda (Node.js) e Terraform: do zero ao envioDevSecOps · out 2025Codex na AWS: chegada do agente da OpenAI à nuvem da AmazonDevSecOps · abr 2026Salesforce e AWS ampliam colaboração em IA, CRM e marketplaceDevSecOps · nov 2023Ver tudo em DevSecOps → provisionado a 3.000 IOPS e 16.030 TPS em NVMe local, uma diferença de 9,24 vezes no mesmo hardware, mesma versão, mesma query.
Os cinco sintomas que parecem problemas diferentes
O talk começa listando cinco sintomas que equipes rodando Postgres em escala (centenas de gigabytes a terabytes, com concorrência real) costumam reconhecer:
- Ingestão lenta: pipelines com muito
UPDATE/UPSERTque levavam segundos passam a levar minutos conforme o volume cresce. - Latência de leitura inconsistente: a maioria das queries continua rápida, mas P95 salta de milissegundos para segundos, e dashboards começam a dar timeout.
- Autovacuum atrasado: o bloat de tabela cresce de gigabytes para terabytes porque o
VACUUMnão acompanha o ritmo deUPDATE/UPSERT. - Checkpoints mais lentos: uma operação antes invisível passa a competir por I/O e CPU com o workload do cliente, virando pico de latência recorrente.
- Lag de replicação lógica: ao replicar para Kafka ou ClickHouse, o WAL decoding fica lento e o slot de replicação cresce.
Segundo o talk, esses sintomas nem sempre têm a mesma causa raiz, mas frequentemente têm uma causa em comum que passa despercebida: a performance do storage.
Como o storage conecta os cinco sintomas
À medida que o working set ultrapassa a memória disponível para o PostgreSQL e o page cache do sistema operacional, mais leituras passam a depender de I/O físico. Em storage mais lento, o custo e a fila dessas leituras aumentam tanto a latência média quanto a de cauda (P95/P99).
O ponto central é que queries do cliente e manutenção de fundo disputam o mesmo orçamento de storage. Escritas em heap e índice, sincronização de WAL, checkpoints, VACUUM e spills de decodificação lógica competem por banda, IOPS e capacidade de fila. Quando o storage atinge um desses limites, as operações começam a atrasar umas às outras, e é assim que um gargalo de storage pode se manifestar como cinco problemas aparentemente separados.
O desenho do benchmark
Para isolar o storage como variável, o teste usou oito clusters PostgreSQL idênticos: quatro com NVMe local (instance-store) e quatro com gp3 baseline a 3.000 IOPS, todos em instâncias m6id.4xlarge (16 vCPUs, 64 GiB de RAM, 16 GiB de shared_buffers). Usar múltiplas instâncias por tipo de storage serviu para normalizar variação entre execuções.
A base era uma tabela pgbench_accounts de 482 GiB com 3,3 bilhões de linhas. Cada cluster rodou por cinco minutos o mesmo workload de UPDATE aleatório, com 64 clientes e 16 worker threads:
\set aid random(1, 3300000000)
UPDATE pgbench_accounts SET abalance = abalance + 1 WHERE aid = :aid;
A única variável entre os dois grupos era a classe de storage.
Os números: onde foram os 37 ms de latência
Além dos 9,24x de diferença em throughput, a latência mediana de transação caiu de 36,9 ms (EBS) para 4,0 ms (NVMe). Em operações de manutenção, o NVMe completou um VACUUM sobre 10 GB de bloat em 366 segundos contra 964 segundos no EBS, e drenou um backlog de replicação lógica de 10 GB em 139 segundos contra 238 segundos.
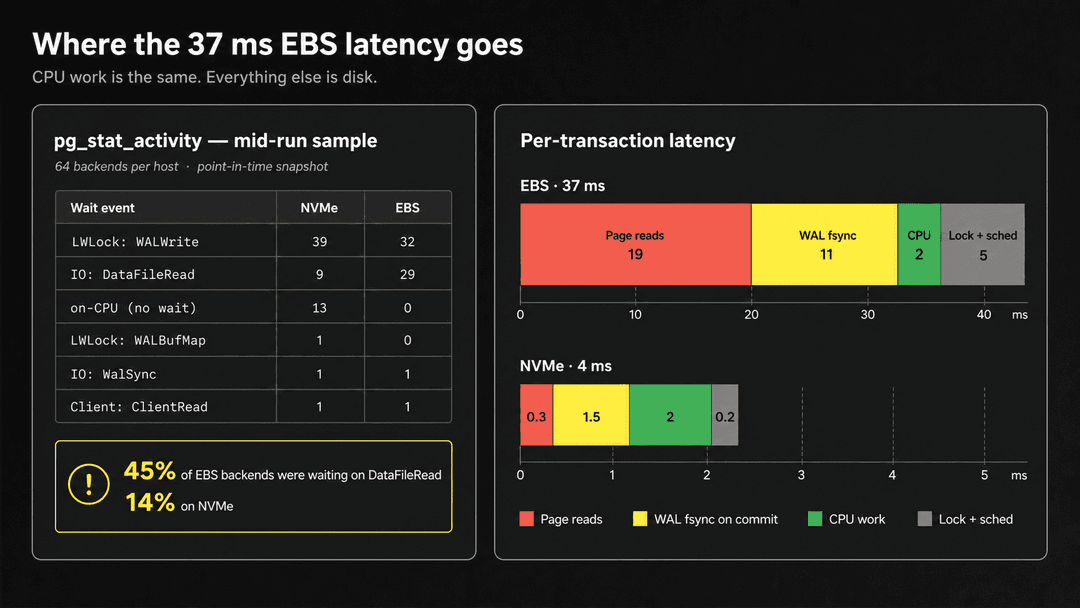
Decompondo a latência de 37 ms no EBS, o relatório atribui cerca de 19 ms a leitura de página (contra 0,3 ms no NVMe), 11 ms a fsync de WAL no commit (contra 1,5 ms), e 5 ms a overhead de lock e scheduler (contra 0,2 ms). O tempo de CPU em si foi praticamente igual nos dois cenários, cerca de 2 ms.
A maior parte da latência adicional no EBS veio de esperar pelo storage, não de o PostgreSQL fazer mais trabalho de CPU.
Most of the additional EBS latency came from waiting on storage, not from PostgreSQL doing more CPU work.Recapitulação do talk de Sai Srirampur, POSETTE 2026, via ClickHouse
Uma foto de pg_stat_activity no meio da execução reforça o padrão: das 64 conexões, 29 no EBS estavam travadas em IO:DataFileRead contra 9 no NVMe (cerca de 45% vs 14%). O perfil de CPU trouxe um dado contraintuitivo: em janela de ~240 segundos, o host NVMe acumulou 2.253 CPU-segundos (~9,4 núcleos ocupados) contra apenas 251 CPU-segundos no EBS (~1 núcleo ocupado) — ou seja, o processo no EBS passava a maior parte do tempo parado esperando disco, não computando.
A ressalva do próprio talk é importante: o resultado vale para este workload e esta configuração específica de EBS (gp3 baseline a 3.000 IOPS); um provisionamento diferente de IOPS provavelmente mudaria os números.
O que revisar antes de usar NVMe local em produção
Instance-store NVMe está atrelado ao ciclo de vida da máquina: perder o nó significa perder a cópia local dos dados, o volume não pode ser snapshotado via API do EBS, e a capacidade disponível depende do tipo de instância escolhido. A arquitetura proposta no talk resolve isso com três camadas, e é aqui que mora o trabalho real de quem for adotar o padrão:
- Replicação síncrona por quorum com dois standbys. Uma configuração como
ANY 1 (standby1, standby2)permite que a transação faça commit assim que qualquer um dos dois standbys confirmar o WAL de forma durável, em vez de esperar o mais lento dos dois. Distribuir os nós entre zonas de disponibilidade protege contra falha de uma AZ inteira. - Backups contínuos em object storage. Ferramentas open source↳Open source71 conteúdosComo o Open Source Está Liberando o Poder da Automação para TodosDev (Back & Front) · out 2025Código aberto: programadores criam software da NASA sem saberDev (Back & Front) · abr 2021N8N: O que é a ferramenta open source que está revolucionando a automação em TI?Dev (Back & Front) · dez 2025Ver tudo em Dev (Back & Front) → como o WAL-G fazem backup físico base e arquivamento contínuo de WAL fora das máquinas individuais. Com shipping de WAL de baixa latência, essa arquitetura pode mirar um RPO medido em segundos e recuperação point-in-time dentro da janela de retenção.
- Planejamento de capacidade por tipo de instância, já que o espaço de NVMe disponível varia conforme o instance type escolhido na nuvem.
Backups e WAL arquivado também precisam ficar em domínio de falha separado, com cópia regional adicional se o plano de recuperação precisar sobreviver a uma queda de região inteira. O ponto defendido no talk é que standbys resolvem failover rápido, enquanto backups protegem contra corrupção, erro de operador e falha de cluster inteiro, são mecanismos complementares, e ambos precisam de teste regular.
Quem já roda isso em produção
O talk cita exemplos públicos: Instacart já relatou usar PostgreSQL em NVMe para um workload de busca sensível a latência, e a Datadog descreveu instâncias PostgreSQL com NVMe local para cargas que exigem esse perfil. O padrão recorrente nos dois casos é storage local para performance, replicação síncrona para disponibilidade e backups/WAL armazenados de forma independente para recuperação.
O que isso muda para quem opera Postgres no Brasil
Para quem roda PostgreSQL gerenciado (RDS, Aurora, Cloud SQL) ou self-hosted em cloud brasileira, o recado prático não é "troque tudo para NVMe local amanhã". É usar os cinco sintomas do talk como checklist de diagnóstico antes de otimizar query ou trocar versão de banco: olhar pg_stat_activity em busca de waits de I/O, checar se o VACUUM está acompanhando o volume de UPDATE/UPSERT, e comparar o IOPS provisionado com o volume real de leitura que o working set exige.
Se a equipe decidir migrar para instâncias com storage local (como as m6id usadas no benchmark, ou equivalentes em outras clouds), o ganho de latência vem junto com a obrigação de montar a parte chata: replicação síncrona por quorum, backup contínuo fora do nó e teste regular de restore. É uma troca de modelo operacional, não um ajuste de configuração isolado, e o próprio talk é explícito sobre isso: a conclusão é mais estreita que o título, NVMe local reduz o custo de I/O, mas exige esse modelo operacional diferente.
Fonte: Hacker News
Este artigo foi escrito por Redação iMasters. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Nvidia negocia comprar ou ampliar investimento na Reflection AI, diz FT
Segundo o Financial Times, a Nvidia estuda desde aportar mais capital até adquirir a Reflection AI, criadora do modelo aberto Beam, voltado a código e agentes.