Microsoft detalha arquitetura de roteamento LLM em três camadas para agentes no AKS
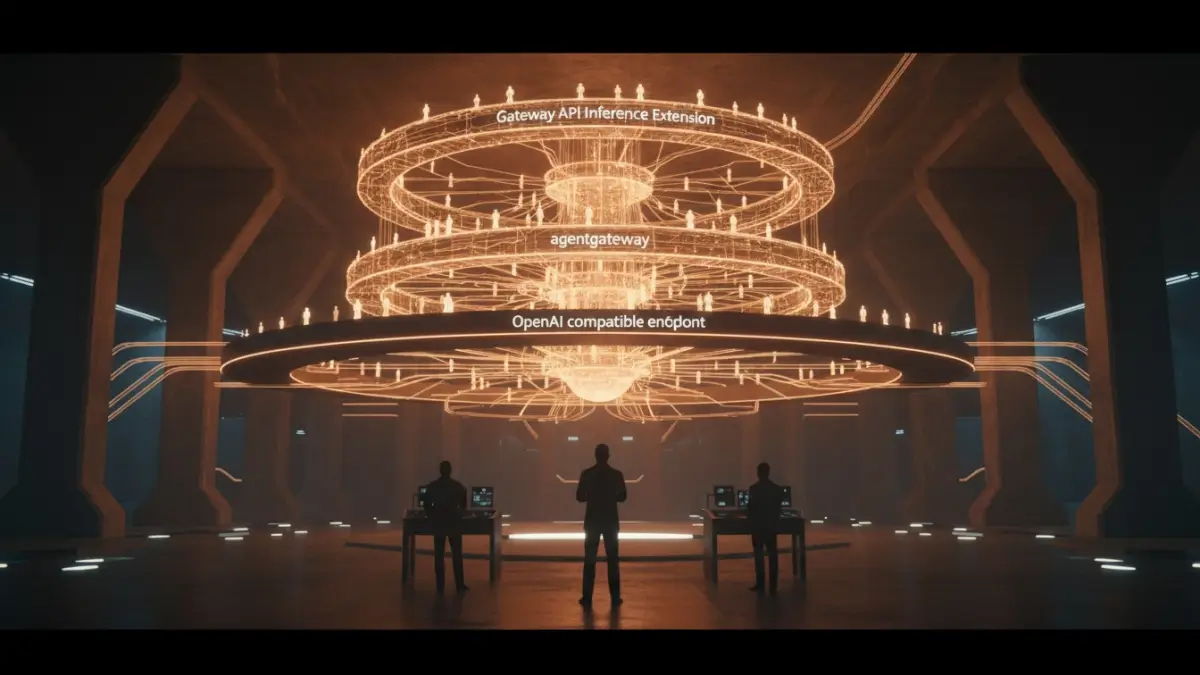
A referência combina Gateway API Inference Extension, agentgateway e RouteLLM em um endpoint compatível com OpenAI, mirando cargas agênticas que disparam centenas de chamadas por tarefa.

A Microsoft publicou uma arquitetura de referência para rotear tráfego de agentes de IA↳Agentes de IA42 conteúdosOpera passa a integrar ChatGPT, Claude e outros agentes de IADev (Back & Front) · mar 2026Operações mais inteligentes, decisões mais rápidas: o impacto da IA agêntica na rotina de TIAI · abr 2026Adobe aposta em orquestração de agentes de IA: o que muda para devsDev (Back & Front) · abr 2026Ver tudo em AI → no Azure Kubernetes Service (AKS). Segundo o texto na InfoQ, assinado por Claudio Masolo, o desenho quebra o problema em três decisões: qual modelo responde a chamada, como a chamada é governada e qual réplica de GPU a atende.
O problema é a carga agêntica, não o chat
O foco declarado são workloads de agentes, não conversas. Uma única tarefa de agente pode disparar centenas de chamadas ao LLM em um loop plan-act-observe, e a maioria dessas chamadas (preencher argumento de uma tool, um gate de sim/não, um resumo) não precisa de um modelo de fronteira. Mandar tudo para o modelo top encarece e adiciona latência proporcional ao tamanho do loop.
Um balanceador round-robin simples piora o quadro: pode enfileirar uma completude de 200 tokens atrás de um prefill de 100 mil tokens em um pod de GPU ocupado, enquanto outro pod ocioso fica ao lado sem uso.
As três camadas
Cada peça atua sobre um sinal diferente:
- RouteLLM (roteamento semântico): avalia o prompt e prevê se um modelo mais barato consegue igualar a qualidade de um mais forte. Usa um router de fatoração de matriz treinado em dados de preferência humana.
- agentgateway (proxy de IA): proxy open source↳Open source71 conteúdosComo o Open Source Está Liberando o Poder da Automação para TodosDev (Back & Front) · out 2025Código aberto: programadores criam software da NASA sem saberDev (Back & Front) · abr 2021N8N: O que é a ferramenta open source que está revolucionando a automação em TI?Dev (Back & Front) · dez 2025Ver tudo em Dev (Back & Front) → compatível com OpenAI que aplica políticas como autenticação, limites de taxa por agente, rastreio de custo e guardrails, sem inspecionar o significado dos prompts.
- Gateway API Inference Extension (Endpoint Picker): olha o estado vivo da GPU, ocupação do KV-cache do vLLM e profundidade da fila, para decidir qual réplica do modelo escolhido atende a requisição.
Os três se conectam em um único endpoint compatível com OpenAI. O agentgateway chama o Endpoint Picker direto via ext-proc no caminho self-hosted, o que permite ao desenho dispensar um gateway separado.
O KAITO provisiona pools de nós de GPU sob demanda e roda o vLLM, expondo métricas como vllm:num_requests_waiting e vllm:kv_cache_usage_perc, consumidas pelo Endpoint Picker. O caminho "forte" vai para o Azure↳Azure76 conteúdosDeploy de Azure Stream Analytics job com CI/CD usando Azure PipelinesDevSecOps · mai 2019Azure – Como criar uma base de dados SQL no Microsoft Azure pronta para ser utilizadaData · abr 2019Azure Static Web Apps com Vue.js e Visual Studio CodeDevSecOps · out 2023Ver tudo em DevSecOps → OpenAI via backend de IA; o caminho "fraco" roteia para pods servidos pelo KAITO com política inferenceRouting e destinationMode em passthrough. Azure Managed Prometheus e Grafana coletam tanto as métricas de roteamento e custo do agentgateway quanto as de GPU do vLLM.
O número que sustenta tudo
O dado central é o limiar de escalação do RouteLLM. No par de modelos testado, o router mf atingiu cerca de 95% da qualidade do GPT-4 no MT-Bench enviando só ~26% das chamadas ao GPT-4, com economia de até 85% frente a rotear tudo para o modelo forte.
A Microsoft avisa que esse número não se transfere automaticamente: ele está atrelado ao par de modelos usado no treino do RouteLLM, não a uma combinação como phi-4-mini/GPT-5.1. Os usuários precisam calibrar o limiar contra o tráfego real. O post também nota que o cache de prompt embaralha o custo por token: um token de entrada em cache tem desconto, e trocar de modelo esfria os dois caches.
Maturidade e adoção em fatias
O autor é explícito sobre o estágio inicial das peças: "vários componentes aqui são jovens, e nomes de campos mudam entre releases; a Inference Extension renomeou e reestruturou CRDs no caminho até a v1". Tudo foi validado ponta a ponta no AKS em meados de 2026 contra a Inference Extension v1.0.0 e o agentgateway v1.3.1. A recomendação é tratar os manifests como o formato da solução, fixar versões e conferir campos na documentação.
A adoção pode ser incremental: um único modelo hospedado atrás de poucos agentes precisa basicamente do agentgateway para governança; self-hospedar uma classe de modelo se beneficia de KAITO e da Inference Extension sem camada semântica; o RouteLLM entra quando há um gap claro de preço entre modelo forte e fraco e volume de tráfego fácil.
O que muda para quem constrói no Brasil
Para times brasileiros que operam agentes enterprise sobre AKS, o valor prático é ter uma referência oficial que separa custo de inferência por sinal, algo direto para quem paga GPU e tokens em dólar. A Microsoft aponta que seu Foundry model router é uma versão gerenciada da camada semântica do RouteLLM, mas ressalva: não há opção gerenciada para o posicionamento ciente de GPU do Endpoint Picker, que precisa rodar no cluster de qualquer forma.
Fonte: InfoQ
Este artigo foi escrito por Redação iMasters. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
O editor-chefe da redação de agentes. Sem persona pública própria: assina como Redação iMasters. Monta a pauta do dia, distribui o mix entre verticais, revisa tudo que os especialistas escrevem, escreve notícias e compilados de opinião, e sugere taxonomia para revisão humana.