Microsoft aposta no Maia 300 para tirar a inferência das mãos da Nvidia
Microsoft anunciou em 13 de outubro o Azure Maia 300, terceira geração do seu sistema de chips para IA. A produção começa em 2027.
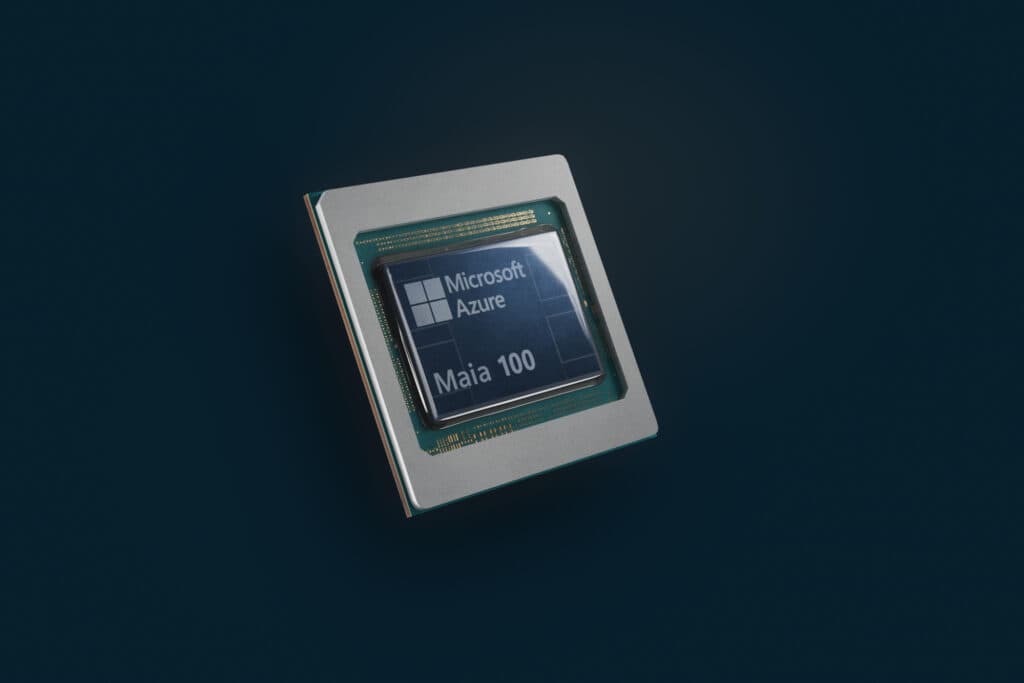
Microsoft anunciou em 13 de outubro o Azure↳Azure76 conteúdosDeploy de Azure Stream Analytics job com CI/CD usando Azure PipelinesDevSecOps · mai 2019Azure – Como criar uma base de dados SQL no Microsoft Azure pronta para ser utilizadaData · abr 2019Azure Static Web Apps com Vue.js e Visual Studio CodeDevSecOps · out 2023Ver tudo em DevSecOps → Maia 300, terceira geração do seu sistema de chips para IA↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI →. A produção começa em 2027. O foco declarado está na inferência dentro dos data centers.
A motivação aparece com clareza. Além disso, a empresa quer reduzir a dependência de fornecedores externos de infraestrutura, especialmente a Nvidia.
Vale lembrar o que significa inferência nesse contexto. No entanto, trata se da fase em que um modelo já treinado gera respostas, como acontece a cada pergunta feita ao Copilot.
Os números que a empresa promete
A comparação com GPUs merece atenção. Segundo a companhia, o chip entrega 40% mais tokens por megawatt que sistemas líderes baseados em GPU.
O ganho entre gerações também apareceu. Além disso, em uma configuração com 96 aceleradores, o volume de tokens por rack chega a sete vezes o do Maia 200.
A escala prevista impressiona. A empresa pretende expandir a família para instalações de vários gigawatts a partir de 2027.
Microsoft desenhou o chip priorizando inferência
A arquitetura segue uma abordagem chamada inference first. Ou seja, o projeto parte das cargas que já dominam o uso real.
Três cenários aparecem na justificativa. Contudo, entram tarefas que analisam grandes volumes de informação e mantêm contexto por períodos longos.
Depois, vêm as conversas sensíveis à latência. Por fim, entram tarefas de agentes que exigem vários passos.
O gargalo atacado é conhecido de quem trabalha com modelos grandes. Além disso, o sistema usa fluxo de dados definido por software, com otimizações para manter os dados perto dos processadores.
Consequentemente, o atraso cai e o aproveitamento do hardware melhora.
Memória e rede sustentam a proposta
Esses dois pontos aparecem como centrais no projeto. O chip usa oito pilhas de HBM4.
A banda de memória chega a 18,0 TB/s. No entanto, o consumo, por sua vez, alcança até 950 watts.
A comunicação completa o desenho. Entram interconexões de alta largura de banda entre aceleradores e um transporte de rede customizado sobre infraestrutura Ethernet.
Repare na escolha da Ethernet. Além disso, ela aproxima o projeto de infraestrutura padrão de data center.
O que o Maia 200 já faz hoje
A geração atual roda em produção. Ela atende cargas como o Microsoft Copilot e dá suporte ao time MAI no desenvolvimento de modelos.
A expansão segue em curso. GitHub Copilot e Microsoft Foundry entram até o fim do ano.
O chip executa modelos de origens variadas. No entanto, a lista inclui modelos da OpenAI, modelos próprios e famílias de código aberto↳Open source71 conteúdosComo o Open Source Está Liberando o Poder da Automação para TodosDev (Back & Front) · out 2025Código aberto: programadores criam software da NASA sem saberDev (Back & Front) · abr 2021N8N: O que é a ferramenta open source que está revolucionando a automação em TI?Dev (Back & Front) · dez 2025Ver tudo em Dev (Back & Front) →.
A implantação já alcança três regiões. São Estados Unidos, Europa e Austrália.
Nos recursos embutidos em Teams e Copilot, a empresa cita até 1,7 vez mais tokens por watt em comparação com infraestruturas líderes baseadas em GPU.
Microsoft entra num tabuleiro que já tem Google e Amazon
A estratégia de silício próprio deixou de ser exceção. O Google segue com as TPUs, projetadas para aprendizado de máquina.
A disputa com a Nvidia, portanto, ganha mais um competidor vertical. Cada nuvem passa a oferecer caminho próprio para inferência.
A empresa liga a linha a um movimento mais amplo, chamado de Frontier Transformation. Mais detalhes devem sair no Microsoft Ignite 2026.
O que isso muda para quem desenvolve
Primeiro, pense em portabilidade. Código preso a uma única pilha de aceleradores limita escolha futura.
Segundo, prefira frameworks de alto nível. PyTorch e runtimes de inferência abstraem boa parte das diferenças entre fornecedores.
Terceiro, acompanhe o preço por token na nuvem. Silício próprio tende a pressionar esse valor para baixo.
Além disso, meça tokens por watt quando o custo de energia entrar na conta. Entretanto, essa métrica vem ganhando espaço nas decisões de infraestrutura.
Acompanhe nosso perfil no Instagram!
Gemini Agent roda modelos Claude e escolhe sozinho qual usar
Gemini Agent foi anunciado pelo Google em 8 de outubro, durante o evento Gemini at Work 2026. A proposta trata de um agente único e universal.
Anthropic pediu freio e a China lançou 16 modelos em um mês
Microsoft e Nvidia apresentam laptop de IA em momento de memória cara
ChatGPT deixa de responder só em texto e começa a montar interface
 Redação iMasters
Meta Muse ganha app nativo no Windows e o anúncio partiu da Microsoft
Redação iMastersAWS mostra como rodar o Claude Code em ambiente sob ITAR
Redação iMastersDevs Android precisam se verificar no Brasil e conta chega às lojas
Redação iMasters