
- Leitura
- 5 min
- Fontes
- 1
O AQuA roda ao lado do agente em produção, agrupa falhas que passam despercebidas pelo monitoramento tradicional e aponta a linha de código ou prompt provável culpado.
Em 13 de novembro de 2026, o Google abriu o código de uma implementação de referência chamada AQuA (Ambient Quality Agent), segundo reportagem do InfoQ. A ferramenta analisa sessões de agentes de IA↳Agentes de IA42 conteúdosOpera passa a integrar ChatGPT, Claude e outros agentes de IADev (Back & Front) · mar 2026Operações mais inteligentes, decisões mais rápidas: o impacto da IA agêntica na rotina de TIAI · abr 2026Adobe aposta em orquestração de agentes de IA: o que muda para devsDev (Back & Front) · abr 2026Ver tudo em AI → já em produção, verifica padrões de falha recorrentes e investiga a causa raiz comparando o comportamento observado com a versão do código que estava implantada no momento do erro.
O alvo são as chamadas regressões de qualidade silenciosas: um agente que ignora uma preferência do usuário ou pula uma chamada de ferramenta obrigatória, mas ainda assim devolve uma resposta que parece bem-sucedida. Esse tipo de falha não aparece em métricas de infraestrutura como latência ou taxa de erro, porque tecnicamente o pipeline rodou do início ao fim sem exceção.
O problema que o monitoramento tradicional não vê
APM e logging convencionais foram desenhados para detectar quebra: timeout, exceção, status 500. Um agente que entrega uma resposta formatada corretamente, mas que ignorou a dieta vegana do usuário ou pulou a verificação de assento disponível, não gera nenhum sinal de erro nesses sistemas.
Em resumo: o AQuA nasce para preencher essa lacuna, atuando como uma camada separada de diagnóstico de qualidade comportamental, não de saúde de infraestrutura.
Como funciona: um sidecar fora do caminho de produção
O AQuA roda ao lado do agente no Google Cloud↳Google Cloud13 conteúdosPrograma da Google Cloud no Brasil projeta formar de forma gratuita 30 mil universitáriosDev (Back & Front) · mar 2026Google Cloud OnBoard capacita estudantes e desenvolvedores de TIGestão Dev & TI · mai 2019Desenvolvedores poderão participar de treinamento gratuito do Google CloudGestão Dev & TI · mai 2019Ver tudo em DevSecOps →, fora do caminho da requisição, lendo telemetria de Cloud Trace, Cloud Logging ou BigQuery. Ele amostra até 1.000 sessões recentes por execução e processa esse lote em cinco estágios:
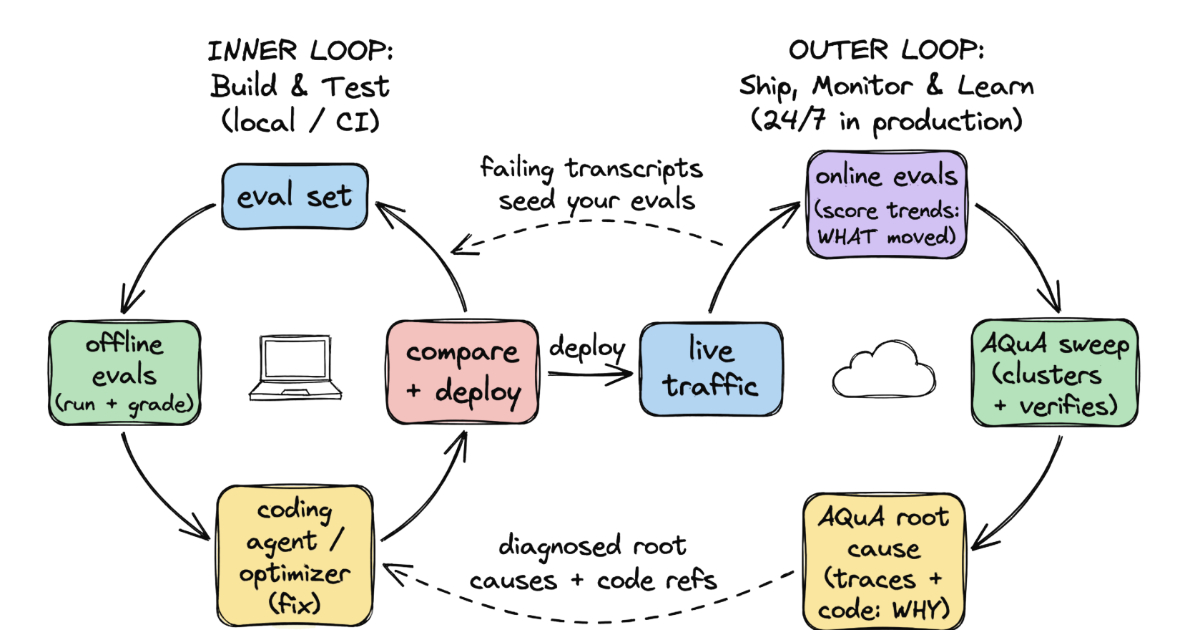
- Amostragem das sessões recentes
- Revisão de cada sessão em busca de comportamentos problemáticos
- Clusterização dos achados em padrões recorrentes
- Verificação dos clusters candidatos contra transcrições completas
- Rastreamento contínuo dos problemas identificados
Times podem configurar critérios de qualidade específicos do domínio num arquivo goal.md e adicionar métricas determinísticas próprias. A execução pode ser agendada, disparada após um deploy ou feita sob demanda.
Causa raiz: comparando com o snapshot de código implantado
Para a análise de causa raiz, o AQuA compara as sessões com falha contra um snapshot imutável do código capturado no momento do deploy. O agente de diagnóstico identifica o código ou as instruções relevantes, cita o arquivo e as linhas específicas e propõe mudanças quando a causa está no repositório.
Ele também consegue atribuir falhas a dependências externas, handoffs entre ferramentas ou dados recuperados de fontes externas. O AQuA não aplica correções nem abre pull requests automaticamente: a decisão de corrigir continua sendo humana.
Um achado se sustenta pelas suas citações, não por uma pontuação de confiança autoatribuída.
No original: An insight is its citations, not a self-reported confidence score.
 Fonte: InfoQ
O teste de referência: um agente de viagens que esquecia a dieta vegana
O Google avaliou 32 sessões de uma aplicação multi-agente de viagens, identificando 42 achados agrupados em nove clusters candidatos. O verificador rejeitou três clusters sem sustentação, checando até três transcrições completas por cluster candidato, restando seis problemas confirmados.
Dois desses problemas eram recorrentes: o agente pulava a verificação de disponibilidade de assento e perdia a preferência vegana do viajante durante a delegação entre agentes. Depois que os desenvolvedores ajustaram os prompts e reexecutaram as sessões, os casos de bypass na seleção de assento caíram de 15 para duas sessões, as omissões de preferência dietética foram de sete para zero, e as sessões que passaram em todas as verificações subiram de cinco para 13.
É importante marcar o limite desse resultado: os números vieram de um replay controlado, não de tráfego real de produção.
"Citação, não autoavaliação de confiança"
O post do Google sobre o AQuA destaca por que cada achado vem amarrado a evidências rastreáveis em vez de uma nota de confiança gerada pelo próprio modelo:
Um achado se sustenta pelas suas citações, não por uma pontuação de confiança autoatribuída.
Na prática, cada achado fica vinculado aos traces que o sustentam, e toda causa raiz proposta precisa referenciar linhas válidas do snapshot implantado. Os achados são rastreados com status NEW, RECURRING ou RESOLVED (este último, automaticamente, depois de 14 dias sem recorrência).
Limitações que o próprio Google reconhece
A amostragem de até 1.000 sessões pode deixar passar falhas raras, e o replay nem sempre reproduz fielmente estado externo (como disponibilidade real de um assento num sistema de terceiros no momento original). O Google lista essas duas restrições como conhecidas na documentação do projeto.
A orquestração de agentes definitivamente precisa de um diagnóstico contínuo melhor para pegar esses loops cedo.
No original: Agent orchestration definitely needs better continuous diagnosis to catch these loops early.
Reagindo ao lançamento no LinkedIn, Dmytro Aprelenko, gerente de engenharia na Redcore, resumiu a necessidade que a ferramenta tenta atacar:
A orquestração de agentes definitivamente precisa de um diagnóstico contínuo melhor para pegar esses loops cedo.
Dmytro Aprelenko, engineering manager na RedcoreAgent orchestration definitely needs better continuous diagnosis to catch these loops early.
Onde o AQuA se encaixa no ecossistema de observabilidade de agentes
O AQuA não é a única peça nesse espaço. O próprio serviço de avaliação do Agent Platform do Google cobre teste de regressão e monitoramento contínuo de qualidade em produção, enquanto o Arize Phoenix, projeto open source↳Open source71 conteúdosComo o Open Source Está Liberando o Poder da Automação para TodosDev (Back & Front) · out 2025Código aberto: programadores criam software da NASA sem saberDev (Back & Front) · abr 2021N8N: O que é a ferramenta open source que está revolucionando a automação em TI?Dev (Back & Front) · dez 2025Ver tudo em Dev (Back & Front) → independente, oferece rastreamento e avaliação de modelos e agentes.
A diferença de foco do AQuA é específica: agrupar falhas de produção em padrões verificados e ligar cada achado confirmado a uma linha de código do snapshot implantado, com citações auditáveis em vez de score de confiança.
O que muda para quem está rodando agentes em produção
Para times que já usam Google Cloud e têm agentes expostos a usuários reais, o AQuA chega como implementação de referência, não como produto gerenciado pronto para apontar e rodar. Isso significa trabalho de integração: escrever o goal.md com os critérios de qualidade do domínio, conectar as fontes de telemetria corretas e validar manualmente os primeiros clusters antes de confiar no rastreamento automático.
O ponto mais prático é que ele não substitui revisão humana: mesmo quando a causa raiz aponta para uma linha específica do código ou do prompt, a correção e o deploy continuam sendo decisão de quem mantém o agente. Para equipes brasileiras que colocaram agentes de IA em produção sem essa camada de diagnóstico comportamental, o AQuA é um caminho concreto para parar de descobrir falhas de preferência e de tool-calling só quando o usuário reclama.
Fonte: InfoQ
Highlights
- Google abriu código do AQuA em 13 de novembro de 2026 para detectar falhas silenciosas em agentes de IA em produção
- AQuA agrupa falhas em padrões verificados e rastreia cada achado a linha específica do código ou prompt implantado
- Teste em agente de viagens reduziu omissões de preferência vegana de sete para zero sessões após correção de prompts
- Ferramenta roda fora do caminho de requisição, amostrando até 1.000 sessões recentes em cinco estágios de processamento
- AQuA não aplica correções automaticamente; vincula cada achado a evidências rastreáveis, não a scores de confiança do modelo
Este artigo foi escrito por Redação iMasters. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Pesquisador encontra bypass no aviso de leitura do clipboard do Android, e o Google não vai corrigir
Pesquisador encontra bypass no aviso de leitura do clipboard do Android, e o Google não vai corrigir