
- Leitura
- 7 min
- Tabelas
- 1
- Código
- 1
- Fontes
- 1
Relatório de novembro da Vercel sobre o AI Gateway mostra times usando modelos de decisão, mais baratos e rápidos, para classificar e rotear em vez de gerar texto, enquanto Anthropic lidera a escolha dos times novos.
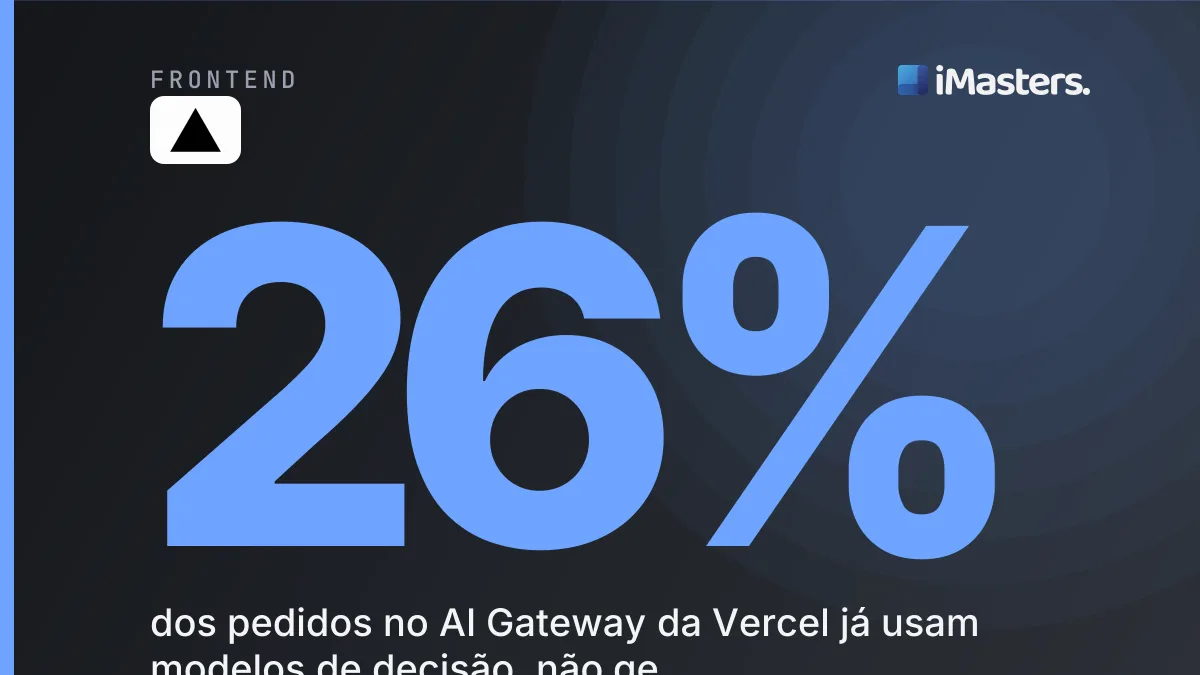
O AI↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI → Gateway Production Index de novembro de 2026, publicado pela Vercel, trouxe um dado que passou batido no meio do ruído sobre qual modelo de linguagem é o mais forte do mês: modelos de decisão já respondem por 26% de todos os pedidos que passam pelo gateway, mas consomem apenas 0,53% do gasto total. Em agosto esse número era zero. A métrica vem de um produto que roteia mais de 100 trilhões de tokens por mês entre aplicações e provedores como OpenAI, Anthropic e Google, o que dá à Vercel uma visão de tráfego real de produção, não de benchmark.
O que é um decision model e por que ele existe
Um modelo de decisão não escreve texto. Ele classifica, pontua ou escolhe entre opções, e isso muda tudo no custo: segundo a Vercel, um decision model custa cerca de 1/70 do preço por requisição de um modelo de linguagem comum. A categoria estreou no AI Gateway em meados de setembro de 2026 e hoje soma 15 modelos de oito fornecedores diferentes.
A lógica é simples e já é familiar pra quem construiu pipeline de ML antes da era dos LLMs: nem toda decisão em um app precisa de um modelo que entende contexto profundo e gera prosa. Moderação de conteúdo, roteamento de intenção, scoring de prioridade, escolha entre caminhos de um agente: isso é classificação, não geração. Usar um modelo de 70x o custo pra resolver isso sempre foi desperdício, só que até pouco tempo a alternativa era construir um classificador próprio do zero.
Quem está ganhando esse mercado (e o que isso ensina sobre preço)
O dado mais chamativo do relatório: quase todo o volume de decision models foi pro Jev, da TypeSafe AI, que sozinho recebeu quase quatro vezes mais pedidos do que todos os modelos da Anthropic somados. Mesmo assim, para cada US$ 1 gasto em Jev, os times gastaram US$ 64 em modelos Anthropic.
Isso expõe uma divisão de trabalho que já está acontecendo na prática, mesmo sem nenhum arquiteto ter desenhado isso de propósito:
- Tarefas de alto volume e baixa complexidade (classificar, rotear, decidir sim/não) migram pra modelos de decisão baratíssimos.
- Tarefas que exigem raciocínio, geração ou nuance continuam em modelos de linguagem completos, caros por token mas usados com muito mais parcimônia.
Para quem projeta a camada de IA de um produto, isso sugere um padrão concreto: separar a chamada de "julgamento rápido" da chamada de "geração", em vez de mandar tudo pro mesmo modelo caro só porque é o que já está configurado. Um pipeline hipotético de moderação, por exemplo, ficaria assim:
// esboço ilustrativo do padrão, não um trecho testado
const decisao = await gateway.run({
  model: "decision/jev", // barato, resposta curta
  input: textoDoUsuario,
});

if (decisao.classe === "precisa_revisao") {
  const resposta = await gateway.run({
    model: "anthropic/sonnet-5.5", // caro, só quando necessário
    input: textoDoUsuario,
  });
}
O ganho não é só de custo. Respostas de decision model são curtas por natureza, então a latência percebida cai, o que importa bastante pra qualquer fluxo de UI que dependa de uma resposta de IA antes de renderizar algo pro usuário.
A adoção também segue o tamanho do time, não moda: apenas pouco mais de 1 em 5 times com menos de 10 milhões de tokens/mês usou um decision model em outubro, contra quase metade na faixa de 100 milhões a 1 bilhão, e 7 em cada 10 entre os times que processam mais de 10 bilhões de tokens/mês. Quem roda pouco volume não sente a dor de custo que justifica a complexidade extra de manter dois modelos na mesma rota.
Modelos de IA agora têm uma meia-vida de cerca de seis semanas.
No original: AI models now have a half-life of about six weeks.
Anthropic ganha dois a cada três times novos
O outro eixo do relatório é a disputa entre OpenAI e Anthropic, e aqui os números contam uma história que não é a manchete de "quem é o líder":
| Métrica | Dezembro/2025 | Outubro/2026 |
|---|---|---|
| Times pagos usando OpenAI | 70% | 55% |
| Times pagos usando Anthropic | 48% | 54% |
| Share de gasto da OpenAI | ~9% | ~15% |
| Share de gasto da Anthropic | ~64% | ~32% |
As duas empresas hoje alcançam fatias quase iguais da base de times pagos, mas a Anthropic foi a primeira escolha de quase o dobro dos times novos em outubro, e tem sido a escolha mais comum em 9 dos últimos 11 meses (as exceções foram dezembro de 2025 e agosto de 2026, quando a OpenAI liderou). Entre os times que já pagavam em dezembro, a fatia usando Anthropic subiu de cerca de metade para dois terços.
Ao mesmo tempo, a fatia de gasto da OpenAI no gateway subiu quase dois terços desde dezembro, enquanto a da Anthropic caiu praticamente pela metade. Dito de outro modo: a Anthropic está ganhando a corrida por quem experimenta primeiro, mas a OpenAI está recuperando espaço em quanto cada time efetivamente gasta depois de decidir. Entre o 1% de times com maior gasto, mais de 90% já usam as duas, o que empurra a disputa real pra outro terreno: não é mais "qual lab escolher", é "quanto do orçamento cada um pega".
No ranking de modelos individuais por alcance entre times pagos, quatro dos seis mais usados são da Anthropic: Sonnet 5.5 (26% dos times), Haiku 5.5 (22%), Haiku 4.5 (20%) e Opus 5.5 (18%), que também foi o modelo líder em gasto total no seu primeiro mês completo, tomando cerca de 1 em cada 7 dólares do gateway. Os outros dois do top 6 são o Jev (28%, decision model) e o GPT-6 Luna (19%), da OpenAI.
Modelos têm meia-vida de seis semanas: o que isso quebra em produção
O dado mais incômodo do relatório pra quem mantém código em produção não é sobre qual modelo vence, e sim sobre quanto tempo qualquer modelo continua sendo "o" modelo. Mais da metade dos pedidos de linguagem em outubro foi pra modelos lançados há menos de 60 dias, contra menos de 3 em cada 10 antes de setembro. Dentro de cada família, uma nova versão sai a cada 61 dias (mediana), e um modelo típico atinge o pico de uso dentro de um mês do lançamento. Quatro semanas depois desse pico, 3 em cada 4 times que o usavam já migraram pra outra coisa.
A Vercel resume isso com uma frase direta:
Modelos de IA agora têm uma meia-vida de cerca de seis semanas.
Eric Dodds, VercelAI models now have a half-life of about six weeks.
Pra quem escreve o código que chama esses modelos, isso é argumento concreto contra hardcode de nome de modelo espalhado pela base. Entre times rodando pelo menos 10 milhões de tokens/mês, metade trocou o modelo mais usado em outubro, 4 em cada 5 dessas trocas foram pra uma versão mais recente, e 6 em cada 10 mudaram de fornecedor. Um projeto que amarra model: "gpt-6-luna" direto na chamada de API em dezenas de arquivos paga esse preço de refatoração a cada seis semanas; um projeto com a escolha de modelo centralizada em uma camada de configuração ou no próprio roteamento do gateway troca isso com um deploy.
Vale notar que modelo antigo não desaparece: 7 em cada 10 times com volume relevante ainda tinham pelo menos um modelo com mais de dez meses rodando em outubro, só que consumindo menos de 3% dos tokens do time, tipicamente em alguma rota legada que ninguém priorizou migrar.
Voz cresceu mais rápido que o resto, mas por outro motivo
O relatório também mostra adoção de modelos de voz saltando de 4% dos times pagos em julho pra 11% em outubro, um crescimento de 161%. A maior parte dos times usa voz como uma nova porta de entrada pro mesmo app ou agente que já existia, plugando um modelo de fala no início e no fim do fluxo, com o modelo de linguagem preferido do time continuando no meio.
Em julho, cerca de 1 em 4 times de voz usava um modelo "tudo em um" (fala-texto-fala integrado) e 1 em 6 montava o pipeline em peças separadas; em outubro essa proporção se inverteu, sinal de que os modelos integrados amadureceram o suficiente pra virar a opção padrão.
Quando um decision model não resolve
A mesma lógica que faz um decision model brilhante pra moderação ou roteamento o torna inútil pra tarefas que exigem geração, raciocínio em várias etapas ou produção de texto livre: ele não escreve, só escolhe entre opções que já existem. Trocar um LLM por um decision model numa tarefa que precisa de nuance argumentativa, resumo criativo ou geração de código não economiza nada, porque a tarefa simplesmente não é classificação disfarçada. O ganho de custo e latência só aparece quando a decisão em si já é binária ou de poucas categorias, e aí vale medir antes de migrar, não assumir que "mais barato" é sinônimo de "serve aqui".
Fonte: Vercel Changelog
Highlights
- Decision models respondem por 26% dos pedidos do AI Gateway, mas custam apenas 0,53% do gasto total
- Jev, da TypeSafe AI, recebeu quase 4 vezes mais pedidos que todos os modelos Anthropic somados
- Anthropic vence 2 a cada 3 times novos em outubro; OpenAI recupera espaço em fatia de gasto
- Modelos duram meia-vida de 6 semanas; mais da metade das requisições de outubro foram para modelos com menos de 60 dias
- Adoção de voz cresceu 161% entre julho e outubro; times já montam pipelines separados em vez de tudo-em-um
Este artigo foi escrito por Carina Ferreira, colunista de front-end. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
DeepSeek V4.1 Flash Ultrafast estreia na Vercel AI Gateway com 1.000 tokens por segundo
A versão Ultrafast do DeepSeek V4.1 Flash, servida pela Fireworks dentro do AI Gateway da Vercel, promete mais de 1.000 tokens por segundo e 1 milhão de tokens de contexto, sem markup sobre o preço do provedor.