O padrão por trás dos avanços de IA em matemática explica onde ela falha em produção


Modelos resolveram problemas matemáticos abertos há décadas usando busca em profundidade e verificação automática. O mesmo padrão explica por que agentes de código funcionam bem com testes, mas travam quando não há critério claro de certo e errado.
Em maio de 2026, um modelo interno da OpenAI encontrou um contraexemplo para a conjectura da distância unitária de Erdős, um problema aberto desde 1946 que resistiu a décadas de tentativas de prova. Em junho, a empresa publicou uma prova do problema da cobertura dupla de ciclos (CDC) e, em julho, soluções para outros dez problemas em aberto. Em setembro, publicou uma prova para Navier-Stokes. No mesmo período, a Anthropic formalizou o Último Teorema de Fermat e avançou limites sobre a hipótese de Riemann.
Uma análise publicada no Latent Space por Ankit Maloo tenta responder a uma pergunta mais útil que "os modelos estão ficando bons em matemática": existe um padrão que permite prever QUE tipo de problema um modelo vai resolver a seguir? A resposta interessa a quem constrói com IA↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI → porque o mesmo padrão aparece nos agentes de código, nos pipelines de RAG e em qualquer sistema que delega decisões a um modelo. Entender onde ele funciona é entender onde ele vai travar no seu produto.
O modelo de complexidade: hints e trabalho
O matemático WT Gowers, comentando a prova do contraexemplo de distância unitária, propõe um jeito simples de medir a dificuldade de um problema: a sequência mínima de insights (ele chama de hints) que um especialista precisaria para reconstruir a solução. Sua fórmula é 2^k + t, onde k é o número de insights necessários e t é o trabalho entre cada um deles.
A ideia central: resolver um problema não é um lampejo único, é uma sequência de "insight, trabalho, insight, trabalho, solução". Um especialista precisa de menos insights que um iniciante porque já carrega mais contexto de fundo. O problema é que essa métrica só funciona depois que a solução existe: você não consegue olhar para um problema novo e prever quantos insights ele vai exigir antes de tentar.
Humanos buscam em largura, modelos buscam em profundidade
Aqui está a diferença que importa para quem constrói produto. Um pesquisador humano explora várias direções superficialmente, abandona a maioria cedo e só se compromete com uma depois de ter sinais de que vale a pena, porque desenvolver uma ideia até o fim pode levar meses. É uma busca em largura, limitada pelo custo de errar.
Um LLM faz o oposto: dado um prompt, ele persegue uma linha de raciocínio até o fim, de forma gananciosa (greedy), produzindo algo que parece uma prova, correta ou não. Rodar múltiplos agentes em paralelo multiplica essa busca em profundidade: dez agentes produzem dez tentativas completas, cada uma levada até travar ou até parecer certa.
Isso seria um desperdício de compute, segundo o artigo, se não existisse um verificador automático capaz de podar as tentativas erradas depois de prontas. Com um verificador rápido, faz sentido gastar compute em ideias incertas: em minutos você sabe se uma direção funcionou ou não. A limitação é que o verificador só julga argumentos terminados, nunca uma ideia pela metade.
O harness que todo dev de agentes já reconhece
A estrutura usada para gerar essas provas tem três papéis que qualquer um que já montou um pipeline de agentes vai reconhecer:
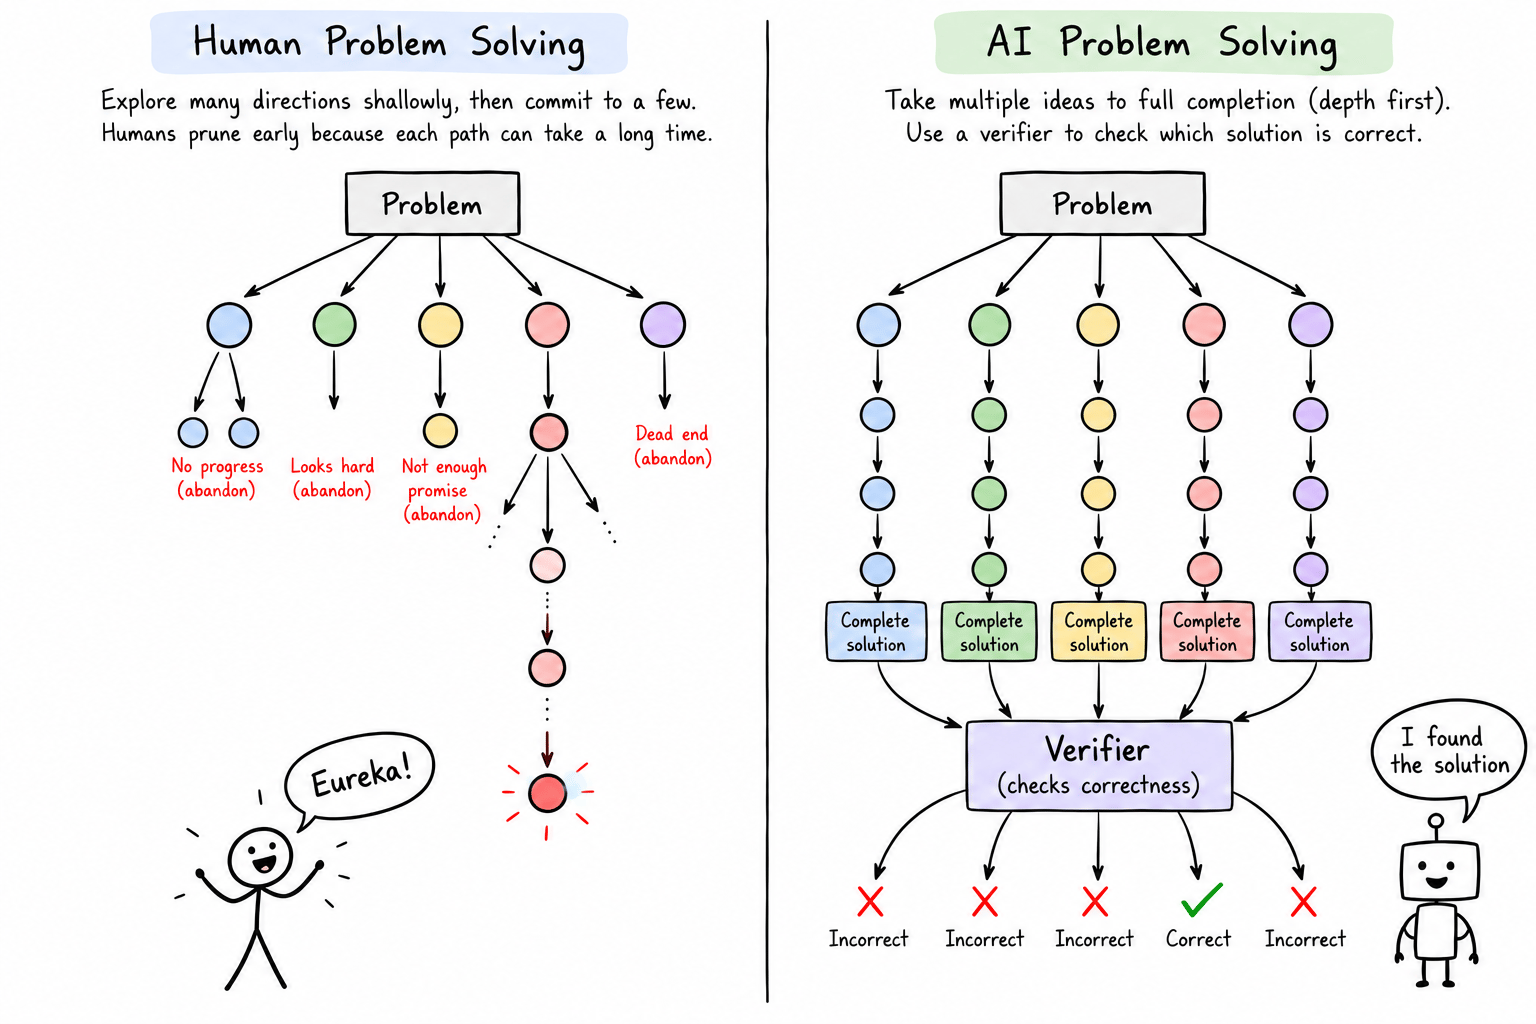
- Drafter: escreve os prompts para o modelo solver, incorporando o que já falhou em rodadas anteriores (hints negativos).
- Solver: gera uma ou várias soluções candidatas, podendo rodar subagentes em paralelo.
- Verifier: checa se o argumento é válido e resolve o problema pedido.
O prompt usado pela OpenAI no problema CDC ilustra isso na prática: ele instrui o modelo a assumir que existe uma prova afirmativa completa (para não tratar o status "aberto" do problema, aprendido no pré-treino, como motivo para desistir), lista explicitamente uma série de substitutos inválidos para a prova real e cataloga modos de falha que agentes adversariais devem checar em toda tentativa. Cada linha desse prompt é, na prática, um caminho que já falhou antes, transformado em instrução.
Esse é exatamente o padrão por trás de agentes de código que funcionam bem: um loop onde o solver escreve código, um verifier roda npm test ou o compilador, e o resultado (passou ou falhou, e por quê) volta como contexto para a próxima tentativa, em vez de ser descartado.
while not verified:
 solução = solver(prompt, hints_negativos)
 resultado = verifier(solução) # compilador, testes, type checker
 if resultado.falhou:
 hints_negativos.append(resultado.motivo_da_falha)
O fator de ramificação decide onde a IA funciona
Gowers aponta que sua fórmula ignora uma variável crítica: quantos caminhos plausíveis existem em cada passo da busca, o que o artigo chama de fator de ramificação (b). Com b hints plausíveis em cada passo e k passos no total, o espaço de busca cresce como b elevado a k. Modelos têm que perseguir quase todo caminho plausível em cada etapa intermediária, só que conseguem fazer isso rápido; humanos usam julgamento para manter b pequeno, descartando a maioria dos ramos de cara.
Isso explica por que cibersegurança↳Segurança171 conteúdosCibersegurança no Brasil: 6 passos para sair da estagnaçãoDevSecOps · jul 2025O papel do CISO para transformar a cibersegurança em uma alavanca de reputação para as empresasDevSecOps · mar 2024Itaipu Parquetec e Exército Brasileiro realizam exercício de cibersegurança em BrasíliaDev (Back & Front) · set 2025Ver tudo em DevSecOps →, segundo o artigo, foi uma das primeiras áreas onde agentes de IA se destacaram: o fator de ramificação nos passos intermediários é baixo, algo como um a dois caminhos plausíveis por etapa, mesmo que o conhecimento exigido seja alto. O formato da solução já é conhecido de antemão; o que falta é execução.
| Tipo de tarefa | Fator de ramificação | Verificador disponível | IA tende a ir bem? |
|---|---|---|---|
| Gerar testes, migrar boilerplate | Baixo | Sim (compilador, testes) | Sim |
| Corrigir vulnerabilidade conhecida | Baixo a médio | Sim (scanner, exploit) | Sim |
| Decisão de arquitetura nova | Alto | Não | Não |
| Debugging sem reprodução clara | Alto | Parcial | Limitado |
Falhas custam quase nada para o modelo, muito para o humano
Um dos pontos mais concretos do artigo é o caso de Jacob Tsimerman, matemático contratado recentemente pela OpenAI, que já havia considerado a mesma hipótese de contraexemplo para a distância unitária, inclusive testando graus crescentes de campos numéricos, e desistiu. Em suas palavras:
Uma dinâmica muito assustadora, difícil de pensar através dos regimes analíticos e manter a intuição orientadora, consome muito tempo e frequentemente não dá resultado.
A very scary dynamic, hard to think through the analytic regimes and retain guiding intuition, consumes much time and frequently doesn't work out.Jacob Tsimerman, matemático na OpenAI
Para um humano, abandonar uma direção depois de semanas sem sinal de progresso é uma decisão racional: o custo é memória de trabalho, moral e carreira. Para um modelo rodando em paralelo com um verificador barato, esse custo praticamente não existe. Tsimerman resume a vantagem:
Isso talvez indique uma forma pela qual sistemas de IA têm uma vantagem: não é só que eles conseguem tentar todos os métodos conhecidos, mas que conseguem jogar por mais tempo e em águas mais traiçoeiras do que matemáticos, sem ficar sobrecarregados.
This may indicate one way that AI systems have an edge: it's not just that they can try all known methods, but they can play for longer and in more treacherous waters than mathematicians without getting overwhelmed.Jacob Tsimerman, matemático na OpenAI
O custo real desse tipo de busca
Essa vantagem não é de graça. A prova de Navier-Stokes publicada pela OpenAI em setembro, que completa um programa de trabalho anterior de Córdoba e Martínez-Zoroa, usou 10 mil agentes e um total de 300 bilhões de tokens ao longo de 88 horas, segundo o artigo. É o tipo de número que qualquer engenheiro estimando custo de uma arquitetura de agentes em produção precisa ter em mente: busca em profundidade com verificação automática escala, mas escala em compute, não em elegância.
Onde a IA ainda não tem vantagem
O próprio Gowers aponta o limite: problemas onde a árvore de busca é profunda e tem muita ramificação, de forma que, sem uma poda rigorosa, a busca não é viável nem para um computador. Em outras palavras, alto b e alto k combinados, justamente onde a intuição humana ainda importa.
Isso tem um paralelo direto em engenharia de software. Decisões de arquitetura, escolha entre abordagens de design sem um critério objetivo de certo e errado, ou debugging de um bug intermitente sem reprodução confiável são problemas sem o que o artigo chama de gradiente: não há sinal intermediário de progresso que um verificador consiga medir enquanto a busca acontece. Um estudo de Metcalfe e Wiebe, citado no texto, mostrou que pessoas resolvendo problemas de insight relatam zero sensação de progresso até encontrar a resposta, diferente de problemas comuns, onde o progresso é percebido gradualmente.
Em resumo: antes de colocar um agente autônomo para resolver algo em produção, vale perguntar duas coisas, nessa ordem. Existe um verificador rápido e confiável para o resultado final, seja ele um compilador, uma suíte de testes, um scanner de segurança ou um critério de aceite objetivo?
E o fator de ramificação do problema é baixo o suficiente para que perseguir todos os caminhos plausíveis seja viável em tempo e em custo de tokens? Se as duas respostas forem sim, delegar ao modelo tende a compensar. Se a resposta para qualquer uma delas for não, o papel do modelo é explorar e descartar ramos mais rápido do que um humano faria sozinho, não substituir o julgamento de quem decide.
Fonte: Latent Space
Este artigo foi escrito por Alan Andrade, colunista de inteligência artificial. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.

Claude Agent SDK expõe o motor do Claude Code para construir agentes próprios
Disponível desde 2025 como evolução do antigo Claude Code SDK, a biblioteca da Anthropic empacota tools, subagentes, permissões e sessões do Claude Code para quem quer programar o próprio agente em Python ou TypeScript.