NVIDIA e AI4Bharat abrem pipeline que gerou 2,8 trilhões de tokens para treinar IA em línguas indianas
A NVIDIA e o laboratório indiano AI4Bharat publicaram o Nemotron-pretraining-Indic-v1, corpus de 2,8 trilhões de tokens em 22 línguas da Índia, junto com o pipeline de geração de dados sintéticos usado para criá-lo. O recorte interessa a quem quer treinar modelos em português ou em línguas indígenas brasileiras sem depender só de dados em inglês.

A NVIDIA publicou, em parceria com o AI4Bharat (laboratório de línguas indianas do IIT Madras) e a Bodhan AI↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI →, o Nemotron-pretraining-Indic-v1, um corpus de aproximadamente 2,8 trilhões de tokens cobrindo as 22 línguas listadas na Constituição indiana. O anúncio saiu no blog da NVIDIA no Hugging Face nesta sexta-feira (16/10). Mais importante que o volume de dados é o que vem junto: o pipeline completo de geração, com prompts, fluxo de avaliação de qualidade e lógica de reparo, liberado para quem quiser adaptar a receita a outro idioma ou domínio.
Para quem desenvolve em português ou pesquisa línguas indígenas brasileiras, o valor não está nos dados em si (são línguas da Índia, não vão servir diretamente), mas na engenharia por trás: como transformar um corpus em inglês de alta qualidade em dados de pré-treino confiáveis para um idioma com poucos dados nativos. É exatamente o problema que qualquer equipe brasileira enfrentaria ao tentar treinar um modelo decente em guarani, nheengatu ou mesmo em um português técnico mais especializado.
Como o pipeline transforma inglês em dado de treino
O ponto de partida são 15 subconjuntos do Nemotron-CC-v2, cobrindo texto web, perguntas e respostas, matemática e código. A equipe usa o NeMo Data Designer, framework open-source da NVIDIA para geração de dados sintéticos, para rodar três etapas: tradução, avaliação de qualidade e reparo. Cada registro de saída mantém o identificador do documento-fonte original, o que permite auditar de onde veio cada frase traduzida.
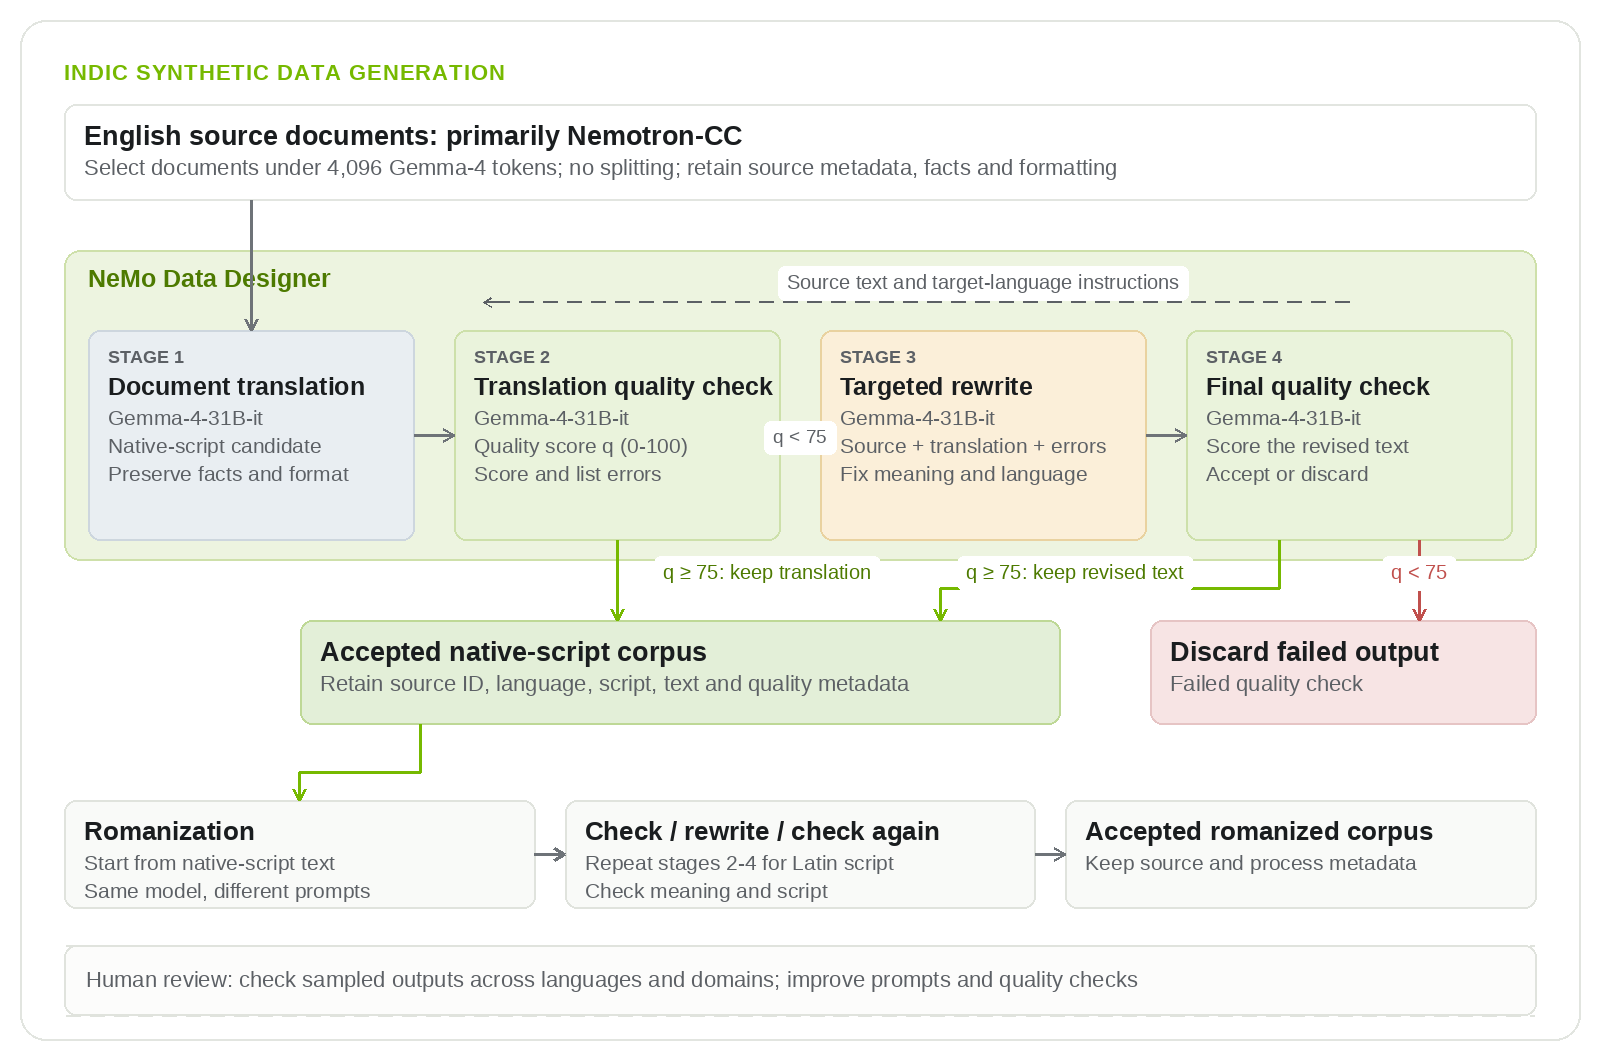
O corpus foi dividido em dois grupos com workflows diferentes, porque nem todo modelo de tradução se comporta bem em documentos longos ou em scripts instáveis:
- Doze línguas (bengali, gujarati, hindi, canarês, malaiala, marata, nepali, odia, punjabi, tâmil, télugo e urdu) recebem script nativo e também romanizado (texto na língua, mas em alfabeto latino).
- Dez línguas (assamês, bodo, dogri, caxemira, concani, maithili, manipuri, sânscrito, santali e sindi) recebem só o script nativo.
Nas doze línguas principais, a equipe traduz o documento inteiro de uma vez, preservando contexto entre parágrafos, tabelas e equações, usando o Gemma-4-31B-it. O mesmo modelo depois avalia a própria tradução contra o texto original em inglês, com uma rubrica inspirada no framework Multidimensional Quality Metrics (MQM), que separa erros por tipo e gravidade: sentido, fluência, terminologia, estilo e formatação.
Só entram no corpus final traduções com nota mínima de 75 em 100 nessa rubrica. O que fica abaixo disso não é descartado direto: o próprio feedback da avaliação alimenta uma etapa de reparo, e o texto corrigido é reavaliado contra o mesmo corte. Esse ciclo de reparo recuperou 438,4 bilhões de tokens que, sem ele, teriam sido perdidos.
Para as outras dez línguas, a tradução sai de um modelo dedicado, o Indic Translate, da Bodhan AI, e passa pelo mesmo crivo do Gemma-4-31B-it, mas sem o ciclo de reparo. Casos especiais ganham tratamento à parte: documentos longos em santali são traduzidos em janelas sobrepostas e depois reconstruídos, e o manipuri passa primeiro por escrita bengali antes de ser convertido para seu alfabeto nativo, o meitei mayek.
Script nativo não é a mesma coisa que texto romanizado
Um detalhe que costuma passar batido em discussões sobre dados multilíngues: "script nativo", no vocabulário do projeto, não quer dizer texto escrito originalmente naquela língua. Quer dizer que o conteúdo foi traduzido do inglês e grafado no alfabeto nativo do idioma. Já o texto romanizado é a mesma língua indiana, só que escrita em caracteres latinos, não uma tradução para o inglês.
Essa distinção importa na hora de montar a mistura de treino, porque script nativo e romanizado podem carregar o mesmo conteúdo com exposições de caractere bem diferentes. Para os doze idiomas com ambas as versões, a romanização parte das traduções já aceitas em script nativo, e não é gerada direto do inglês: segundo a equipe, esse caminho em duas etapas produziu menos alucinações e menos resíduo de inglês do que ir direto do texto-fonte para o alfabeto latino.
O que isso mudou num modelo real
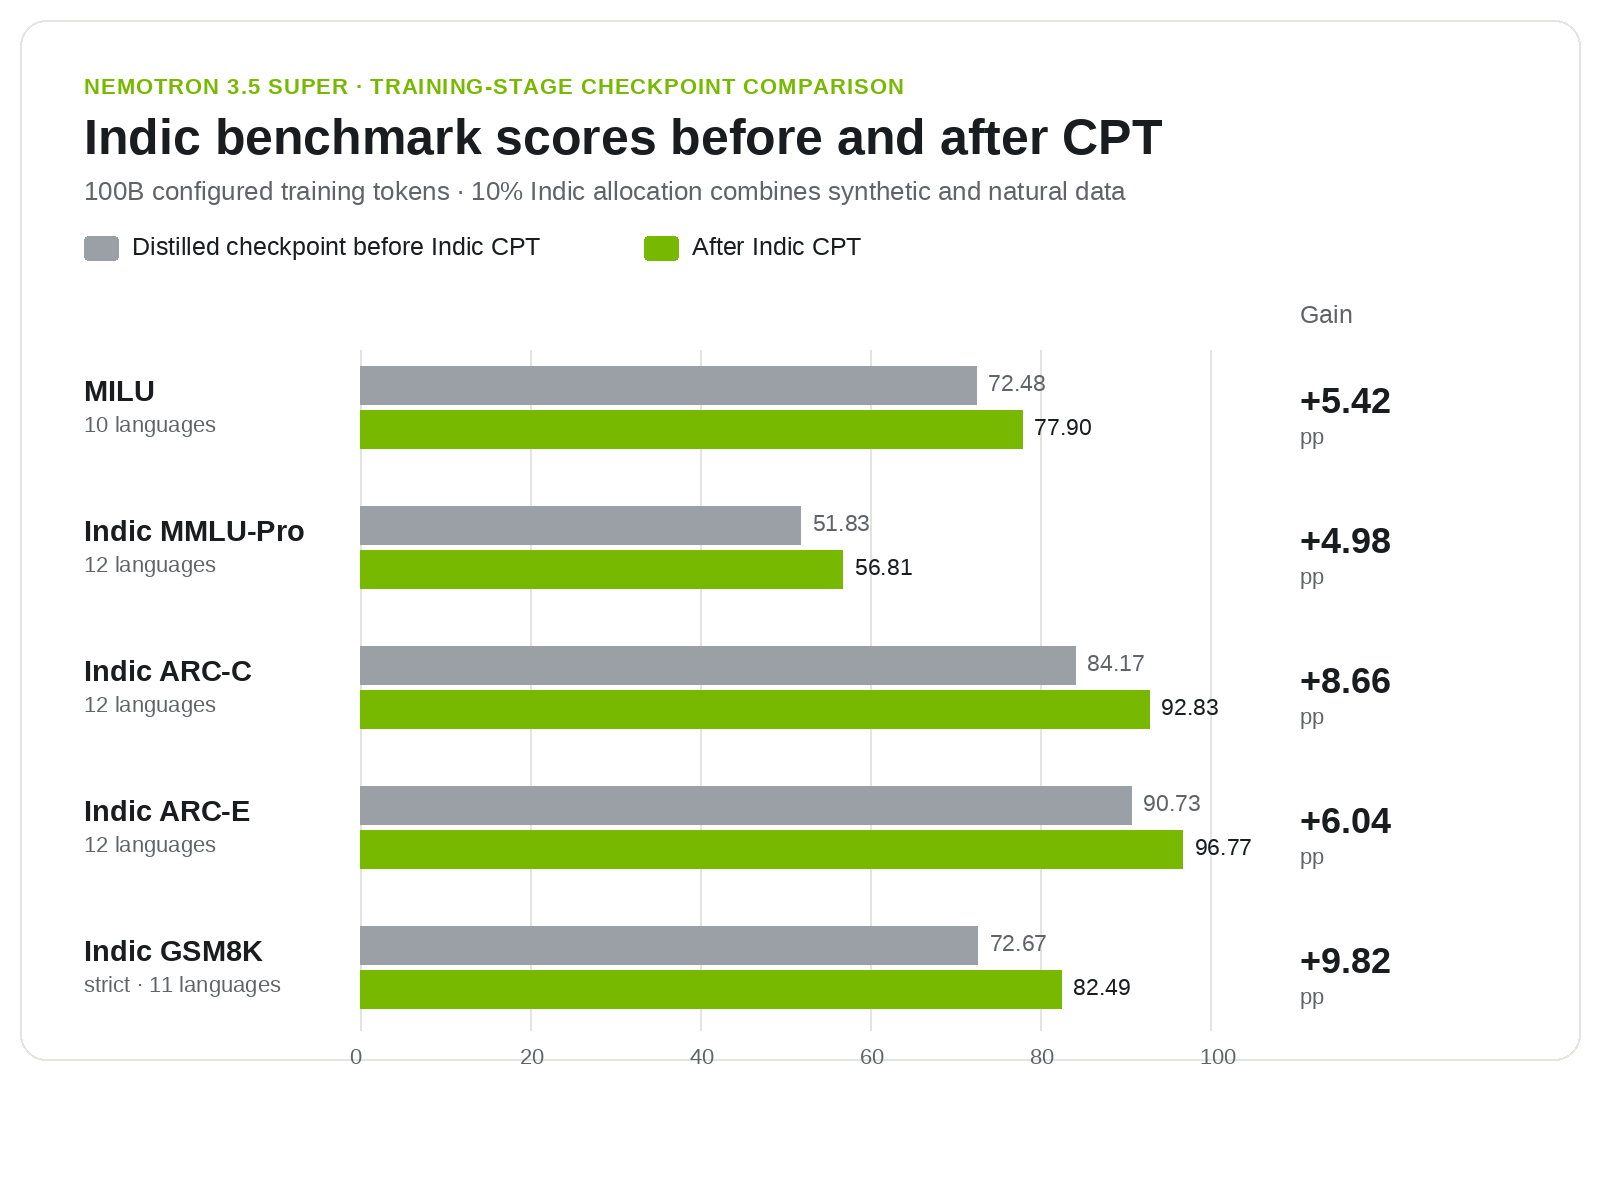
A NVIDIA usou um subconjunto de doze línguas desse corpus, somado a texto indiano natural, para fazer continued pretraining do Nemotron 3.5 Super VL: um orçamento de 100 bilhões de tokens de treino, dos quais 10% (10 bilhões) eram dados indianos sintéticos e naturais. Comparando o checkpoint antes e depois dessa etapa, os cinco benchmarks de conhecimento e raciocínio em línguas indianas (MILU, Indic MMLU-Pro, Indic ARC-Challenge, Indic ARC-Easy e Indic GSM8K) subiram entre 4,98 e 9,82 pontos percentuais.
Mitesh Khapra, que coordena o AI4Bharat e entrou na lista TIME100 AI de 2025, resume o problema que o projeto tenta atacar:
Não temos dados suficientes para as línguas indianas.
We do not have enough data for Indian languages.Mitesh Khapra, head do AI4Bharat, IIT Madras
Vale notar o limite da comparação: o ganho mede uma etapa de treino que combina dado sintético com dado natural, não isola a contribuição do corpus sintético sozinho. E o relatório técnico do Nemotron 3.5 Super VL trata esses números como resultado de estágio de treino, não como comparação definitiva entre versões finais do modelo.
Testando o dataset na prática
O corpus é organizado por tags de idioma, script e região: hi-Deva-IN é hindi em devanagari, hi-Latn-IN é hindi romanizado. O exemplo que a NVIDIA publica para explorar o dataset via datasets do Hugging Face é direto:
from datasets import get_dataset_split_names, load_dataset

dataset_id = input("Repository ID from the dataset card: ").strip()
config = "hi-Deva-IN"

splits = get_dataset_split_names(dataset_id, config_name=config)
print("Available splits:", splits)

data = load_dataset(
 dataset_id, name=config, split=splits[0], streaming=True
)
print(next(iter(data)))
O uso de streaming=True evita baixar o corpus inteiro só para inspecionar uma amostra, o que é relevante quando se fala em trilhões de tokens. A recomendação da própria NVIDIA para um primeiro estudo é comparar misturas de dado natural/sintético e nativo/romanizado com orçamento fixo de tokens, acompanhando retenção de capacidade em inglês e qualidade de script por idioma.
O que dá para reaproveitar fora do contexto indiano
A peça mais exportável do anúncio é o plugin Nemotron Bharat para o NeMo Data Designer: open-source, com prompts de tradução e avaliação, reparo opcional por feedback, janelamento de documentos longos e suporte a remapeamento de script. Um time que queira montar um pipeline parecido para português técnico, ou para uma língua indígena brasileira com pouco corpus nativo, tem ali uma referência de arquitetura testada em escala: tradução de documento completo, avaliação automática com rubrica própria, corte de aceitação explícito e ciclo de reparo guiado pelo próprio feedback do avaliador.
Em resumo, o ganho prático para quem constrói fora da Índia não é o dataset, e sim o desenho do processo: como transformar tradução automática em dado de treino auditável, com proveniência rastreável até o documento-fonte e um limiar de qualidade explícito (75/100) em vez de aceitar tudo que sai do modelo tradutor.
Onde o pipeline esbarra
A própria NVIDIA lista limitações que valem para qualquer adaptação do método. A avaliação de qualidade é majoritariamente automática, com revisão humana amostral cuja cobertura varia por idioma; no workflow das doze línguas principais, o mesmo modelo que traduz também julga a própria tradução, o que é um conflito de interesse metodológico conhecido. A checagem por identificador de fonte remove duplicatas de processamento, mas não é deduplicação semântica de conteúdo parecido.
Mais relevante ainda: tradução nunca substitui texto escrito originalmente naquela língua, nem garante cobertura de conhecimento local e cultural. Para português ou línguas indígenas brasileiras, isso significa que um pipeline nesse molde resolve volume, mas não resolve a ausência de corpus nativo rico; a recomendação da própria equipe é combinar dado sintético com texto natural bem curado e avaliar a mistura resultante para o caso de uso específico, não assumir que tradução em escala basta.
Fonte: Hugging Face Blog
Este artigo foi escrito por Alan Andrade, colunista de inteligência artificial. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Third Moment Research roda 10 mil agentes de IA por até 48 horas em pesquisa quantitativa
Case publicado pela OpenAI detalha a arquitetura por trás de investigações autônomas de 36 a 48 horas com Codex e os modelos GPT-6 Astra, Sol e 6.1 Sol, aplicada a pesquisa quantitativa de mercado.