IBM atualiza família Granite Speech com transcrição, tradução e identificação de falante em código aberto


A IBM lançou a versão 5.0 do Granite Speech e atualizou dois modelos irmãos, cobrindo desde transcrição rápida até identificação de quem fala em gravações com várias pessoas, tudo sob licença Apache 2.0.
A IBM lançou a versão 5.0 do Granite Speech e atualizou dois modelos irmãos, cobrindo desde transcrição rápida até identificação de quem fala em gravações com várias pessoas, tudo sob licença Apache 2.0.
A IBM lançou a versão 5.0 do Granite Speech e atualizou dois modelos irmãos, cobrindo desde transcrição rápida até identificação de quem fala em gravações com várias pessoas, tudo sob licença Apache 2.0.
A IBM publicou em 21 de outubro de 2026, no blog da Hugging Face, a atualização da sua família de modelos de fala: o novo granite-speech-5.0-2b e as versões revisadas de granite-speech-5.0-470m-turboctc e granite-speech-4.1-2b-plus. O post, assinado por pesquisadores da IBM Research como George Saon e Brian Kingsbury, descreve três modelos para três problemas diferentes: transcrição e tradução de alta precisão, transcrição ultrarrápida para rodar em dispositivo, e gravações com múltiplos falantes em que saber quem disse o quê importa tanto quanto o conteúdo.
Para quem desenvolve no Brasil, o ponto central não é só a precisão: é que os três modelos saem sob licença Apache 2.0, com suporte nativo em Transformers, e o granite-speech-5.0-2b especificamente também roda em vLLM, llama.cpp e mlx-audio para Apple Silicon. Isso significa rodar transcrição e tradução de fala inteiramente on-premise ou no próprio laptop, sem mandar áudio para uma API de terceiros e sem pagar por token de voz processado.
Três modelos, três casos de uso
A IBM organizou a família por cenário de uso, não por tamanho. A tabela abaixo resume o que cada modelo resolve, segundo o próprio post:
| Modelo | Status | Indicado para |
|---|---|---|
granite-speech-5.0-2b | Novo | Transcrição e tradução multilíngue de alta precisão |
granite-speech-5.0-470m-turboctc | Atualizado | Transcrição em alto volume e no dispositivo |
granite-speech-4.1-2b-plus | Atualizado | Reuniões, ligações e gravações com vários falantes |
A recomendação da própria IBM é direta: se a prioridade é acurácia, tradução ou viés de palavras-chave, use o 5.0-2b; se o que importa é velocidade ou rodar embarcado, use o Turbo CTC; se o áudio tem várias vozes e timestamp importa, use o 4.1-2b-plus.
Granite Speech 5.0 2B: mais preciso, mais multilíngue
O granite-speech-5.0-2b é o sucessor direto do granite-speech-4.1-2b, mantendo os mesmos 2 bilhões de parâmetros. Ele transcreve inglês, francês, alemão, espanhol, português e japonês, e traduz entre inglês e esses idiomas, além de inglês para italiano e mandarim. Foi treinado em 390 mil horas de áudio público mais dados sintéticos criados especificamente para ASR em japonês, viés de palavras-chave e tradução.
Vale notar que o recorte de idiomas nativos ainda é modesto perto de alternativas mais amplas do mercado: aqui o ganho não é cobertura ampla, é profundidade em um conjunto menor e mais robusto para cenários corporativos ocidentais, com português incluído desde o início.
Entre as novidades sobre a versão 4.1, o post destaca:
- Language ID prompting: dá pra informar o idioma de entrada diretamente no prompt para guiar a transcrição multilíngue.
- Tradução de fala longa e conversacional mais estável, não só em frases curtas e lidas.
- Listas de palavras-chave com até 2.000 termos, úteis para enviesar a transcrição a favor de nomes de produto, pessoas e siglas em qualquer idioma suportado.
- Pontuação e capitalização sob demanda, com F1 de capitalização entre 89,7 e 99,5 nos conjuntos de teste da IBM.
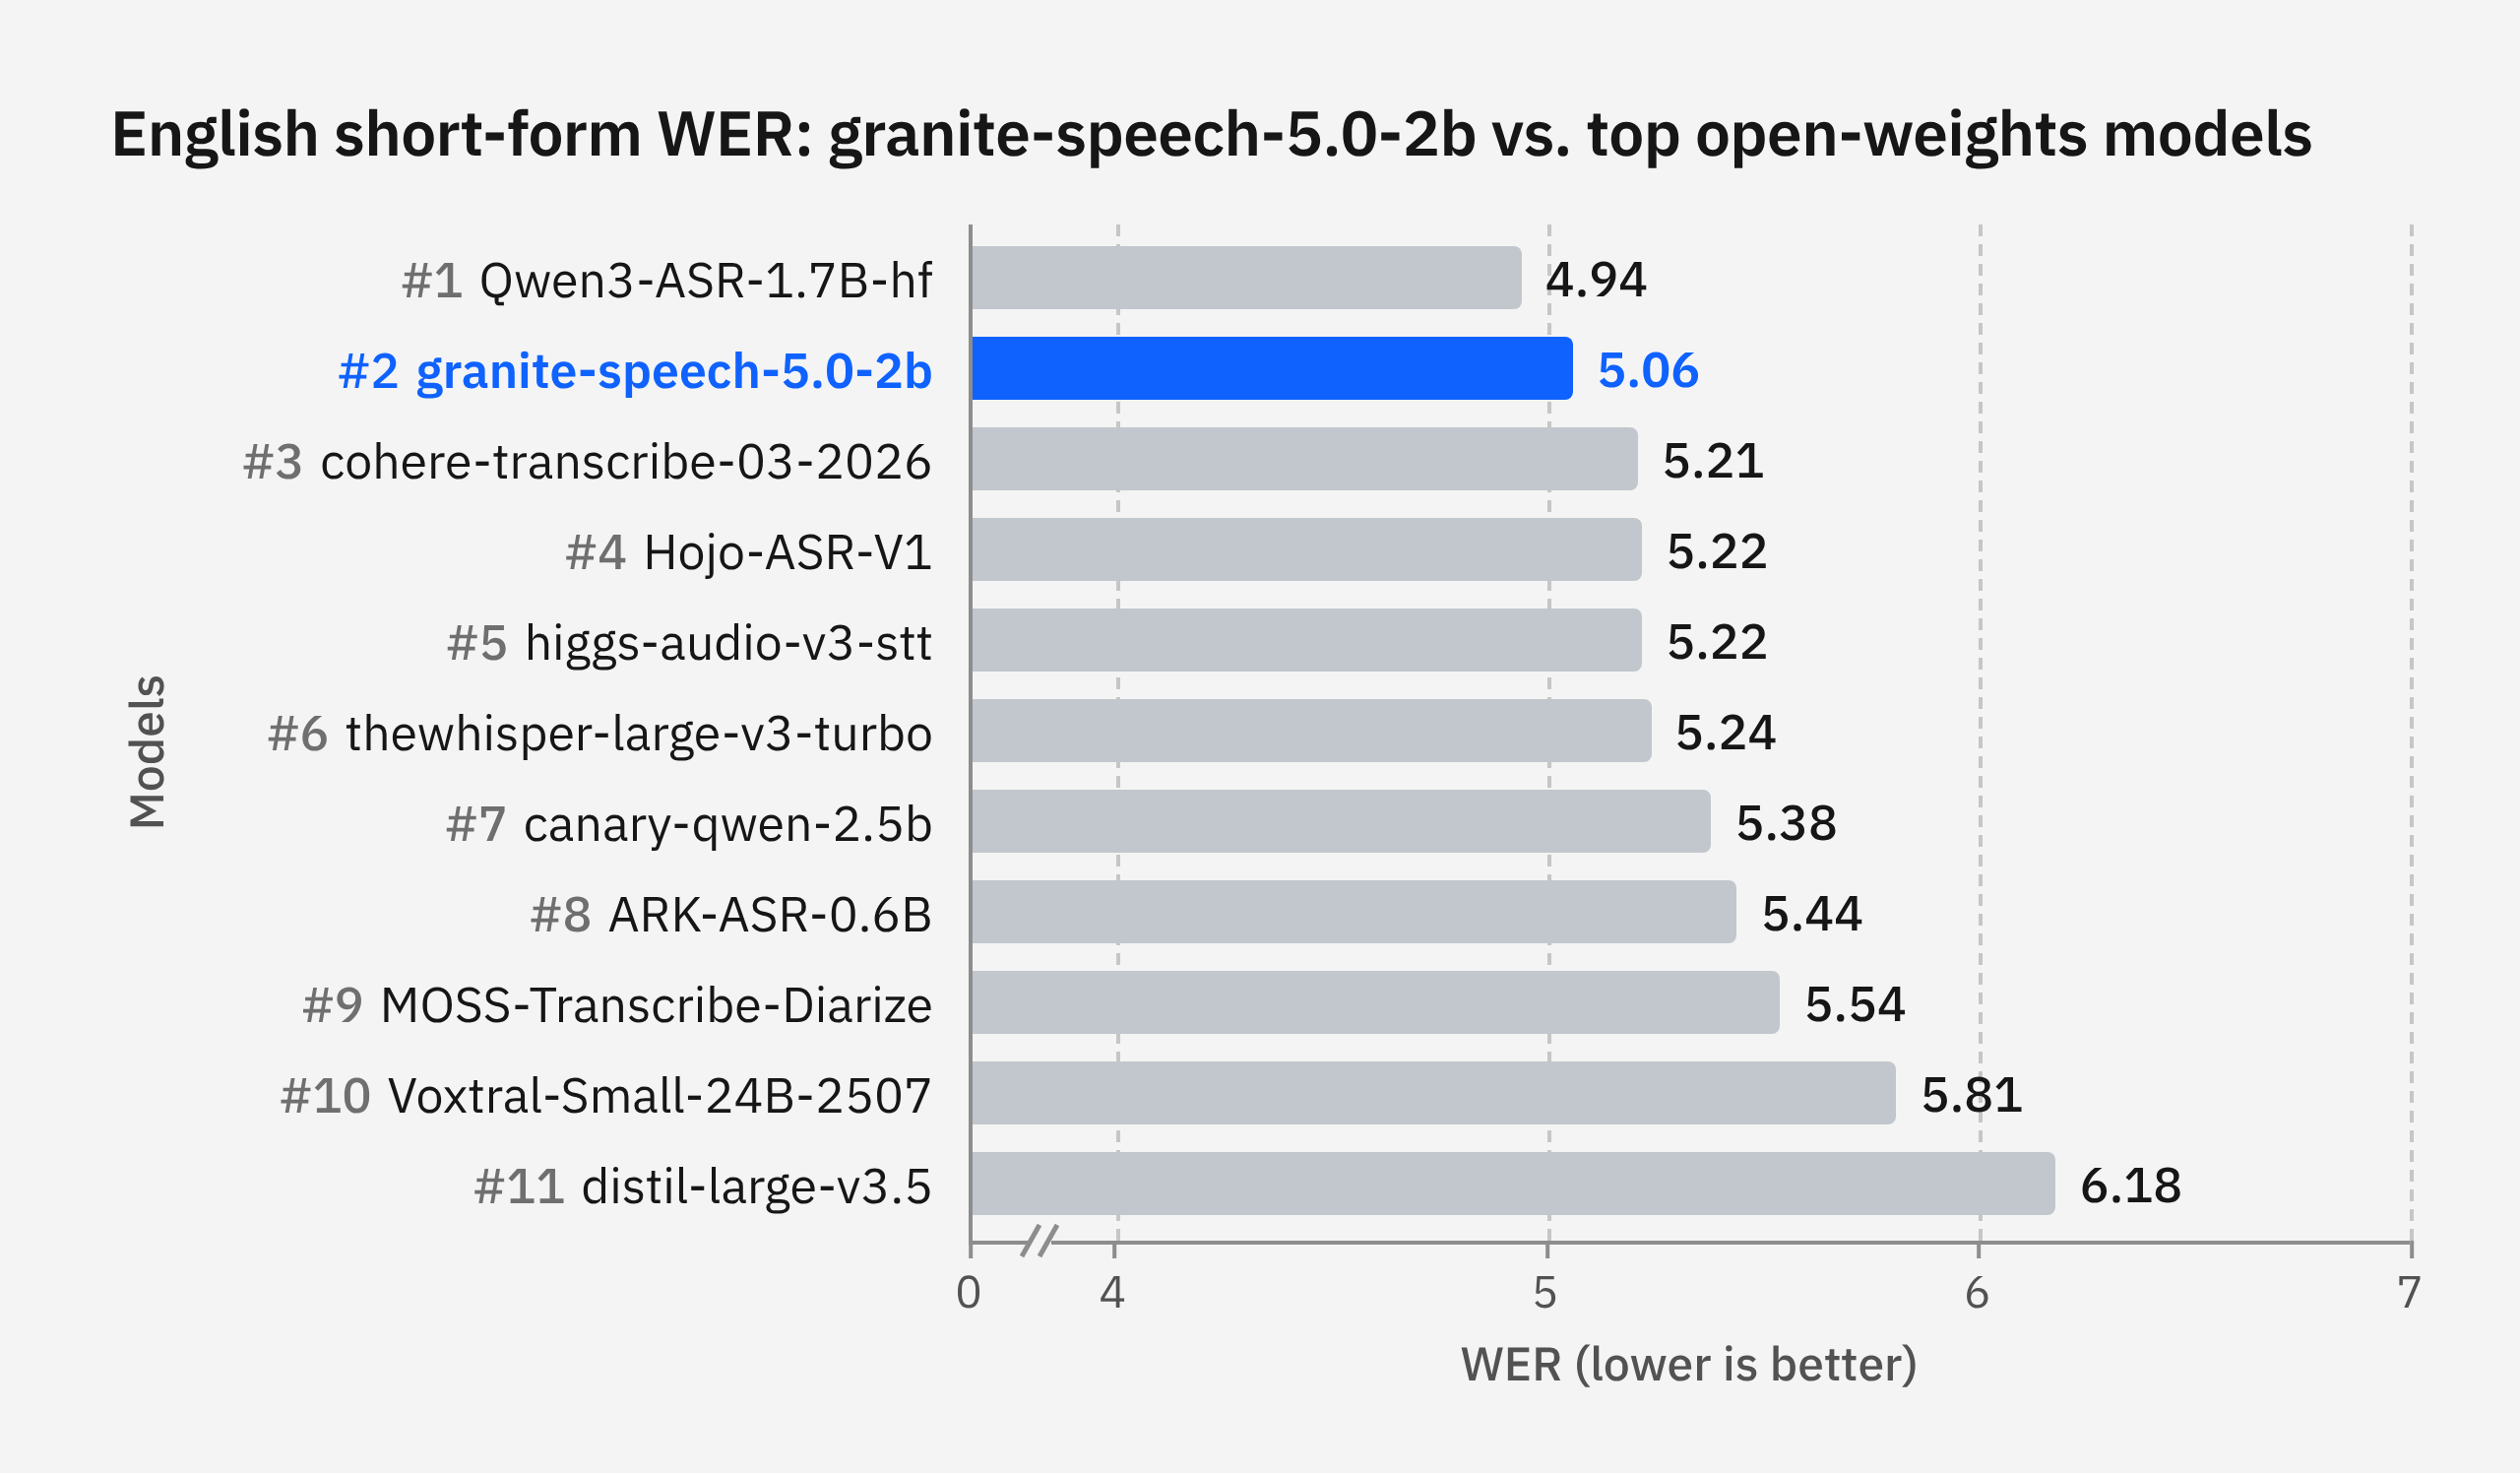
No Open ASR Leaderboard, a IBM reporta que o granite-speech-5.0-2b ficou em segundo lugar entre modelos de peso aberto em WER médio em inglês (taxa de erro de palavra, quanto menor melhor), com 5,06%, em medição não oficial feita em 15 de outubro de 2026 sobre os conjuntos de teste públicos de fala curta em inglês do leaderboard.
Turbo CTC: da velocidade em agosto à multilinguagem em outubro
O Turbo CTC foi apresentado em agosto como um encoder de 470 milhões de parâmetros só em inglês, construído para velocidade. A revisão de outubro mantém o tamanho e resolve três pedidos recorrentes da comunidade: suporte a inglês, japonês, espanhol, alemão, francês, italiano e português; pontuação e capitalização nativas, sem etapa separada de truecasing; e mais robustez em acústica difícil, com treino voltado especificamente para áudio reverberante e gravações de microfone distante.
O modelo também ficou mais rápido. Compilando um único bloco Conformer e reaproveitando seu grafo ao longo da pilha, a IBM reduziu o tempo de warmup e levou o Turbo CTC a 19.870 RTFx no Open ASR Leaderboard, ante cerca de 12.600 RTFx no lançamento de agosto: um ganho de aproximadamente 1,6x na mesma faixa de acurácia. RTFx mede quantas vezes mais rápido que o tempo real o modelo processa áudio; quanto maior, melhor para transcrição em lote ou em tempo real com folga de recursos.
A IBM disponibiliza uma demo de streaming via WebGPU para testar o Turbo CTC direto no navegador, sem instalar nada localmente.
4.1 2B Plus: identificar quem fala, e quando
O granite-speech-4.1-2b-plus manteve o nome 4.1 porque arquitetura, formato de prompt e API continuam os mesmos: é uma troca de pesos, não uma migração de código, o que facilita atualizar quem já usa o modelo em produção. As melhorias miram diretamente o tipo de áudio que empresas de fato têm: reuniões, ligações de suporte e entrevistas longas com vários participantes.
A tabela de métricas publicada pela IBM mostra o tamanho do ganho:
| Capacidade | Métrica | Versão anterior | Modelo atualizado |
|---|---|---|---|
| Timestamps, fala longa | AAS (desvio médio de timestamp) | 210,86 | 98,54 |
| Timestamps, fala curta | AAS | 29,27 | 26,20 |
| Viés de palavras-chave | WER com lista de 20 termos | 11,79 | 6,48 |
| Fala longa | WER em conjuntos long-form | 13,53 | 10,22 |
| Atribuição de falante | WDER | 4,40 | 4,10 |
| Transcrição com falante | cpWER | 30,50 | 28,48 |
Todas as métricas da tabela são taxas de erro, então quanto menor, melhor. O destaque é o AAS em fala longa, que caiu mais da metade: na prática, isso significa timestamps mais confiáveis para legendas, busca dentro de gravação e revisão de chamadas, um ponto sensível em qualquer pipeline de compliance ou atendimento que precise localizar o trecho exato de uma conversa.
O que muda pra quem desenvolve aqui
Os três modelos ficam disponíveis no Hugging Face Hub sob a organização ibm-granite, com cartões de modelo detalhando arquitetura, dados de treino e exemplos de uso. A IBM recomenda combinar qualquer um deles com o Granite Guardian em deploys de produção que precisem de detecção adicional de risco, algo a considerar antes de expor transcrição automática a dados sensíveis de cliente.
Para um time que hoje depende de uma API de transcrição paga, a proposta é clara: compatibilidade com Transformers reduz o atrito de integração, e a opção por llama.cpp ou mlx-audio no granite-speech-5.0-2b abre caminho para rodar transcrição em notebook com Apple Silicon sem GPU dedicada. Já o granite-speech-5.0-2b, por ter 2 bilhões de parâmetros, pede mais memória e, provavelmente, uma GPU para rodar em latência aceitável em produção.
Vale a pena considerar os três modelos quando o caso de uso cai dentro dos sete idiomas suportados e a prioridade é não depender de serviço externo de voz. Não vale a pena trocar uma solução já madura se o projeto precisa de idiomas fora dessa lista, como línguas asiáticas além do japonês ou idiomas africanos, caso em que modelos com cobertura mais ampla, ainda que proprietários, seguem sendo a opção mais direta.
Fonte: Hugging Face Blog
Este artigo foi escrito por Alan Andrade, colunista de inteligência artificial. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
AnyLanguageModel 1.0 faz apps iOS e macOS rodarem IA sem internet
Biblioteca de código aberto da Hugging Face chega à versão 1.0 trocando duas linhas de import para rodar o mesmo código com modelo local, Apple Intelligence ou provedores como OpenAI e Anthropic.