LinkedIn abandona Argo CD e cria engine GitOps própria para escalar Kubernetes

- Leitura
- 6 min
- Tabelas
- 1
- Fontes
- 1
Em post recente, o LinkedIn detalhou por que trocou o Argo CD por um motor GitOps construído internamente para orquestrar mais de 250 clusters e 100 mil deploys por semana.
O que o LinkedIn anunciou
Em um post recente, o LinkedIn revelou que substituiu o Argo CD por um motor GitOps construído internamente para orquestrar deploys em mais de 250 clusters Kubernetes↳Kubernetes18 conteúdosGerenciamento de infraestrutura multicloud com Kubernetes proporciona otimização e economiaDevSecOps · set 2021Azure Kubernetes Services – AKS: referências gratuitas e dicas para solução de problemas comunsDevSecOps · abr 2019Kubernetes em produção: o que ninguém te conta e você aprende tarde demaisDev (Back & Front) · abr 2026Ver tudo em DevSecOps →, segundo a InfoQ. O sistema atende mais de 4.000 serviços e processa acima de 100 mil deploys por semana.
A migração rodou de julho de 2025 a abril de 2026, o que torna maio de 2026 o primeiro mês inteiro já operando só com o motor novo. A empresa comparou o mesmo mês do calendário um ano antes e depois: as falhas de infraestrutura de deploy caíram de 925 para 63, mesmo com o volume de deploys crescendo 3,7 vezes. O tempo mediano para detectar e concluir um deploy falho caiu de 16,1 para 2,45 minutos.
Como era a arquitetura com Argo CD
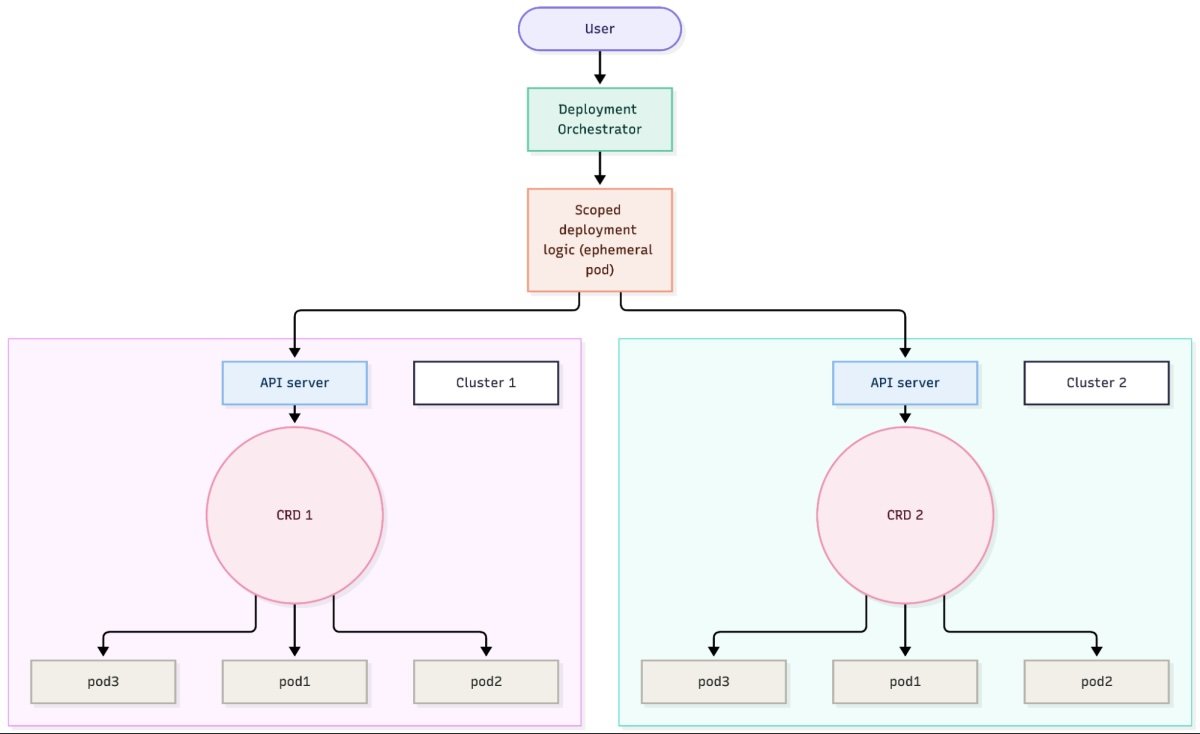
O LinkedIn começou com uma instância de Argo CD por cluster, topologia escolhida porque a ferramenta já gerenciava os add-ons de cluster nesse formato. Os clusters chegam a 5.000 nós cada. Um orquestrador central de deploy criava um pod efêmero por deployment, com o Argo CD escondido atrás dele.
A equipe lista sete problemas que surgiram nessa escala:
- Falta de
observedGeneration: não dá para ligar o status de sync e health a um deployment específico. O LinkedIn criou um health check em Lua com uma anotação de rastreamento para contornar isso. - Cache obsoleto do repo-server: uma aplicação marcada como
SyncedeHealthypodia, na prática, resolver para uma revisão diferente da pretendida. - Contenção de watch: o Argo CD mantém um watch por group-version-resource entre todas as Applications. Como os clusters do LinkedIn têm baixa diversidade de tipos de recurso, o churn no
etcdgerado por uma app atrasava o sync de todas as outras. Em um teste, o sync levou menos de 3 minutos num cluster com 60 mil pods e mais de 10 minutos com acima de 80 mil pods. - PATCH via server-side-apply: o Kubernetes trunca o
managedFieldsdepois que um objeto passa de 10 field managers distintos, e o API server perde o controle de quem é dono de cada campo. Nas cargas de IA↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI → do LinkedIn, que rodam múltiplos containers por pod, um container removido do manifesto podia sobreviver no pod em produção. A equipe mantinha oprunedesativado porque operações destrutivas em produção exigem aprovação. - Mudanças de schema em CRDs exigiam reiniciar controllers em toda a frota.
- Estados
OutOfSyncque não refletiam drift real. - Mensagens de erro enterradas em boilerplate, difíceis de interpretar.
Por que construir em vez de estender
O LinkedIn avaliou o Flux, mas concluiu que ele compartilha o mesmo paradigma de controller do Argo CD, que foi justamente a raiz dos problemas de contenção. A decisão foi construir o motor como uma biblioteca, não como um controller central.
No desenho novo, cada deployment roda no próprio pod, sem estado de controller compartilhado. As atualizações usam PUT para substituição completa do objeto, em vez de PATCH, com retry em conflitos de resourceVersion e backoff exponencial. Um diff de três vias, comparando o objeto ao vivo, o manifesto implantado anteriormente e o manifesto recém-renderizado, detecta drift genuíno e falha o deployment quando ele ocorre.
O mesmo pod observa o status do objeto até ele convergir ou estourar o timeout, e o API server repassa os erros de forma legível para quem fez o deploy. Objetos ausentes do manifesto renderizado viram candidatos à exclusão, sujeitos a proteção contra delete, e a lógica de convergência das CRDs próprias do LinkedIn já vem embutida no motor.
Os números vêm com ressalvas
O próprio LinkedIn pondera a comparação antes de comemorar os ganhos:
- A contagem de falhas de infraestrutura cobre só falhas causadas pelo sistema de deploy, excluindo erros de drift, porque os dois sistemas definem drift de forma diferente.
- A melhora não vem só do motor novo: a classificação de erros e a confiabilidade do orquestrador também evoluíram no mesmo período.
- A duração mediana de deploys bem-sucedidos é parecida nos dois sistemas; quem melhorou foram a média e a cauda, efeito que a equipe atribui a um cache de informer com escopo por namespace.
O motor é interno e não há menção a lançamento open source↳Open source71 conteúdosComo o Open Source Está Liberando o Poder da Automação para TodosDev (Back & Front) · out 2025Código aberto: programadores criam software da NASA sem saberDev (Back & Front) · abr 2021N8N: O que é a ferramenta open source que está revolucionando a automação em TI?Dev (Back & Front) · dez 2025Ver tudo em Dev (Back & Front) →. O Argo CD continua em uso no LinkedIn para add-ons de cluster e serviços de sistema. Um dos motivadores da mudança, segundo a empresa, foi que manter mais de 200 instâncias de Argo CD transformava cada upgrade em um projeto de várias semanas.
Não é só o LinkedIn reinventando a roda
Outras operações de grande escala também construíram lógica de deploy em torno do Kubernetes em vez de adotar um controller GitOps genérico:
| Empresa | Abordagem | Modelo de execução |
|---|---|---|
| Motor GitOps próprio, como biblioteca | Pod efêmero por deploy, sem estado de controller compartilhado | |
| Uber (plataforma Up) | Uber Deployment Controller | Controller dedicado e de longa duração por deployment, traduz intenção em primitivas do Kubernetes |
| Airbnb (kube-gen) | Framework interno apresentado por Melanie Cebula na QCon London 2019 | Deploy tool que aplica ou substitui objetos e reinicia pods, com sucesso/falha atômicos |
O kube-gen da Airbnb gera configuração do Kubernetes a partir de um único arquivo de projeto versionado, e trata um container que fica reiniciando por 30 segundos no início do rollout como deploy falho. Na época da palestra, a Airbnb rodava cerca de 125 mil deploys em produção por ano.
O que checar antes de pensar em reescrever
O próprio LinkedIn sugere dois diagnósticos que times rodando Argo CD em escala podem fazer sem reescrever nada:
- Contar os field managers em objetos de vida longa: o truncamento do
managedFieldspode deixar containers órfãos sem gerar nenhum erro visível. - Verificar se a latência de sync acompanha o total de pods em clusters compartilhados, sinal de contenção de watch.
Para quem projeta arquitetura de deploy no dia a dia, o caso do LinkedIn não é um veredito contra o Argo CD. É um relato de limite de escala: a ferramenta se mostrou sólida até um certo volume de clusters, nós e field managers por objeto, e o problema que apareceu foi estrutural ao modelo de controller central com watch compartilhado, não um bug pontual.
A conclusão do LinkedIn é que a decisão entre construir ou estender depende do modelo operacional: isolamento por deployment, e não ajuste fino de controller, foi o que permitiu escalar junto com o poder de computação disponível. Times que não operam nessa faixa de clusters de 5.000 nós dificilmente vão esbarrar nos mesmos sete problemas, mas os dois diagnósticos de managedFields e contenção de watch valem como checagem preventiva em qualquer instalação de Argo CD que já gerencie milhares de objetos.
Fonte: InfoQ
Highlights
- LinkedIn passou de 925 para 63 falhas de deploy por mês mesmo com volume 3,7x maior
- Tempo para detectar e concluir deploy falho caiu de 16,1 para 2,45 minutos
- Motor interno usa pod efêmero por deploy e diff de três vias para detectar drift real
- Outros gigantes (Uber, Airbnb) também construíram engines de deploy próprios ao atingir escala
- Dois diagnósticos preventivos: contar field managers em objetos de vida longa e medir latência de sync
Este artigo foi escrito por Redação iMasters. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.

Huawei detalha como o Kirin 9050 roda um modelo de 30 bilhões de parâmetros no aparelho
A fabricante chinesa explicou nesta semana como o chip Kirin 9050 processa um modelo de 30 bilhões de parâmetros localmente, sem depender de servidores na nuvem.