Adobe testa IA que transforma foto em cena 3D e cria personagem via conversa

- Leitura
- 6 min
- Fontes
- 1
Na edição 2026 do Adobe Max, a empresa mostrou protótipos experimentais que viram foto em cenário navegável, criam personagens por entrevista e automatizam retoque em grupo. Nenhum virou produto ainda.
No dia 11 de novembro de 2026, durante o Adobe Max, a Adobe apresentou um lote de "sneaks": protótipos experimentais de IA generativa↳IA generativa81 conteúdosIA Generativa: 5 alternativas para começar a usar em 2025AI · jan 2025Gartner Revela o Futuro da IA GenerativaAI · jul 2024IA Generativa: Pesquisa global aponta Brasil como segundo país mais otimista com a tecnologiaAI · mar 2024Ver tudo em AI → que não têm data nem garantia de virar produto, mas sinalizam para onde a empresa está puxando suas ferramentas de criação. Quem acompanhou o evento viu quatro projetos que tratam foto, personagem, som e retoque como matéria-prima manipulável por conversa, em vez de camadas e sliders tradicionais, segundo reportagem do The Verge.
Nenhum dos quatro está em Creative Cloud ou no Firefly hoje. São provas de conceito que a Adobe testa publicamente todo ano no Max, e historicamente só uma fração delas chega a virar recurso oficial. Ainda assim, o padrão por trás dos quatro projetos importa para quem desenha produto: a aposta é tornar fluxo complexo de edição em algo conversacional e exploratório, não só mais rápido.
Project Screen Test: você entrevista o personagem antes de usar
Em vez de descrever um personagem de IA só por prompt de texto, o Project Screen Test deixa o criador conversar com ele, como numa chamada de vídeo, para construir a personalidade aos poucos. O fluxo começa com traços básicos ("ansioso, tímido, estranho") e uma voz, escolhida entre presets, descrita em texto ou enviada como áudio de referência.
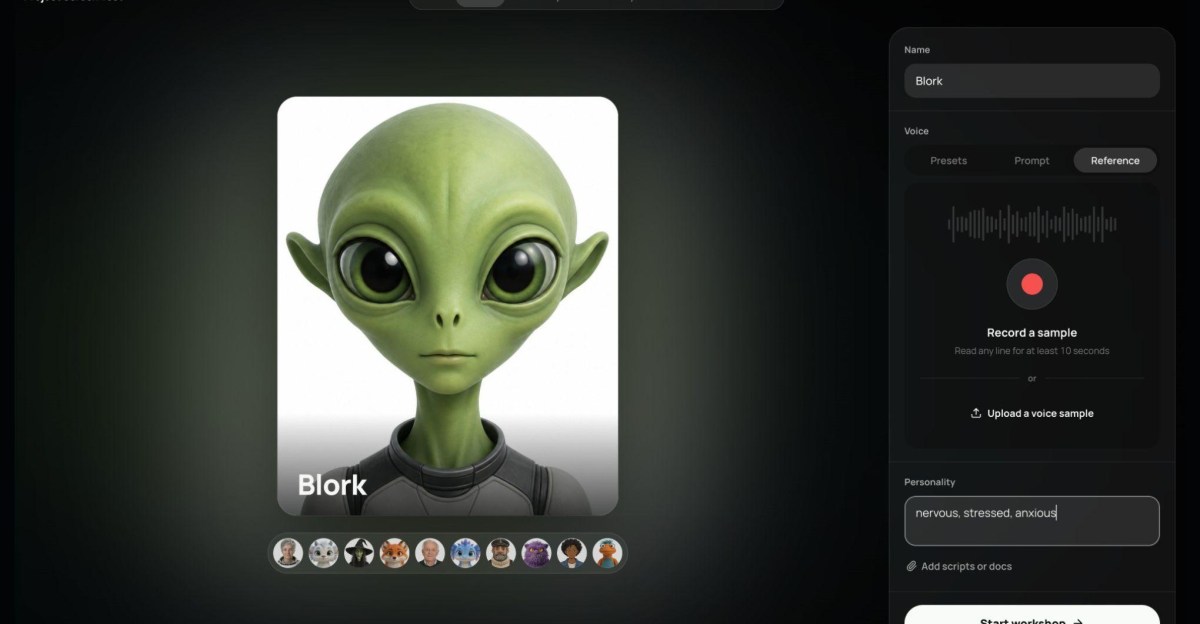
A partir daí, quem está criando expande a persona perguntando sobre histórico, temperamento, objetivos, medos e até cacoetes de movimento, como se fizesse uma entrevista de elenco. Uma aba de "Personality" permite ajustar manualmente qualquer traço gerado na conversa. No fim, o sistema gera testes de tela animados do personagem em cenários descritos pelo usuário.
Para quem desenha produtos de IA conversacional, personagem ou atendimento automatizado, o recorte interessante não é a geração de vídeo em si, mas o padrão de interface: construir persona por diálogo supervisionado, com controle manual no final, em vez de um prompt único que produz um resultado fechado. É um caminho de discovery que vale observar fora do contexto de vídeo.
Project Sight Span: a foto vira cenário que se explora
O Project Sight Span pega uma imagem plana (foto, pintura ou ilustração) e a transforma num ambiente 3D navegável, preenchendo com IA o que estaria fora do enquadramento original, inclusive atrás do ponto de vista inicial. Segundo o The Verge, o espaço gerado aparece pixelado durante a navegação, mas a resolução é restaurada quando o usuário escolhe o ângulo final.
Tornar essas interações mais intuitivas também é sobre dar a criativos experientes um controle mais preciso.
No original: Making these interactions more intuitive is also about giving experienced creatives more precise control.
 Fonte: The Verge
A ferramenta preserva estilo artístico e detalhes como tatuagens e traços faciais mesmo quando o enquadramento muda de forma agressiva. A comparação feita na reportagem é com o recurso Spatial Reframing da Apple, só que "com esteroides": dá para reposicionar a câmera de forma muito mais livre, ao custo de o resultado parecer cada vez menos uma foto e cada vez mais uma cena reconstruída.
Para design de produto, isso é terreno fértil e também um alerta. Fértil porque abre caminho para moodboards e protótipos visuais explorados em profundidade a partir de uma única referência; alerta porque borra a linha entre fotografia e cena sintética justamente no momento em que equipes de produto e marketing dependem de imagem "real" como prova social.
Project Sound Bender e Project Rinse Repeat: interface como canvas de decisão
Os outros dois projetos mostrados atacam fluxos menos visíveis, mas igualmente relevantes para quem pensa interação:
- Project Sound Bender deixa o usuário descrever um efeito sonoro em texto ("ruído de caldeirão de ficção científica borbulhando") e gera automaticamente o áudio sincronizado a um vídeo. Depois, um canvas quadrado funciona como roda de cores: cada canto carrega uma variação do som (borbulhar denso, rochas fervendo, bips agudos, crepitar elétrico), e arrastar o cursor pelo quadrado mistura essas variações em tempo real enquanto o usuário ouve o resultado.
- Project Rinse Repeat, construído sobre o Photoshop, copia um edit feito manualmente (como remover acne de uma pessoa numa foto de grupo) e aplica a mesma lógica de ajuste aos demais sujeitos da imagem, adaptando a cada rosto. A mesma ideia funciona para adicionar sombra a produtos de tamanhos e formas diferentes numa peça de marketing: o usuário ajusta um item manualmente e o sistema replica o raciocínio, não o pixel, nos demais, mantendo tudo editável nativamente no Photoshop.
Nos dois casos, o ganho de produto não é a geração em si, mas a interface de controle: canvas espacial em vez de slider numérico no Sound Bender, e replicação de intenção (não de resultado fixo) no Rinse Repeat. São pistas de como desenhar ferramentas de IA que dão sensação de precisão profissional sem exigir prompt reescrito a cada ajuste.
A capacidade de exploração sonora do Sound Bender e o posicionamento de câmera do Sight Span são exemplos de como profissionais poderiam aplicar seu julgamento e refinar um resultado mais diretamente.
No original: Sound Bender's sonic exploration capability and Sight Span's camera positioning are examples of how professionals could apply their judgment and refine a result more directly.
Fonte: The VergeO que a Adobe diz sobre a lógica por trás disso
Gautham Mysore, cientista de pesquisa sênior da Adobe, explicou ao The Verge o raciocínio de design comum aos quatro projetos:
Tornar essas interações mais intuitivas também é sobre dar a criativos experientes um controle mais preciso.
A capacidade de exploração sonora do Sound Bender e o posicionamento de câmera do Sight Span são exemplos de como profissionais poderiam aplicar seu julgamento e refinar um resultado de forma mais direta. Essa conexão entre intenção criativa e controle é uma grande parte do que estamos explorando.
O ponto que Mysore defende, e que vale anotar para qualquer roadmap de ferramenta com IA generativa, é que a barra de entrada baixa (conversar, arrastar um cursor, copiar um edit) não precisa significar menos controle fino para quem já domina o ofício. O desafio de design é entregar as duas coisas na mesma interface.
O que ainda está em aberto
A própria Adobe trata os quatro projetos como "sneaks": protótipos que podem nunca sair do estágio de demonstração, ou podem alimentar futuras versões do Creative Cloud e do Firefly. A reportagem do The Verge nota que, dado o quanto IA generativa já é central na estratégia de crescimento da empresa, é provável que ao menos parte dessas experiências vire recurso oficial, mas não há cronograma público nem confirmação de lançamento no Brasil ou em qualquer mercado.
Também fica em aberto o que acontece com bibliotecas de stock, banco de imagens e fluxos de retoque manual se ferramentas como Sight Span e Rinse Repeat amadurecerem: a própria reportagem do The Verge levanta a possibilidade de que, se forem boas o suficiente, essas IAs substituam parte do trabalho que hoje sustenta profissionais de imagem e som. Para quem desenha produto, o aprendizado imediato não é correr atrás de nenhum desses recursos específicos, mas observar o padrão de interação que a Adobe está testando publicamente antes de decidir o que lançar de fato.
Fonte: The Verge
Highlights
- Adobe mostra quatro protótipos de IA generativa no Max 2026: foto vira 3D, personagem por entrevista, som exploratório e retoque replicável
- Nenhum virou produto ainda; a Adobe testa assim anualmente, e historicamente só fração chega a recurso oficial
- O padrão comum é tornar fluxo complexo de edição em algo conversacional e exploratório, não só mais rápido
- Gautham Mysore aponta que baixa entrada não precisa significar menos controle fino para profissionais experientes
- Project Sight Span borra linha entre fotografia e cena sintética no momento em que equipes dependem de imagem real como prova social
Este artigo foi escrito por Redação iMasters. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Apple prepara app Harbor para rodar IA localmente em cluster de Macs
Um vazamento revela o Harbor, app em testes internos na Apple que promete rodar modelos de IA open-weight direto no Mac e juntar várias máquinas via Thunderbolt 5 sem configuração manual.