Grafana Tempo 3.1 troca lista de IDs por query TraceQL na redação de traces
A versão 3.1 do Tempo deixa redigir traces inteiros com uma query, corrige métricas distorcidas por sampling e reforça o cliente Kafka que virou peça central da arquitetura desde a versão 3.0.

A Grafana Labs lançou o Tempo 3.1, primeira atualização menor sobre a arquitetura 3.0, publicada em junho de 2026. A novidade central é prática: dá pra redigir dados sensíveis em traces usando uma query TraceQL, em vez de enumerar manualmente cada ID de trace afetado. O release também adiciona TLS e novos mecanismos SASL ao cliente Kafka, introduz um hint experimental que corrige métricas TraceQL distorcidas por sampling, e torna o formato de bloco vParquet5 o padrão. Segundo a Grafana, queries de métricas simples agora rodam quase duas vezes mais rápido.
Por que o cliente Kafka importa agora
Desde o Tempo 3.0, o Kafka deixou de ser opcional para virar peça do caminho crítico em deployments de microsserviços↳Microsserviços24 conteúdosArquitetura de Microsserviços em Node com o MoleculerJSDev (Back & Front) · jun 2025Segurança das APIs: como proteger seu ecossistema de microsserviçosDev (Back & Front) · dez 2023Você provavelmente não precisa de microsserviços (ainda)Dev (Back & Front) · mar 2026Ver tudo em Dev (Back & Front) →, na arquitetura batizada de Project Rhythm. Nesse desenho, distributors escrevem num tópico Kafka; block-builders consomem esse tópico para gravar blocos Parquet em object storage; live-stores consomem o mesmo tópico para servir traces recentes. Ingesters e compactors somem do design, substituídos por um scheduler de backend e workers. A Grafana afirma que abandonar o fator de replicação 3 reduz o armazenamento de 3 a 3,5 vezes o volume de traces para uma única cópia. O modo monolítico continua sem depender de Kafka.
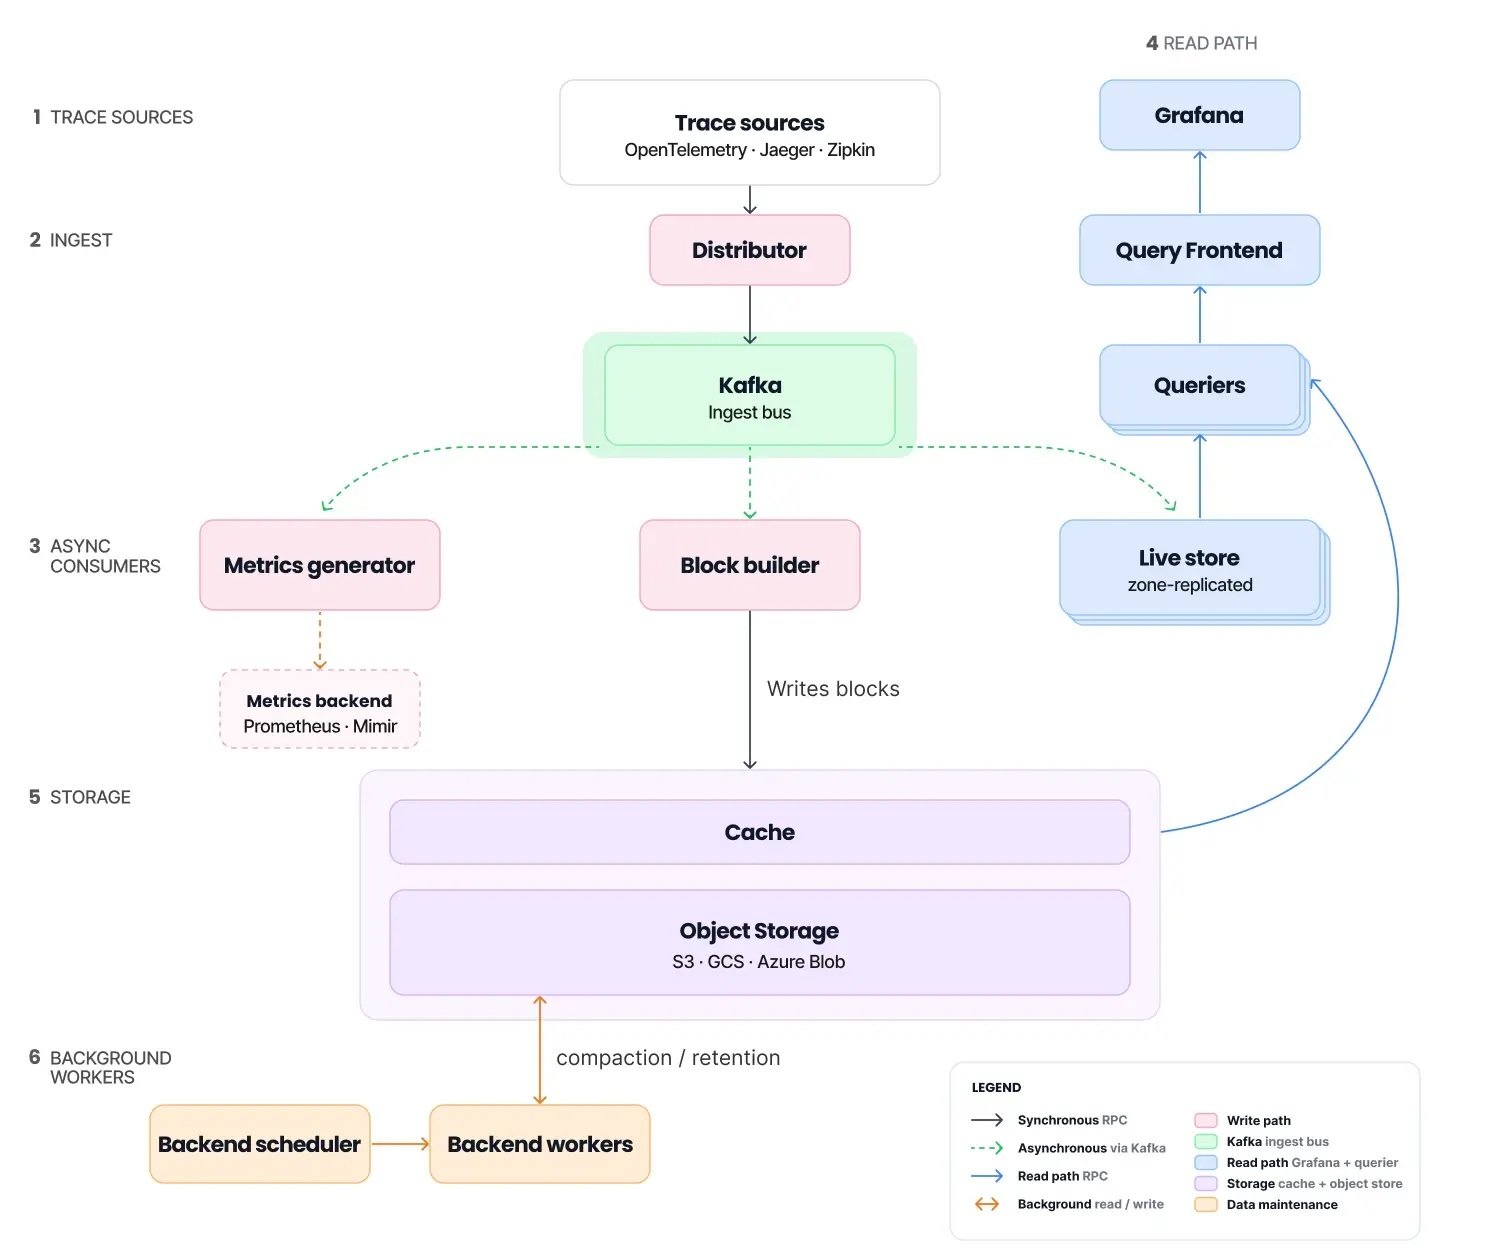
O problema é que o cliente Kafka do Tempo 3.0 só suportava SASL PLAIN sobre conexão sem criptografia, então qualquer broker que exigisse TLS recusava a conexão. Isso inviabilizava usar o Tempo com brokers gerenciados que exigem segurança por padrão. O Tempo 3.1 resolve isso adicionando:
- TLS, incluindo mTLS opcional
SCRAM-SHA-256eSCRAM-SHA-512OAUTHBEARERAWS_MSK_IAM
Também chega a opção client_rack, que habilita leitura com reconhecimento de zona (KIP-392): block-builders, live-stores e metrics-generators passam a ler de uma réplica na própria availability zone, evitando custo de transferência entre zonas. Isso exige brokers com rack ID configurado. Uma nova opção producer_compression aceita none, gzip, snappy, lz4 ou zstd, com snappy como padrão quando não especificado. A Grafana destaca que essa opção, combinada ao TLS, torna o Azure↳Azure76 conteúdosDeploy de Azure Stream Analytics job com CI/CD usando Azure PipelinesDevSecOps · mai 2019Azure – Como criar uma base de dados SQL no Microsoft Azure pronta para ser utilizadaData · abr 2019Azure Static Web Apps com Vue.js e Visual Studio CodeDevSecOps · out 2023Ver tudo em DevSecOps → Event Hubs viável como backend, já que o serviço só aceita gzip. As três mudanças (TLS/SASL, client_rack e producer_compression) vieram de contribuidores da comunidade, não da própria Grafana Labs.
Pra quem mantém um cluster Tempo em produção no Brasil, isso tira uma barreira real: times de segurança corporativos costumam bloquear qualquer serviço que fale com Kafka sem TLS, e brokers gerenciados na AWS ou Azure frequentemente exigem SASL com IAM ou OAuth. Antes do 3.1, isso forçava gambiarras de proxy ou simplesmente travava a adoção do Project Rhythm.
Redação de traces sem listar IDs um por um
A funcionalidade de redação, introduzida no 3.0 através do comando tempo-cli redact, exigia listar manualmente os IDs de trace a apagar. Na prática isso é inviável quando um token ou número de conta vazado aparece espalhado por milhares de traces: não dá pra rastrear e listar cada ocorrência à mão. No 3.1, o comando passa a aceitar uma query TraceQL diretamente, e ganha a flag --dry-run, que conta os matches sem de fato reescrever os blocos.
A Grafana limitou a sintaxe aceita por segurança: só um filtro de spanset, usando comparações de igualdade em atributos resource.* e span.*, combinadas com && e ||. A restrição existe porque a reescrita de blocos não pode ser desfeita depois de aplicada. As flags --start e --end permitem restringir a janela de tempo, o que importa porque o Tempo pausa a compactação do tenant enquanto a redação está em curso.
Um detalhe operacional merece atenção de quem administra o cluster: workers mais antigos ignoram as flags de janela temporal e removem todo match em cada bloco que recebem, sem gerar erro. A recomendação da Grafana é só usar as novas flags depois que scheduler e todos os workers já estiverem rodando 3.1 - caso contrário, a redação pode apagar mais dado do que o pretendido, silenciosamente.
Métricas TraceQL que entendem sampling
As métricas TraceQL, que ficaram geralmente disponíveis no 3.0, recebem três mudanças no 3.1. A mais relevante é o hint experimental with (extrapolate=true), que escala o resultado pela taxa de sampling registrada no tracestate, seguindo as regras de probability sampling da OpenTelemetry. Em sampling de 50%, cada span armazenado passa a contar como dois. Spans sem taxa registrada continuam contando como um, então adoção parcial do sampling probabilístico em alguns serviços não distorce os números de outros.
O hint se aplica a rate(), count_over_time(), sum_over_time(), avg_over_time(), histogram_over_time(), quantile_over_time() e compare(), mas não a min_over_time() nem max_over_time() - faz sentido, já que extremos não se extrapolam por proporção. A funcionalidade exige blocos em vParquet4 ou superior, e lê a taxa de sampling do mesmo jeito que a configuração enable_tracestate_span_multiplier do metrics-generator desde o 3.0, então queries ad-hoc e séries pré-agregadas devem bater.
As outras duas mudanças são mais diretas:
- Operadores
+,-,*e/agora funcionam entre queries de métricas e escalares, permitindo calcular uma taxa de erro numa única query, sem pós-processamento no painel. - O caminho de fetch somente-span, experimental no 3.0, vira padrão para blocos
vParquet5. Em um teste já aquecido, a query{ } | rate()terminou em pouco mais da metade do tempo anterior.
Pra quem opera observabilidade com sampling agressivo (comum em serviços de alto volume para controlar custo de armazenamento), isso resolve um problema sutil: métricas calculadas sobre traces amostrados sempre subestimam a realidade, e até agora a correção ficava por conta de cada time, manualmente, fora da ferramenta.
Diff de traces pensado para LLMs
O Tempo 3.1 também traz um recurso experimental de pruning de spans no endpoint trace-by-ID v2, que colapsa spans-folha semelhantes em um único span-resumo carregando estatísticas de contagem e duração. O mesmo endpoint ganha filtragem via TraceQL. Chega também um endpoint experimental, POST /api/v2/traces/diff, que compara dois traces e pode retornar um resumo compacto em vez de um patch span a span.
Esse endpoint de diff é exposto via gcx, tempo-cli e pelo Tempo MCP↳MCP7 conteúdosArquitetura de Sistemas Cognitivos: Integração de RAG, MCP e LLMs no Ecossistema .NETDev (Back & Front) · abr 2026MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025Agentes de IA com LLMs de Código Aberto: Integração Prática com o Model Context Protocol (MCP)AI · ago 2025Ver tudo em AI → server - e a Grafana é explícita sobre o motivo: o payload menor ajuda investigações conduzidas por LLMs, onde cada token de contexto custa latência e dinheiro. É um sinal do momento: ferramentas de observabilidade começam a desenhar endpoints pensando em agentes de IA como consumidor, não só em dashboards para humanos.
O metrics-generator ganha ainda um label unmatched_span_kind em arestas de service-graph expiradas, suporte ao atributo db.system.name (renomeado pela OpenTelemetry) e buffers de label pooled que, segundo a Grafana, zeram as alocações por span em seus benchmarks internos de service-graph.
O que fica em aberto
Tanto a redação por query quanto o hint de extrapolação de sampling e o diff de traces são marcados como experimentais pela própria Grafana - ou seja, sujeitos a mudança de API antes de virarem estáveis. Quem já roda Project Rhythm em produção também precisa planejar o upgrade coordenado de scheduler e workers antes de usar as novas flags de redação, dado o comportamento silencioso descrito pela própria documentação. A migração de vParquet4 para vParquet5 como padrão também merece teste em ambiente de homologação antes de virar produção, já que muda o formato de armazenamento que sustenta todo o resto.
Fonte: InfoQ
Este artigo foi escrito por Redação iMasters. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Google Antigravity SDK ganha suporte a modelos locais para rodar agentes sem enviar código à nuvem
O Antigravity SDK agora roda modelos de IA direto na máquina do desenvolvedor e só manda para a nuvem o que é estritamente necessário. Em um teste da própria Google, 97,2% dos tokens ficaram no dispositivo e nenhum código-fonte saiu do computador.