DeepSeek atualiza V4.1 Flash e abre framework de inferência para cortar custo de IA


A empresa chinesa lançou o V4.1 Flash-1017 com ganhos em benchmarks de código e abriu o DeepInfer, o framework de inferência que sustenta seus serviços em produção.

V4.1 Flash-1017: o que o DeepSeek corrigiu nos benchmarks
Em 17 de outubro, o DeepSeek lançou o V4.1-Flash-1017, uma atualização do seu modelo V4.1 Flash focada em completar tarefas mais rápido e gerar respostas mais curtas. Segundo a TechNode, os benchmarks publicados pela própria empresa mostram ganhos em coding e tarefas agênticas.
Dois números resumem o salto:
| Benchmark | Versão anterior | V4.1 Flash-1017 |
|---|---|---|
| Terminal-Bench 4.0 | 31.2 | 42.3 |
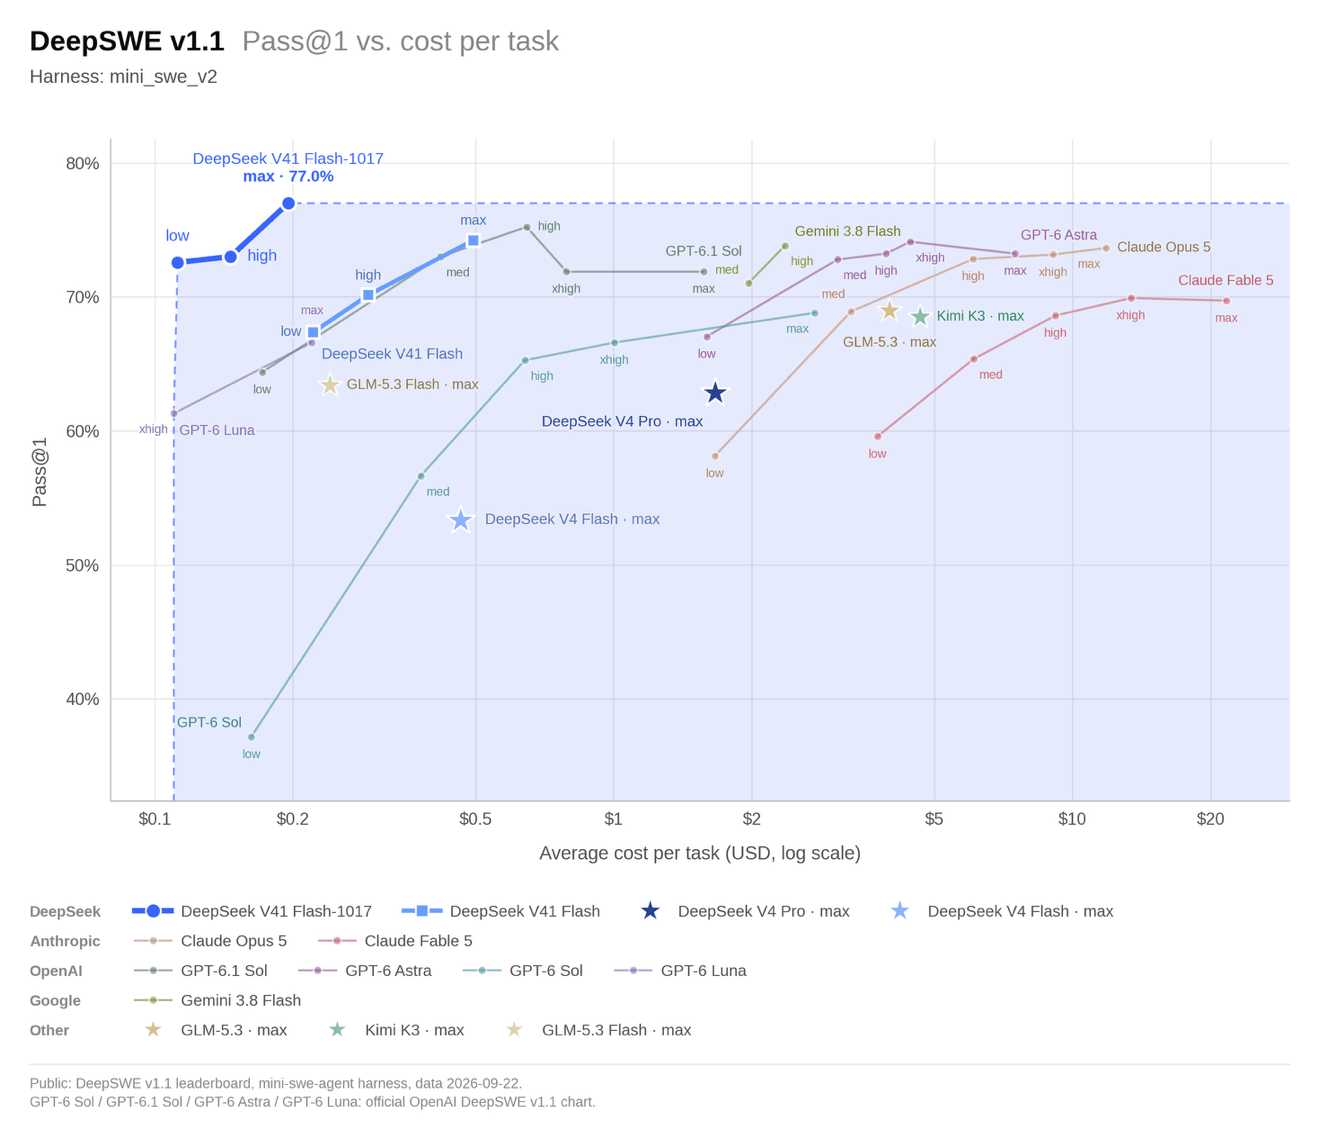
| DeepSWE v1.1 | 74.2 | 77.0 |
A atualização foi otimizada para rodar em frameworks de agentes como DeepSeek Harness, Tencent CodeBuddy e WorkBuddy. É importante frisar: são números do próprio fabricante, medidos com frameworks e configurações de avaliação específicas, o que não garante desempenho equivalente em qualquer aplicação do mundo real.
Quanto custa rodar essa inteligência
O ponto central do anúncio não é só acurácia, é custo por tarefa. Um gráfico de custo-benefício divulgado pelo DeepSeek para o benchmark DeepSWE v1.1 mostra o V4.1 Flash-1017 atingindo 77% de Pass@1 gastando cerca de 0,20 dólar por tarefa, superando modelos concorrentes que custam bem mais para rodar. Em configurações mais econômicas, de 0,11 a 0,14 dólar por tarefa, o modelo ainda entrega entre 72% e 73%.
Um sinal independente veio do Agent Arena, leaderboard da Arena. De acordo com reportagem do ITHome publicada em 20 de outubro e citada pela TechNode, o modelo atualizado ficou em primeiro lugar entre os modelos de peso aberto e em 11º lugar geral, com base em 7.498 sessões de uso real. O custo mediano por tarefa ficou perto de 0,18 dólar, com páginas diferentes do leaderboard mostrando valores entre 0,18 e 0,19 dólar.
Em resumo: o DeepSeek está disputando a briga de custo por token em dois fronts ao mesmo tempo, o modelo fica mais eficiente e a infraestrutura que o serve também.
DeepInfer: abrindo a caixa-preta da inferência
Em 20 de outubro, três dias depois do lançamento do modelo, o DeepSeek liberou o DeepInfer, o framework interno que, segundo a empresa, roda seus serviços de produção em larga escala. Junto veio o deepseek-recipe, uma biblioteca para processar requisições de API, preparar prompts e fazer parsing de saídas.
Frameworks de inferência são a parte menos visível da conta de IA↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI →, mas decidem latência, throughput e o hardware necessário para atender usuários. Segundo o README e a documentação de deployment do projeto, o DeepInfer inclui:
- kernels de computação otimizados;
- agendamento assíncrono de requisições;
- suporte a inferência distribuída e a speculative decoding.
O suporte de hardware hoje cobre GPUs Nvidia SM100 e NPUs Huawei Ascend 950, com o DeepSeek V4.1 Flash listado como modelo suportado. É um detalhe que pesa: Ascend ainda é hardware de acesso bem mais restrito fora da China, então quem está fora desse ecossistema depende essencialmente da compatibilidade com Nvidia.
A própria documentação do DeepSeek é honesta sobre o que falta: um sistema de KV-cache completo, disaggregation entre prefill e decode, e balanceamento de carga entre réplicas paralelas de dados ainda não estão totalmente cobertos pelo release, embora a maior parte da funcionalidade de disaggregation já esteja implementada. Ou seja, não é um stack de inferência pronto para apontar e rodar: é a base de produção do DeepSeek, aberta, mas que exige engenharia adicional para virar serviço completo.
O pacote de eficiência que vem desde setembro
A conta de custo do DeepSeek não começou agora. No lançamento do V4.1 Flash em setembro, a empresa já reportava ter reduzido a necessidade de memória de KV-cache para um quarto e o uso de armazenamento em SSD para um oitavo da geração anterior. A API também oferece tarifas fora de pico pela metade do preço do horário cheio.
Em outubro, o DeepSeek abriu suas APIs de Search e Fetch para desenvolvedores, cobrando 5 yuans a cada mil requisições bem-sucedidas. Chamadas feitas por integrações da API do DeepSeek com Claude Code e Codex estão temporariamente gratuitas, com cobrança por requisição programada para começar em 1º de novembro.
O que muda pra quem roda modelos em produção no Brasil
Para quem avalia custo de inferência em dólar e converte para real, essa combinação de modelo mais barato por tarefa e framework de serving aberto é o tipo de anúncio que vale testar antes de comprometer orçamento de infra. O ganho de Terminal-Bench e DeepSWE interessa direto a quem usa agentes de código em produção, mas o número que realmente move a planilha é o custo por tarefa, não o score isolado.
O DeepInfer não resolve tudo sozinho. Times que já operam serving próprio com ferramentas como vLLM ou SGLang vão olhar para os kernels otimizados e o speculative decoding como peças a avaliar, não como substituto imediato do stack atual, já que falta KV-cache completo e balanceamento de carga prontos. A dependência de GPUs Nvidia SM100 também limita quem roda hardware mais antigo ou mix de provedores cloud.
O que fica em aberto é justamente o que a TechNode aponta: os números são do próprio DeepSeek, com frameworks e configurações escolhidos pela empresa. Se o ganho de eficiência se sustenta em workloads reais, com deployment e manutenção de times de terceiros, é algo que só a adoção em produção vai responder nos próximos meses.
Fonte: TechNode (China)
Este artigo foi escrito por Redação iMasters. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Google abre o código do TorchTPU, backend nativo do PyTorch para TPUs
O repositório google-pytorch/torch_tpu implementa kernels ATen para rodar PyTorch direto em TPUs, mas o compilador XLA continua por baixo do capô.