O Auto Router, em beta público na AI Gateway, classifica cada requisição por complexidade, ambiguidade e risco antes de escolher o modelo. A própria Cloudflare publicou um benchmark em que seu roteador perde para modelos mais caros em algumas tarefas.

O que é o Auto Router
A Cloudflare colocou em beta público o Auto Router, recurso da AI↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI → Gateway que escolhe automaticamente qual modelo de linguagem atende cada requisição. Basta apontar o parâmetro de modelo para cloudflare/auto em vez de fixar um provedor específico. Um classificador decide, requisição a requisição, qual modelo da pool disponível tem a melhor relação entre qualidade esperada e custo.
A notícia, publicada pela InfoQ em 26 de outubro, chama atenção para um detalhe pouco comum em anúncios do tipo: a própria Cloudflare publicou um benchmark em que seu roteador perde para um modelo mais caro em algumas tarefas. É esse número, mais do que o lançamento em si, que interessa a quem roda agentes em produção e precisa decidir se vale trocar previsibilidade de modelo por economia de custo.
Como funciona o roteamento em duas etapas
O AI Gateway processa cada requisição em dois estágios. No primeiro, monta um pool de candidatos: filtra modelos que não conseguem atender o formato pedido e aplica credenciais, configuração de billing, controle de acesso e limites de gasto configurados pela conta.
No segundo estágio entra o classificador, um modelo multi-cabeça rodando no Workers AI sobre as GPUs de borda da Cloudflare. Ele atribui probabilidades entre 14 categorias de tarefa e nota a requisição de 1 a 5 em quatro dimensões: complexidade, ambiguidade, stakes (o quanto um erro custa) e dependência do contexto anterior. Uma matriz de pontuação combina essas notas com resultados de benchmark sob a fórmula declarada pela empresa: utilidade igual à qualidade esperada menos uma penalidade de custo adaptativa.
Um ponto técnico importa para quem for integrar isso: o classificador só olha os turnos mais recentes da conversa, com um limite de 8 KiB de texto. Quanto mais difícil a tarefa, menos peso o preço recebe na decisão final.
O benchmark que a própria Cloudflare perde
A Cloudflare rodou 97 tarefas, com três amostras por modelo e 10.000 reamostragens bootstrap, comparando o Auto Router contra dois modelos usados como linha de base: Opus 5.5 e GPT-6 Sol. O resultado, nas palavras do próprio anúncio: dez pontos de confiabilidade a mais por aproximadamente um terço do gasto, a favor dos modelos de referência quando comparados ao roteador.
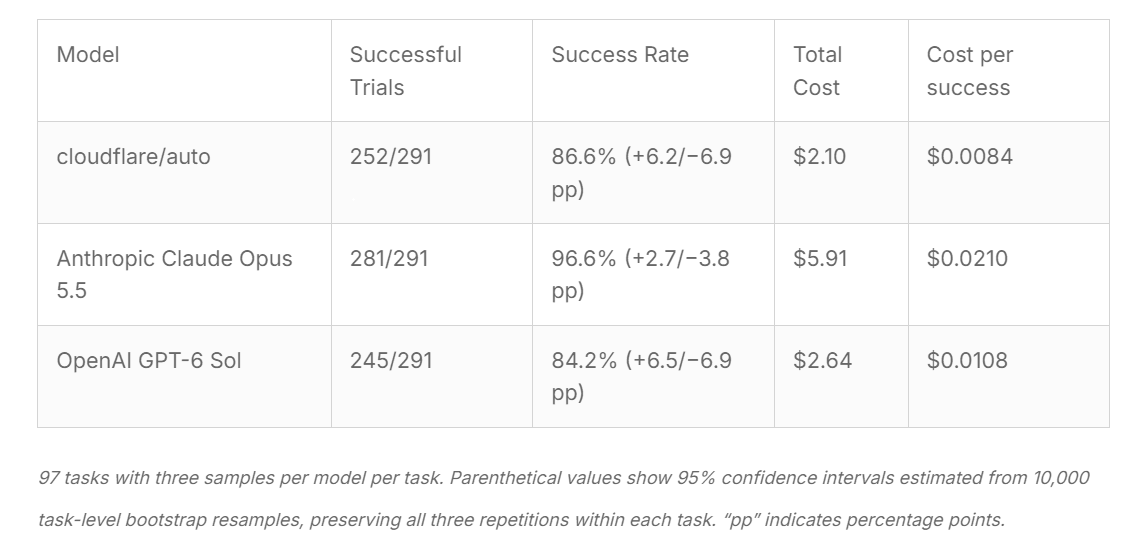
Ou seja: o Auto Router é mais barato, mas entrega menos confiabilidade do que simplesmente fixar um modelo caro. Jacques B, CTO que trabalha com engenharia de agentes, resumiu o trade-off num post no LinkedIn citado pela própria Cloudflare:
Um modelo mais barato não é uma economia tão grande se alguém precisar gastar mais uma hora corrigindo o resultado.
A cheaper model isn't much of a saving if someone has to spend another hour fixing the result.Jacques B, CTO em engenharia de agentes
Para quem decide arquitetura de custo de LLM, isso é informação mais honesta do que a maioria dos anúncios de roteamento costuma dar: a equipe sabe exatamente de que lado da curva está escolhendo ficar, em vez de comprar a promessa de 'mesma qualidade, menos custo' sem verificação.
O ponto cego: avaliar risco só pelos turnos recentes
A parte mais criticada do desenho técnico é justamente a que mais interessa a quem constrói agentes com ações reais (pagamento, reembolso, alteração de dados sensíveis). Como o classificador só enxerga os turnos mais recentes, uma instrução curta de confirmação pode, na prática, mascarar o risco real da ação.
Igor Pyrin, tech lead↳Liderança técnica5 conteúdosLiderança técnica: a arte de inspirar desenvolvedores e gerar transformações 🚀Gestão Dev & TI · mai 2024Full Cycle lança pós-graduação que capacita devs para cargos de liderança técnicaDev (Back & Front) · mar 2024De Dev a Tech Leader: caminhos para se tornar um Tech Leader excepcionalGestão Dev & TI · ago 2024Ver tudo em Gestão Dev & TI → com experiência em plataformas bancárias e de saúde, apontou o problema:
Numa sessão longa de agente, o usuário pode dizer 'isto é um reembolso de cliente' no início e depois só dizer 'pode seguir'. Eu manteria um rótulo de risco definido pela aplicação ao longo dos turnos e o usaria para decidir se a requisição pode sequer usar o cloudflare/auto. Uma instrução final curta não deveria reduzir silenciosamente a classificação de risco da ação subjacente. O turno que efetiva a ação é o turno que parece mais barato na conversa.
In a long agent session, the user may say 'this is a customer refund' early and later just say 'go ahead.' I'd carry an application-owned risk label across turns and use it to decide whether the request can use cloudflare/auto at all. A short final instruction should not silently lower the risk classification of the underlying action. The turn that commits the action is the cheapest-looking turn in the conversation.Igor Pyrin, tech lead
Essa é a leitura prática mais importante da matéria para quem vai habilitar cloudflare/auto em produção: não delegar a classificação de risco inteira ao roteador em fluxos onde a ação final tem consequência financeira, médica ou legal. Um rótulo de risco mantido pela própria aplicação, e não recalculado a cada turno pelo classificador, parece a defesa mais simples contra esse ponto cego.
Auditoria e controle do pool por header
A Cloudflare documentou dois mecanismos que ajudam a mitigar parte do problema acima. A resposta de cada requisição roteada traz os headers cf-aig-routed-model e cf-aig-routing-reason, com valores como cost_optimal_within_pool e pinned_by_turn, o que torna a escolha auditável depois do fato.
Também é possível restringir o pool de candidatos por requisição usando os headers cf-aig-allowed-models e cf-aig-allowed-providers. O que ainda falta, e foi pedido por Adam Natad na própria thread de lançamento, é a possibilidade de salvar esses pools como perfis de roteamento reutilizáveis, em vez de declarar os headers a cada chamada.
O pool de modelos muda, e isso afeta quem reproduzir o benchmark
Um detalhe que qualquer time tentando reproduzir os números da Cloudflare precisa checar antes de confiar neles: o pool padrão hoje lista Claude Opus 5, Sonnet 5 e Fable 5, ao lado de GPT-5.6 Luna, Sol e Terra, e Grok 4.5. Os dois modelos usados como linha de base no benchmark, Opus 5.5 e GPT-6 Sol, não estão no pool padrão: eles só ficam acessíveis via opt-in, usando os headers de restrição citados acima.
A Cloudflare afirma que o pool "pode mudar ao longo do tempo", então pode ser efeito colateral da evolução dos modelos disponíveis, não uma decisão deliberada. Mas isso significa que um time que rodar o mesmo teste hoje pode obter resultado diferente do publicado, simplesmente porque o roteador está escolhendo entre um conjunto de modelos diferente do usado na comparação original.
Custo de sessão: cache de prompt e penalidade de troca
Há um custo extra que não aparece no benchmark principal: gerenciamento de sessão. Sem um ID de sessão, requisições da mesma conversa podem cair em modelos diferentes a cada chamada e perder a possibilidade de reaproveitar o cache de prompt.
A Cloudflare aplica ainda uma penalidade de troca que cresce com o tamanho do contexto, porque um modelo novo pode ter que refazer tokens de raciocínio cobrados a preço de saída. Na prática, isso significa que, em conversas longas com múltiplos turnos, manter o mesmo modelo ao longo da sessão (em vez de deixar o roteador trocar a cada mensagem) costuma sair mais barato do que a leitura rápida do anúncio sugere.
O debate sobre a unidade de custo
No Reddit, o comentarista reachjalil rejeitou a premissa do produto, argumentando que roteadores automáticos acabam custando mais por entregar menos inteligência, já que um modelo mais capaz tende a sair mais barato quando o que importa é o resultado final. O usuário yangqi respondeu que a unidade de comparação correta não é a requisição, e sim a tarefa completa.
Na réplica, reachjalil tocou em algo que a própria Cloudflare reconhece: classificar a dificuldade de uma tarefa é, em si, um trabalho mais fácil para um modelo grande, e os pesos do classificador ficam desatualizados rápido, em suas palavras, "especialmente com os modelos mudando o tempo todo". De fato, o anúncio da Cloudflare confirma que os pesos de roteamento vêm de resultados de benchmark e que novos modelos precisam ser adicionados manualmente à matriz de pontuação, sem atualização automática.
O que ainda falta
O Auto Router é gratuito durante o beta, sem preço definido para depois. WebSockets não são suportados, então só funciona com Chat Completions e a Responses API, o que pode excluir alguns fluxos de streaming bidirecional já em produção.
No roadmap está o cloudflare/auto-best, variante que usa o mesmo classificador e o mesmo pool, mas otimiza só pela maior qualidade esperada, sem considerar custo. Para quem decide adotar algum dos dois hoje, o recado prático desta rodada de críticas é claro: usar o roteador automático para tráfego de baixo risco e manter modelo fixo, com rótulo de risco definido pela própria aplicação, em qualquer fluxo onde a ação final tenha consequência real.
Fonte: InfoQ
Este artigo foi escrito por Redação iMasters. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Vulnerabilidade crítica no Brotli vira HTTP2Shell e atinge Node.js, Python, Bun, Envoy e Istio
A falha batizada de Node2Shell, que afetava só o Node.js, se revelou um problema de cadeia de suprimentos muito maior: qualquer runtime ou biblioteca que empacote o decodificador Brotli do Google pode estar vulnerável.