A Liquid AI aplicou decodificação especulativa a um modelo de visão-linguagem de 3B parâmetros, prometendo inferência local mais rápida sem perda de qualidade e com apenas 8,9% de peso extra.

A Liquid AI↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI → publicou em 24 de setembro de 2026, no blog da Hugging Face, um modelo auxiliar chamado LFM2.5-VL-DSpark, criado para acelerar a inferência do seu modelo de visão-linguagem (VLM) LFM2.5-VL-3B. A técnica por trás disso não é nova (decodificação especulativa já existe há alguns anos para LLMs de texto), mas a aplicação a um modelo multimodal, que processa imagem e texto no mesmo pipeline, é o que torna esse release relevante para quem constrói produtos com VLMs open source↳Open source71 conteúdosComo o Open Source Está Liberando o Poder da Automação para TodosDev (Back & Front) · out 2025Código aberto: programadores criam software da NASA sem saberDev (Back & Front) · abr 2021N8N: O que é a ferramenta open source que está revolucionando a automação em TI?Dev (Back & Front) · dez 2025Ver tudo em Dev (Back & Front) → rodando fora de datacenter.
O problema que a decodificação especulativa resolve
Modelos de linguagem geram token a token, de forma sequencial e autoregressiva. Cada token novo depende do anterior, o que trava a geração numa cadência lenta mesmo em GPUs potentes, porque o gargalo é memória e não compute puro. A decodificação especulativa ataca isso com um truque simples: um modelo pequeno e barato (o "drafter") propõe um bloco de vários tokens candidatos de uma vez, e o modelo grande (o "target") verifica todos em paralelo numa única passada. Quando o drafter acerta, você ganha vários tokens pelo preço de uma verificação; quando erra, o target descarta o que estiver errado e segue normalmente. O ponto crítico, que a Liquid AI reforça no anúncio, é que o processo é exato: a saída greedy final é idêntica à do modelo target sozinho, então não há perda de qualidade, só ganho de velocidade.
O que muda no caso do LFM2.5-VL-DSpark é estender essa ideia para entrada multimodal. Segundo a Liquid AI, o drafter de visão usa a mesma arquitetura dos drafters de texto da linha LFM2.5-DSpark (lançados em agosto de 2026): ele captura os hidden states do modelo target em um conjunto fixo de camadas e usa isso para prever um bloco de k tokens candidatos. A jogada de engenharia é que patches de imagem e tokens de texto são projetados para uma representação compartilhada antes dessas camadas, então o drafter enxerga vetores de hidden state com a mesma dimensionalidade independentemente de a entrada ser pixel ou palavra. Na prática, isso significa que o algoritmo de inferência especulativa não precisou de nenhuma adaptação para lidar com imagem: o mesmo código que funciona para texto puro funciona aqui.
Arquitetura e custo de memória
O drafter é descrito como um modelo attention-only de 4 camadas, com block size de 8 ou 9 tokens, escolhido depois de testes de ablação comparando 3, 4 e 5 camadas. A Liquid AI treinou por 10 épocas numa mistura de dados de SFT vision-language ponderada para as cargas de trabalho que esperam que o modelo atenda, medindo a taxa de aceitação do drafter a cada época até os ganhos começarem a diminuir.
O resultado final tem cerca de 280 milhões de parâmetros, distribuídos assim: 193M na pilha de decoder (4 camadas), 21M na projeção de hidden state, 65,5M na "Markov head" e uma fração residual em normalizações e na confidence head. Isso representa um acréscimo de 8,9% sobre os 3B parâmetros do modelo alvo LFM2.5-VL-3B. É um número que vale anotar: para rodar esse setup você precisa ter memória (VRAM ou RAM unificada) suficiente para os dois modelos simultaneamente, não só o target.
Os números de speedup, por plataforma
A avaliação foi feita com block size 8 em seis tarefas visuais diferentes (VQA geral, VQA de texto, legendagem de imagem, VQA de gráficos, raciocínio complexo e conversa multi-turn), seguindo o benchmark MMSpec. Os resultados divulgados pela Liquid AI:
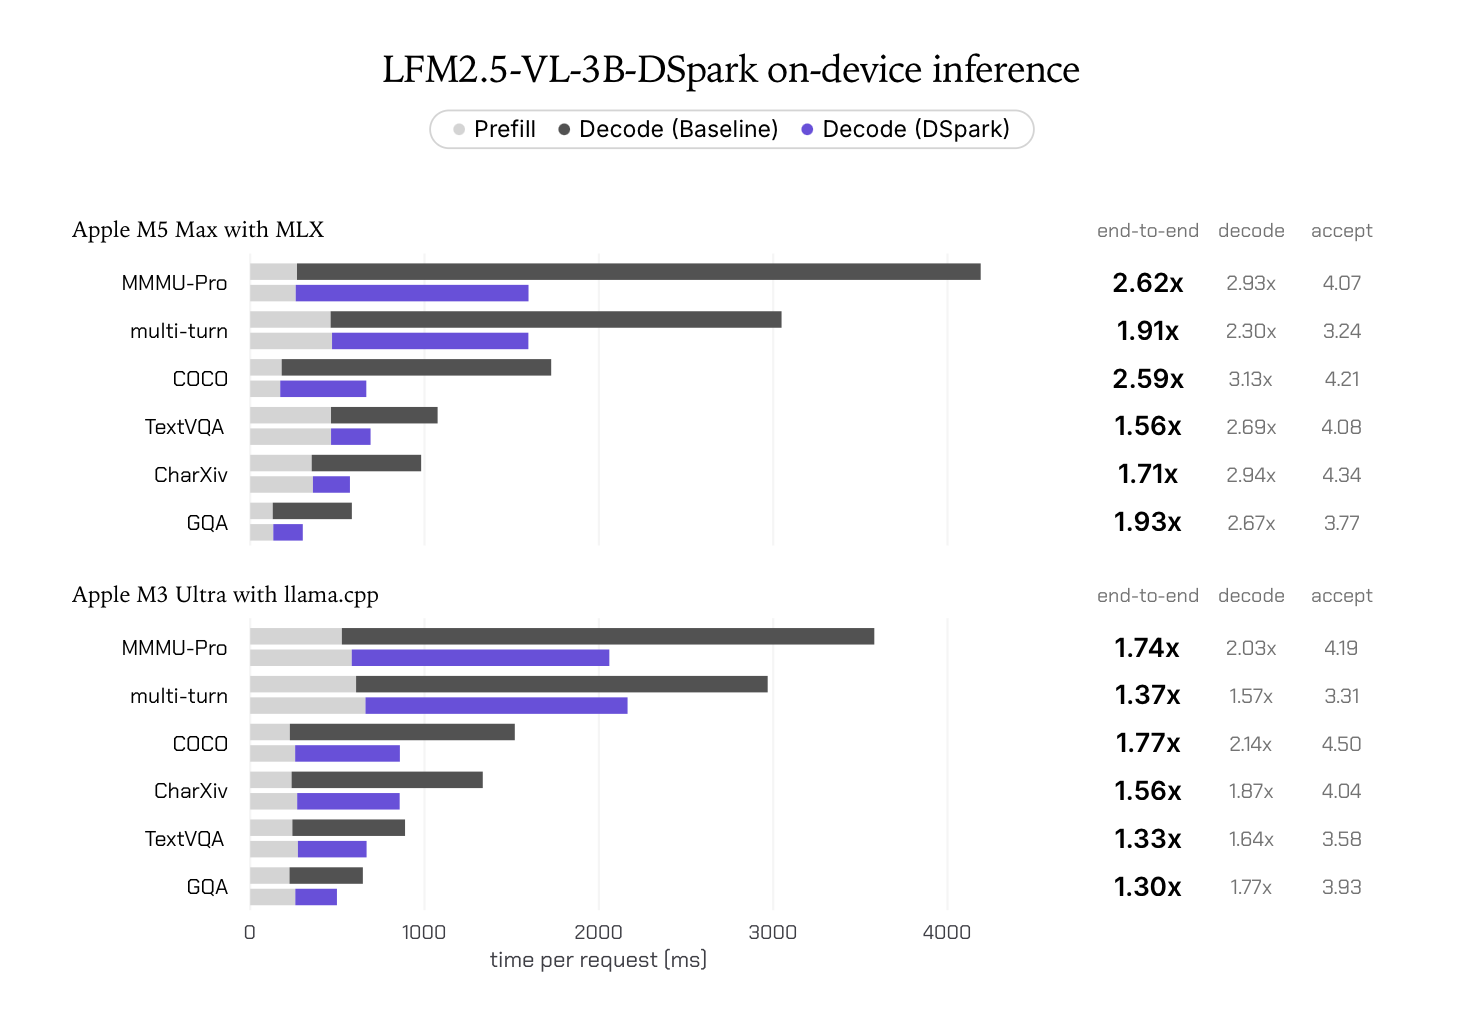
- MLX em Apple M5 Max: decode de 2,30x a 3,13x mais rápido; end-to-end de 1,56x a 2,62x.
- llama.cpp em Apple M3 Ultra: decode de 1,57x a 2,14x; end-to-end de 1,30x a 1,77x.
- H100 (SGLang): decode de até 2,66x; end-to-end de até 2,27x.
Repare que o ganho de decode é sempre maior que o ganho end-to-end, e isso não é acidente: é o próprio limite estrutural da técnica, que a Liquid AI trata na seção de limitações do post.
Onde a técnica não ajuda (e por que isso importa mais em edge)
A decodificação especulativa acelera só a fase de decode, token a token. Ela não toca no prefill (processar o prompt inicial) nem na codificação de imagem pelo vision encoder, que em um VLM soma centenas de tokens visuais processados antes mesmo do primeiro token de saída ser gerado. Em GPUs de datacenter como a H100, o prefill costuma ser rápido o suficiente para não dominar a latência total. Em dispositivos edge, com bem menos poder de compute, o prefill (incluindo a codificação da imagem) passa a consumir uma fatia maior do tempo total de resposta, e é isso que os próprios números de time-to-first-token no Apple Silicon evidenciam.
A Liquid AI chama isso pelo nome certo: lei de Amdahl. Se metade do seu tempo de resposta é gasto em prefill e vision encoding, nenhum speedup de decode, por maior que seja, vai fazer a resposta total ficar mais que duas vezes mais rápida. Isso explica por que aplicações que processam imagens grandes ou prompts longos (documentos escaneados, screenshots de alta resolução, contexto multi-turn extenso) tendem a sentir menos o ganho do DSpark do que aplicações de resposta curta com pouco contexto visual, como um chatbot de suporte que analisa um print pequeno e responde em uma ou duas frases.
Como rodar na prática
O suporte de dia um cobre três runtimes bem conhecidos de quem já roda LLMs localmente. Com SGLang, é preciso um build com suporte a DSpark para modelos LFM2 (PR #40651 do projeto) e o comando aponta o target e o drafter separadamente:
python -m sglang.launch_server \
 --model-path LiquidAI/LFM2.5-VL-3B \
 --speculative-algorithm DSPARK \
 --speculative-draft-model-path LiquidAI/LFM2.5-VL-3B-DSpark \
 --speculative-draft-attention-backend flashinfer \
 --speculative-dspark-block-size 9 \
 --disable-radix-cache
A baseline para comparação é o mesmo comando sem as três flags --speculative-*. Com llama.cpp (build da PR#29339), o comando fica assim:
llama-server -m models/LFM2.5-VL-3B-F16.gguf \
 --mmproj models/mmproj-LFM2.5-VL-3B-F16.gguf \
 -md LFM2.5-2.6B-DSpark-F16.gguf \
 --spec-type draft-dspark --spec-draft-n-max 8 --spec-draft-n-min 0 \
 -fa on -ngl 99 -c 8192
E com MLX-VLM (build da PR#2280), a integração é mais direta:
mlx_vlm.server --model LiquidAI/LFM2.5-VL-3B --draft-model LiquidAI/LFM2.5-VL-3B-DSparkEm todos os casos o block size é lido da configuração do drafter, e cada resposta reporta draft_n / draft_n_accepted, o que dá visibilidade real da taxa de aceitação em produção, útil para decidir se vale manter a especulação ligada para uma carga de trabalho específica ou desligá-la quando o ganho não compensar a memória extra.
O que muda pra quem constrói
Para quem já roda VLMs abertos localmente (em servidor próprio, edge device ou aplicação desktop com MLX em Apple Silicon), o DSpark é um ganho de latência sem trade-off de qualidade, já que a verificação é exata. O custo real é memória: 8,9% a mais de parâmetros residentes, o que em cenários de VRAM apertada pode ser a diferença entre caber ou não caber no hardware disponível. Vale testar em quais das seis categorias de tarefa do MMSpec seu caso de uso se encaixa melhor, porque a variação de ganho entre tarefas foi grande (de 1,30x a 2,62x end-to-end, dependendo da plataforma e da tarefa).
O recorte mais importante para quem decide adotar isso agora é: se sua aplicação processa imagens grandes ou prompts longos antes de gerar pouca saída, o ganho prático tende a ser modesto, porque o gargalo está no prefill, não no decode. Já para aplicações que fazem muitas rodadas de geração relativamente longa a partir de uma imagem pequena (descrição de UI, leitura de gráfico, assistente multimodal conversacional), o ganho de decode se traduz quase de forma direta em latência percebida menor pelo usuário final, algo que pesa bastante em produtos rodando no Brasil onde custo de GPU na nuvem ainda é um fator decisivo para viabilizar IA aplicada em produção.
Fonte: Hugging Face Blog
Este artigo foi escrito por Alan Andrade, colunista de inteligência artificial. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Supabase MCP Server: o que um agente de IA pode (e não pode) executar no Postgres
A documentação oficial do Supabase MCP Server detalha as ferramentas que ele expõe a agentes de IA, do list_tables ao apply_migration. Veja o roteiro que separaria leitura segura de escrita destrutiva antes de plugar um agente no banco de produção.