Google reproduz o treino do OLMo 3 7B em TPUs com MaxText e expõe bugs que só aparecem em rodadas longas
A equipe de TPU do Google Cloud recriou do zero o pré-treino do OLMo 3 7B da AI2 usando MaxText, e o processo revelou dois bugs que fariam qualquer time de ML jurar ter batido a referência sem ter batido nada.

O Google Developers Blog publicou nesta quinta-feira (24/9) um estudo de caso detalhado sobre a reprodução completa do pré-treino do OLMo 3 7B, modelo aberto da Allen Institute for AI↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI → (AI2), usando o MaxText, framework de treino em JAX/XLA para TPUs. Não é um anúncio de produto: é um relato técnico de semanas de treino real, com os números, os gráficos e, principalmente, os dois bugs que o time encontrou no caminho. Para quem constrói infraestrutura de ML, é material raro: a maioria dos posts de "reprodução de modelo" mostra só a curva de loss batendo. Este mostra também onde ela quase mentiu.
A escolha do OLMo 3 não foi acidental. É um modelo 7B moderno, treinado em escala de produção real (cerca de 5,93 trilhões de tokens em 1,41 milhão de passos), com dados, código, configurações, checkpoints e logs de treino públicos, incluindo uma run de referência publicada no Weights & Biases. Isso deu ao time do Google Cloud↳Google Cloud13 conteúdosPrograma da Google Cloud no Brasil projeta formar de forma gratuita 30 mil universitáriosDev (Back & Front) · mar 2026Google Cloud OnBoard capacita estudantes e desenvolvedores de TIGestão Dev & TI · mai 2019Desenvolvedores poderão participar de treinamento gratuito do Google CloudGestão Dev & TI · mai 2019Ver tudo em DevSecOps → algo raro em pesquisa aberta: uma referência independente em PyTorch/GPU contra a qual testar se o MaxText, rodando em TPU, reproduz não só a arquitetura, mas o comportamento de treino inteiro.
Da PyTorch para JAX, com prova de paridade
A arquitetura do OLMo 3 tem escolhas fora do padrão: um bloco de "reordered norm", QK-norm e uma proporção 3:1 entre atenção em janela deslizante e atenção global. Migrar isso de PyTorch para JAX e portar para o MaxText não bastava rodar e comparar a loss no final; o time construiu um checkpoint de conversão com verificação de paridade de logits. O checkpoint step-0 convertido bateu a referência da HuggingFace em KL ≈ 1,5e-3, o que os autores chamam de "ruído de piso entre o mesmo modelo em frameworks diferentes", e, em contexto completo de 8192 tokens em bfloat16, os dois concordaram no token top-1 em 98,75% dos casos.
Esse tipo de verificação é o que separa uma migração de framework confiável de uma que só parece funcionar. Para quem já tentou portar um modelo entre PyTorch e JAX, ou mesmo entre versões de uma mesma lib, a lição é direta: comparar apenas a saída final de um forward pass isolado não garante nada sobre o comportamento em produção. É preciso um teste de paridade que capture divergência numérica cedo, antes de gastar semanas de TPU treinando em cima de um bug de conversão.
O bug que parecia vitória
A parte mais interessante do post não é a arquitetura, é a demonstração de que loss de treino sozinha não prova convergência. A partir de cerca de 900 mil passos, a loss de treino do MaxText começou a ficar sistematicamente abaixo da curva publicada pela AI2, e nunca mais cruzou de volta. Perto de 1,25 milhão de passos, a diferença chegou a -0,25 em janelas de algumas centenas de passos. Olhando só esse gráfico, a conclusão óbvia seria: MaxText superou a referência.
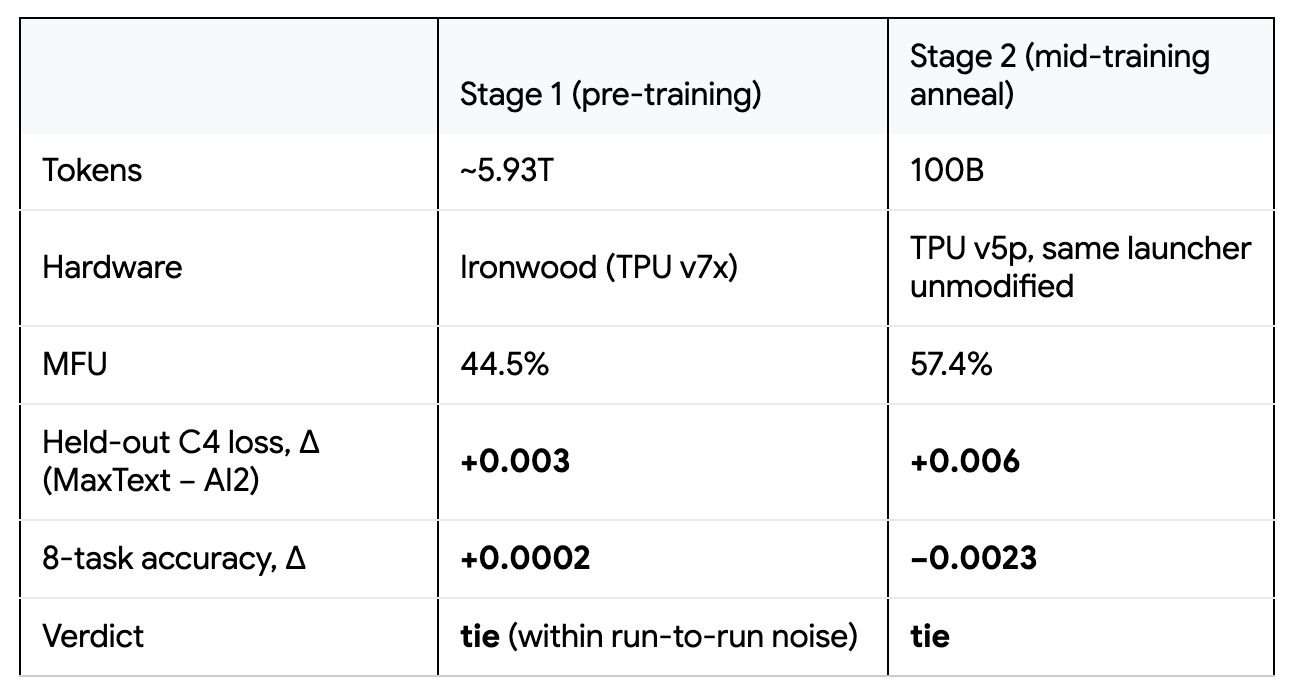
Não superou. A loss em dados held-out (C4 não visto no treino) ficou empatada nos checkpoints ao redor desse trecho (delta de -0,004 em 1 milhão de passos, +0,003 no fim do estágio 1), e a acurácia em oito tarefas downstream (MMLU, HellaSwag, ARC, OpenBookQA, PIQA, BoolQ, WinoGrande) levemente favoreceu a run da AI2 no mesmo ponto. A loss de treino caindo sem a generalização se mover é a assinatura clássica de memorização: o modelo estava vendo as mesmas sequências mais de uma vez.
A causa foi um bug de double-sharding no carregador de dados Grain. O loader do OLMo no MaxText passava ShardOptions(shard_index, shard_count) para o DataLoader do Grain enquanto o sampler de índices já fazia seu próprio sharding internamente. O resultado: com shard_count=32, o cursor de dados avançava 32 vezes mais rápido que o esperado, transformando o que deveria ser uma época limpa em uma reamostragem com reposição, aproximadamente Poisson(≈1): 37% do corpus nunca foi visto, 37% foi visto uma vez, 26% foi visto duas vezes ou mais. O orçamento total de tokens continuou correto (por isso a loss global ainda acompanhava a AI2), mas as repetições localizadas infladam a métrica de treino exatamente onde ocorriam.
A correção foi uma linha: trocar para grain.sharding.NoSharding() e deixar o sampler ser o único responsável pelo sharding. Encontrar essa linha exigiu um harness de A/B, um teste unitário que reproduz a divergência sempre que shard_count>1, e uma nova rodada em hardware para validar. O time deixou a run em andamento terminar do jeito que estava (85% concluída; a correção não desfaz dados já lidos, e relançar jogaria fora 1,2 milhão de passos de computação), documentando que o bug custou zero acurácia observável, mas corrigindo para runs futuras.
Checkpoint, resume e resize sem tocar na receita
O segundo bug era mais sutil: um off-by-one na detecção do passo de resume. O diretório de checkpoint número N era escrito depois que a iteração N terminava, então o modelo era restaurado no passo N+1 enquanto o data loader retomava no batch N, retreinando um batch e ficando permanentemente um passo atrasado. Com as duas correções (sharding e off-by-one) aplicadas, um teste controlado de checkpoint-and-resume replicou a run ininterrupta exatamente: delta de 0,000 na loss registrada em todos os 99 passos testados. Quando uma falha de host matou a run do estágio 2 no meio do processo, a run retomada refez 127 passos com delta de 0,000 em loss e perplexidade logadas.
Esse nível de exatidão importa porque uma run de 1,4 milhão de passos, rodando por semanas, vai ser interrompida. O time usa um loop resume_until_done que reenvia o job automaticamente após preempção, com checkpoint a cada 2000 passos (limitando o custo de uma interrupção a poucos minutos de recomputação na slice grande) e um backoff configurável de 300 segundos para não esgotar tentativas de resubmissão contra o Kueue.
A propriedade mais aproveitável de todo o stack JAX/XLA aqui, segundo o post, é que a receita de treino é desacoplada da topologia de hardware: o batch global (512 instâncias, 4,19 milhões de tokens por passo) é fixo, mas o número de chips sobre o qual ele é distribuído não é. Quando o time perdeu três quartos da capacidade alocada por volta do passo 1,05 milhão, a run continuou numa slice quatro vezes menor, sem mudar o script (run_olmo3_7b_stage1.sh reajusta o batch por dispositivo para manter o batch global constante), preservando o throughput por dispositivo dentro de 1% e mantendo praticamente 100% de strong scaling em ambas as direções (de 128 para 512 dispositivos e vice-versa).
Trocar de geração de TPU no meio da receita
O estágio 2 (mid-training/anneal) foi treinado numa geração de TPU diferente da do estágio 1: em vez de Ironwood, o mesmo launcher apontou para TPU v5p, mudando apenas o tipo de dispositivo, e sustentou 57,4% de MFU (model FLOPs utilization). No estágio 1, em Ironwood, o time chegou a 44,5% de MFU (510-513 TFLOP/s por dispositivo) na arquitetura original, via offload de coletivas (all-gather, reduce-scatter) para o SparseCore, flags específicas de XLA para v7x, rematerialização estendida das projeções de atenção e MLP, e splash attention com blocos de 2048 tokens.
Um detalhe que vale registrar para quem otimiza sharding: no MaxText, a topologia do sharding (FSDP puro vs. combinações de FSDP e tensor parallelism) foi praticamente irrelevante nessa escala, com variação de apenas ~1,5 TFLOP/s entre configurações em 128 dispositivos. Tensor parallelism intra-chip (TP=2), pelo contrário, foi uma perda líquida de 1,6% de MFU em batch reduzido e estourou memória em batch completo.
Um ablation à parte, não usado na reprodução oficial, testou reformatar a atenção de 32 cabeças com dimensão 128 para 16 cabeças com dimensão 256, mantendo parâmetros e FLOPs idênticos. O ganho foi 12,4% de velocidade, porque dimensão de cabeça 256 utiliza completamente a MXU 256×256 da Ironwood, e a curva de loss bateu com o original até 120 bilhões de tokens (30 mil passos). É um lembrete de que, em TPU, a forma do tensor de atenção pode valer tanto quanto o algoritmo.
O que fica pra quem treina fora do Google
Poucos times no Brasil vão treinar um 7B do zero em milhões de passos, mas o valor deste post não está na escala, está na disciplina de verificação. Três práticas são replicáveis em qualquer projeto de fine-tuning ou treino contínuo, mesmo em GPUs alugadas: primeiro, nunca validar convergência só pela loss de treino, sempre cruzar com um conjunto held-out e, se possível, uma bateria de tarefas downstream, porque memorização e bugs de data loader se escondem exatamente onde a loss de treino parece melhorar; segundo, testar paridade numérica sempre que houver conversão de framework ou de checkpoint, com uma métrica objetiva como KL entre distribuições de saída, não só comparação visual de outputs; terceiro, tratar resume-from-checkpoint como algo que precisa de teste de regressão automatizado, porque um resume levemente errado (como o off-by-one relatado) não quebra visivelmente, ele degrada silenciosamente o treino.
O código e as configurações usadas na reprodução, incluindo o arquivo olmo3-7b-pt.yml e o pipeline de dados olmo_grain, foram enviados como pull requests públicos para o repositório do MaxText, e o post lista os números das issues correspondentes. Isso significa que quem quiser rodar uma versão menor do mesmo experimento, digamos, um modelo na casa de 1B em uma TPU v5e alugada via Google Cloud, tem o ponto de partida documentado, incluindo os dois bugs já corrigidos no upstream. O estágio 3 (contexto longo, com YaRN) e o pós-treino via SFT e GRPO usando Tunix ainda não foram executados pelo time, então essa parte da receita do OLMo 3 continua em aberto.
Fonte: Google Developers Blog
Este artigo foi escrito por Alan Andrade, colunista de inteligência artificial. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Supabase MCP Server: o que um agente de IA pode (e não pode) executar no Postgres
A documentação oficial do Supabase MCP Server detalha as ferramentas que ele expõe a agentes de IA, do list_tables ao apply_migration. Veja o roteiro que separaria leitura segura de escrita destrutiva antes de plugar um agente no banco de produção.