Escolher Jev ou Laya? Veja 5 testes antes de trocar seu LLM por um modelo de decisão
Você quer avaliar a qualidade, a confiança e os custos antes de colocar Jev ou Laya no caminho de uma automação? Vamos lá! Classificar tickets e rotear solicitações pode ser bem simples!
Você quer avaliar a qualidade, a confiança e os custos antes de colocar Jev ou Laya no caminho de uma automação? Vamos lá! Classificar tickets e rotear solicitações pode ser bem simples!
Imagine que você recebeu uma mensagem como essa no suporte: “O pagamento passou certinho, mas o meu acesso ainda está bloqueado. E eu preciso disso o mais rápido possível para uma reunião daqui a pouco”.
Para uma pessoa, o problema é totalmente compreensível. Mas para uma automação, ele exige decisões: encaminhar ao financeiro ou ao suporte técnico? Marcar como urgente? Pedir mais informações?
É nesse espaço que Jev e Laya despertam interesse. Em vez de produzir uma resposta longa para depois extrair uma classificação, a proposta é entregar decisões estruturadas que o software consiga consumir.
O iMasters já apresentou o Jev e exemplos de uso e cobriu a Laya como alternativa aberta. Para quem pretende adotar uma delas, o próximo passo é montar uma avaliação que represente o trabalho real.
O roteiro abaixo propõe cinco testes. Ele não pressupõe que uma ferramenta seja superior à outra: o objetivo é descobrir onde cada opção consegue assumir uma tarefa com benefício mensurável.
1. A ferramenta entende o seu problema — inclusive em português?
Comece por uma decisão específica. “Automatizar o atendimento” é amplo demais. “Encaminhar solicitações entre financeiro, suporte técnico e comercial” permite definir o que seria uma resposta correta.
Monte uma amostra de mensagens reais, com dados pessoais removidos quando não forem necessários. Inclua textos curtos, erros de digitação, negações, abreviações e solicitações que misturam assuntos.
Estes exemplos ilustram situações que merecem entrar no teste:
| Mensagem | O que ela exige da classificação |
|---|---|
| “Não quero cancelar, só trocar o cartão.” | Distinguir menção de cancelamento de intenção de cancelar |
| “Pix aprovado, acesso bloqueado.” | Aplicar uma regra clara entre financeiro e suporte |
| “Pode atualizar, mas só depois das 22h.” | Preservar a condição imposta pelo usuário |
| “Deu ruim de novo.” | Reconhecer que falta contexto |
Antes de executar os modelos, peça à equipe que defina os resultados esperados. Se duas pessoas discordam sobre a fila correta, talvez o primeiro ajuste necessário esteja na regra de atendimento.
Compare Jev e Laya com o sistema atual, seja ele um LLM↳LLMs48 conteúdosConsiderações básicas de hardware para modelos de linguagem em código aberto: Memória, Desempenho e ViabilidadeMarketing Tech · out 2025Modelos de linguagem sob ataque: o lado obscuro da IA generativaDevSecOps · mai 2025Criando um LLM – modelo de linguagem de grande escala – do zero com TransformersAI · abr 2024Ver tudo em AI →, um classificador ou regras simples. Use os mesmos casos e critérios. Reserve uma parte dos exemplos para a avaliação final, sem utilizá-la para ajustar instruções, treinamento ou limites de confiança.
2. Você está medindo probabilidade ou apenas lendo um número de confiança?
Uma saída numérica é útil, mas exige interpretação.
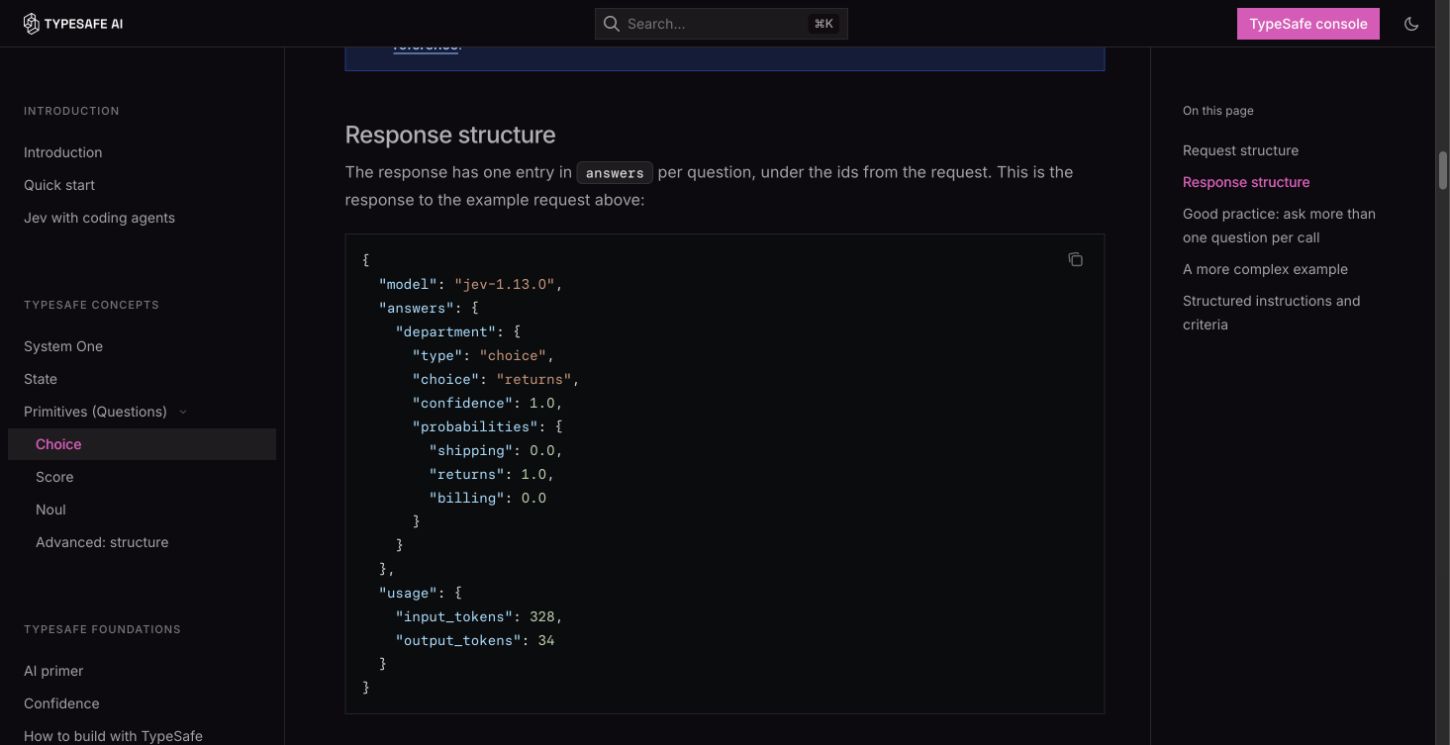
Na documentação do Jev, Choice e Score retornam uma distribuição de probabilidades e um campo confidence, calculado a partir dessa distribuição. Já Noul retorna um valor entre zero e um, sem esse campo adicional. Portanto, não se deve tratar automaticamente todo confidence: 0.9 como “90% de chance de acertar”. Documentação de confiança da TypeSafe.
Para probabilidades de classe, uma pergunta prática é: entre as previsões próximas de 90%, a frequência de acertos também fica próxima disso? Essa correspondência é a ideia central de calibração. Pesquisas mostram que redes neurais podem apresentar probabilidades mal calibradas, mesmo quando classificam bem. Estudo sobre calibração de redes neurais.
No projeto, registre o número retornado, a decisão e o resultado correto. Analise por categoria e tipo de entrada. Uma média geral pode esconder um comportamento ruim justamente nas mensagens mais importantes.
O limite usado para automatizar deve nascer dessa avaliação. Copiar 0.9 de um exemplo de documentação não demonstra que esse valor seja adequado ao seu domínio.
3. Quantos casos podem ser automatizados sem aumentar os erros relevantes?
Acertar bastante entre poucas respostas selecionadas é diferente de resolver a maior parte da operação.
Considere um cenário hipotético: de mil solicitações, o sistema encaminha automaticamente 400 e acerta 392. A precisão dos encaminhamentos automáticos é de 98%, mas a cobertura é de 40%. As outras 600 solicitações ainda precisam de tratamento.
Agora imagine uma configuração que automatiza 800 casos e acerta 760. A precisão cai para 95%, enquanto a cobertura sobe para 80%.
Qual configuração é melhor? Depende do custo dos erros e da capacidade de revisão.
Encaminhar um ticket para a equipe errada pode gerar retrabalho. Deixar de identificar um incidente urgente pode ter uma consequência muito maior. Por isso, acompanhe separadamente:
- A parcela de casos automatizados.
- Os erros entre as decisões automáticas.
- Os casos críticos que passaram despercebidos.
- O volume e o tempo de revisão humana.
No anúncio técnico da Laya, o próprio autor apresenta resultados que mudam conforme a parcela de casos em que o modelo aceita responder. Isso reforça a importância de avaliar qualidade e cobertura juntas. Os números publicados são do projeto, não de um teste independente realizado pelo iMasters. Publicação técnica da Laya.
4. A velocidade continua boa quando a requisição atravessa o sistema inteiro?
O tempo de execução do modelo é apenas uma parte da espera do usuário.
Uma avaliação útil começa quando a aplicação recebe a solicitação e termina quando a decisão está disponível para o próximo passo. Nesse intervalo entram rede, preparação dos dados, fila, inferência e eventuais novas tentativas.
Meça tanto a mediana quanto o percentil 95 — o tempo abaixo do qual terminam 95% das solicitações. Teste também concorrência, mensagens longas e inicialização após um período de inatividade.
Na Laya, o repositório descreve diferenças relevantes entre manter os modelos carregados e precisar recarregá-los ao alternar entradas de idiomas diferentes. Também informa que os números comparativos do Jev vieram de terceiros, com diferenças de amostras e perguntas. A tabela pública serve como ponto de partida, não como garantia de desempenho na sua aplicação. Repositório oficial da Laya.
Para uma comparação própria, registre versões, hardware, região da aplicação, tamanho das entradas e quantidade de perguntas por chamada. Sem isso, um número menor pode refletir condições diferentes.
5. A economia permanece depois de incluir operação e revisão?
Uma API cobra pelo serviço. Uma instalação própria exige recursos para funcionar. Em ambos os casos, a conta continua depois da inferência.
Como proposta de avaliação, some:
Custo total = inferência ou infraestrutura + operação + revisão humana + retrabalho causado pelos erros.
Divida esse total pelo número de casos concluídos corretamente dentro do prazo esperado. Essa medida aproxima a comparação do resultado que interessa ao produto.
Também experimente o comportamento quando o modelo falha: timeout, resposta inválida, indisponibilidade ou entrada fora do escopo. O sistema deve ter um destino definido para esses casos, como uma fila de revisão.
E mantenha classificação e autorização separadas. Reconhecer que um cliente pediu reembolso não autoriza executar o pagamento. Identificar uma intenção de aprovar não elimina condições, limites de acesso ou confirmações exigidas pelo processo.
O primeiro experimento pode funcionar sem alterar nenhuma decisão
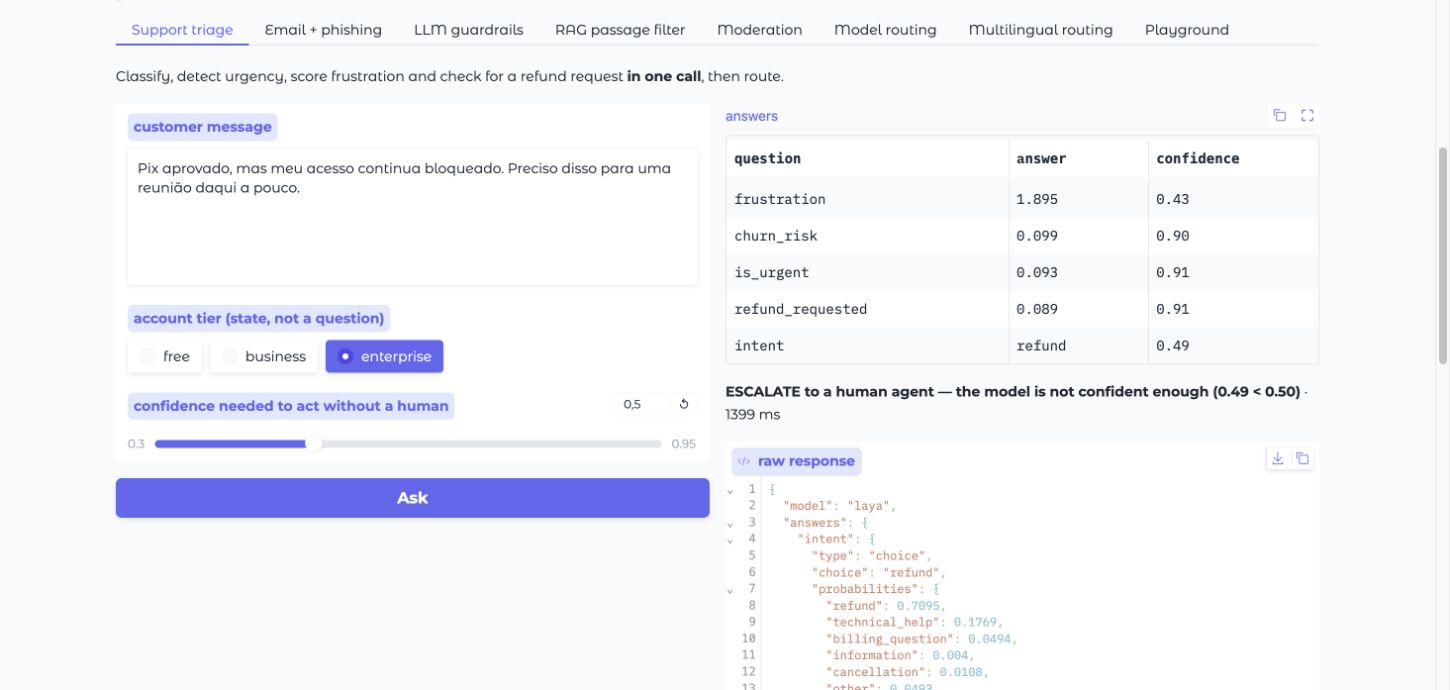
Uma forma de começar é executar o modelo em paralelo ao fluxo atual, apenas registrando suas sugestões. A operação continua como antes, enquanto a equipe compara decisões, latência e custo.
Defina previamente quais resultados justificariam liberar uma parcela da automação. Depois, comece por ações reversíveis, acompanhe também uma amostra das decisões de alta confiança e preserve um caminho de retorno ao fluxo anterior.
Jev e Laya podem ser avaliados como componentes de uma tarefa específica: encaminhar, priorizar, selecionar ou verificar. A decisão de adotá-los fica mais clara quando a equipe consegue demonstrar qual trabalho foi automatizado, quantos erros permaneceram e quanto custou cada resultado útil.


O que é o Jev (e por que eu comecei a usar)

.NET 11 e C# 15: Recursos e Otimizações no EF Core e LINQ
Na era da IA, o QA não testa só software. Ele desenha confiança
 John Calistro
Gerar código ficou mais barato. Entendê-lo, não.
 Cezar Taurion
.NET 11 : Novidades C# , LINQ e EF Core
 José Carlos Macoratti
Do Build à Loja: Automatizando a Publicação de Apps com Computer Use, Codex e Claude
 Iago Cavalcante