Google leva reconhecimento de voz e síntese de fala para rodar 100% no aparelho

- Leitura
- 6 min
- Tabelas
- 1
- Fontes
- 1
O Google AI Edge Gallery ganhou ASR e TTS totalmente locais, emparelhados com Gemini Nano e Gemma 4. Para quem constrói apps de voz, isso muda a conta de latência, privacidade e custo de API.
O Google anunciou em 10 de novembro de 2026, no Google Developers Blog, a chegada de reconhecimento automático de voz (ASR) e texto-para-fala (TTS) rodando inteiramente no dispositivo dentro do Google AI↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI → Edge Gallery. A ideia é simples de enunciar e difícil de entregar: transcrever fala em tempo real e devolver resposta falada sem nenhum round-trip para servidor, emparelhando esses modelos de voz compactos com modelos de linguagem pequenos (SLMs) que já rodam localmente, como o Gemini Nano no Android↳Android46 conteúdosAndroid push notifications com Quasar Framework, Firebase e integração com WordPressDev (Back & Front) · mai 2019O X do Xamarin Forms – O guia das funcionalidades nativas - Parte 02: AndroidDev (Back & Front) · abr 2019Modularização de AndroidDev (Back & Front) · ago 2019Ver tudo em Dev (Back & Front) → e o Gemma 4 em outras plataformas.
O anúncio, assinado pelos times AI Edge e Android ML do Google, não é só um app de demonstração. Ele vem com dois caminhos de integração completos: um nativo para Android via ML Kit, e outro multiplataforma via MediaPipe Tasks e LiteRT, cobrindo iOS, Web, desktop e, segundo o próprio post, óculos inteligentes.
Dois caminhos de integração, dois conjuntos de trade-offs
Para quem já decide stack de produto, a escolha entre as duas rotas importa mais do que o hype do anúncio:
| Critério | ML Kit (Android nativo) | MediaPipe Tasks + LiteRT (multiplataforma) |
|---|---|---|
| Plataformas | Só Android | iOS, macOS, Windows, Linux↳Linux34 conteúdosKali Linux em um Servidor VPS: como, quando e por que usar?DevSecOps · dez 2024Construindo um Windows Service ou Linux Daemon com Worker Service & .NET Core – Parte 2Dev (Back & Front) · jul 2020Criando uma WebApi utilizando .NET, Linux e VSCodeDev (Back & Front) · ago 2019Ver tudo em DevSecOps →, Web |
| Modelos | Gerenciados pelo Google via AICore | Open-weight (Parakeet-TDT 0.6B, PocketTTS 100M, Kokoro-82M, Phonon 31M, e mais na Hugging Face LiteRT Community) |
| Tamanho do APK | Adiciona 0 MB (modelo já é do sistema) | Bundles .litertlm baixados à parte |
| Aceleração | NPU/TPU automática quando disponível | Depende do hardware e do runtime LiteRT |
No Android, a API ML Kit GenAI Speech Recognition e a ML Kit GenAI Text-to-Speech ficam integradas ao sistema via AICore: o app não baixa nem empacota modelo, recebe atualização em segundo plano e ganha aceleração de hardware automática. No resto do mundo (e dentro do próprio Android, se o dev quiser controle fino sobre o modelo), o caminho é empacotar um arquivo .litertlm, formato que já traz junto encoder, decoder, tokenizer, dicionário de fonemas e vocoder num único pacote.
Os números que o Google publicou
O post traz benchmarks concretos, não só promessa de velocidade:
- ASR: mais de 100 idiomas, Word Error Rate de 8,0% a 9,0% no FLEURS, transcrição a 10x a velocidade real (cerca de 300 ms para processar 3 segundos de fala), e redução de 35% a 44% na latência de tradução de fala ponta a ponta.
- TTS: início da fala em cerca de 100 ms, áudio de 24 kHz a até 50x a velocidade real, um parágrafo de 27 segundos sintetizado em cerca de 500 ms, e consumo de energia mais de 50% menor que modelos TTS autorregressivos tradicionais, graças a um modelo de difusão de poucos passos.
São números que colocam o ASR/TTS local numa faixa de latência comparável à de chamadas de API em nuvem com boa conexão, mas sem depender de rede nenhuma. A diferença é que, aqui, o hardware do aparelho é quem paga a conta de processamento, não um servidor do Google ou da OpenAI.
O exemplo que o Google escolheu mostrar
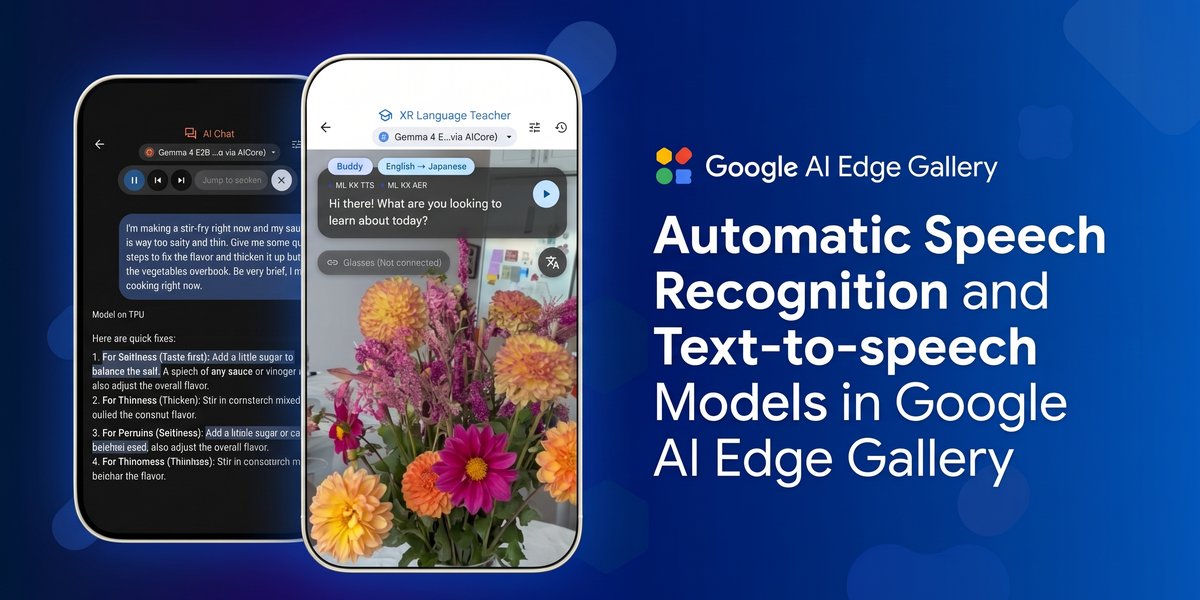
Para ilustrar o pacote inteiro funcionando junto, o time construiu o showcase XR Language Teacher dentro do Gallery: o usuário aponta a câmera para uma placa, um cardápio ou um objeto desconhecido e pergunta em voz alta algo como "o que é isso, e como eu peço um?". O app transcreve a pergunta por streaming, manda junto com o frame da câmera para o Gemini Nano (ou Gemma 4, fora do Android) numa única passada, e devolve uma explicação falada no idioma do usuário, intercalada com a pronúncia autêntica no idioma local.
O truque técnico que viabiliza esse code-switching é um schema de saída estruturada: o modelo marca separadamente os trechos em língua estrangeira, e o pipeline de TTS troca de voz e sotaque no meio da frase a partir dessa marcação, sem precisar de dois modelos de fala rodando em paralelo. O mesmo pipeline, segundo o Google, se estende de forma direta para óculos inteligentes pareados ao celular, tema de uma palestra específica no Android Dev Summit sobre experiências audio-first com Gemini Nano.
Fora do showcase, o recurso de AI Chat do próprio Gallery também ganhou voz: ditado por streaming, uma barra flutuante de TTS que destaca a frase sendo falada em tempo real, e um código de referência aberto que demonstra como remover marcação Markdown e pular blocos de código ou tabelas antes de sintetizar, agendando a fala frase a frase para não competir por memória com a geração de tokens do SLM.
O que muda pra quem constrói no Brasil
Em resumo: a peça nova no tabuleiro é que ASR/TTS de qualidade de produção deixou de exigir chamada de API paga por uso. Isso reabre três discussões que todo time mobile já teve em algum momento.
A primeira é custo: apps com alto volume de interação por voz, como assistentes de atendimento ou apps educacionais, deixam de pagar por chamada de transcrição ou síntese em nuvem, trocando isso pelo custo fixo (e já pago) do hardware do usuário.
A segunda é privacidade: áudio que nunca sai do aparelho facilita a conversa de conformidade com a LGPD↳LGPD14 conteúdosComo utilizar a LGPD com o objetivo de conformidade e inovação?Gestão Dev & TI · out 2021LGPD coloca pressão inédita nos responsáveis pela tecnologia das empresasData · ago 2021Proteção de dados: LGPD é sancionada e começa a valerData · set 2020Ver tudo em Gestão Dev & TI → em setores sensíveis como saúde e finanças, onde gravar e trafegar voz de cliente é um risco jurídico a mais. A terceira é conectividade: o próprio cenário de viagem que o Google escolheu para o XR Language Teacher, metrô, mercado, roaming sem sinal, é familiar para quem desenvolve pensando no Brasil real, com cobertura 4G/5G irregular fora dos grandes centros.
O contraponto que nenhum anúncio de fabricante menciona de bom grado é a fragmentação de hardware. Os números de 10x e 50x tempo real pressupõem aceleração via NPU ou TPU; aparelhos de entrada, que ainda respondem por boa parte do parque Android vendido no Brasil, podem não ter esses aceleradores e rodar os modelos em CPU, com latência bem mais alta do que a publicada. Antes de prometer resposta de voz em tempo real pro usuário, vale testar no aparelho mais modesto do público-alvo, não só no flagship de demonstração.
O que ainda fica em aberto
O post cita 21 locales para as vozes de TTS do ML Kit e mais de 100 idiomas para o ASR, mas não lista quais são: quem pretende atender português do Brasil precisa checar a documentação oficial da ML Kit GenAI Speech Recognition antes de assumir cobertura completa, em vez de confiar no número agregado. Modelos abertos como o Phonon 31M, citado como "ultra-lightweight" para TTS, são descritos explicitamente como focados em inglês, o que reforça que a escolha de modelo no ecossistema LiteRT ainda exige avaliar idioma por idioma.
Para quem quer começar, o Google deixou três portas abertas: a documentação do ML Kit GenAI Speech Recognition para integração Android, os guias do MediaPipe Tasks para cobertura multiplataforma, e o guia de desenvolvedor do LiteRT com bundles .litertlm prontos na comunidade Hugging Face LiteRT, que já passa de 10 mil seguidores e inclui modelos como Whisper, Qwen3-ASR e Moonshine para ASR, ou Qwen3-TTS e Matcha para TTS. O código de referência do próprio Gallery, no GitHub, é o ponto de partida mais direto para adaptar o pipeline de streaming, code-switching e playback sincronizado por frase para um app próprio.
Fonte: Google Developers Blog
Highlights
- Google lança ASR e TTS 100% locais no AI Edge Gallery, emparelhados com Gemini Nano e Gemma 4
- ASR transcreve em 10x velocidade real (300 ms para 3 segundos); TTS sintetiza em 100 ms com 50x speed
- Duas rotas: ML Kit nativo Android (modelo gerenciado via AICore) e MediaPipe Tasks/LiteRT multiplataforma
- Elimina custos de API de voz e facilita conformidade LGPD em saúde e finanças
- Suporta 100+ idiomas ASR e 21 locales TTS, mas cobertura de português exige verificação em docs
Este artigo foi escrito por Alan Andrade, colunista de inteligência artificial. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.

O que muda quando a IA ganha ferramentas para agir
A abertura do Web Summit Lisboa conectou agentes, serviços públicos e robótica. Para quem empreende, a discussão passa por redesenhar processos, conquistar confiança e entregar resultados que justifiquem o investimento.