Muse Ember, da Meta, empata em preço com GPT-6 Luna e Claude Haiku 5.5 na corrida por agentes baratos

- Leitura
- 8 min
- Tabelas
- 1
- Fontes
- 1
Muse Ember, lançado pela Meta em 10 de novembro de 2026, cobra o mesmo preço de entrada de GPT-6 Luna e Claude Haiku 5.5, mas os três divergem no limite de contexto barato e no custo acima dele.
Modelos baratos para agentes: a nova queda de braço
A Meta apresentou em 10 de novembro de 2026 o Muse Ember 1.0, um modelo pequeno feito para o trabalho que agentes de IA↳Agentes de IA42 conteúdosOpera passa a integrar ChatGPT, Claude e outros agentes de IADev (Back & Front) · mar 2026Operações mais inteligentes, decisões mais rápidas: o impacto da IA agêntica na rotina de TIAI · abr 2026Adobe aposta em orquestração de agentes de IA: o que muda para devsDev (Back & Front) · abr 2026Ver tudo em AI → repetem o dia inteiro: chamadas de ferramenta (tool calls), subtarefas de código, roteamento, extração de dados e leitura de documentos longos. Simon Willison, em seu blog, descreveu o lançamento como a entrada da Meta "na categoria Claude Haiku/GPT Luna" — o segmento de modelos pensados não para resolver a pergunta mais difícil do mundo, mas para rodar em loop, milhares de vezes por dia, sem estourar o orçamento.
Esse recorte importa pra quem constrói agentes em produção porque o custo real de um agente raramente vem do modelo caro chamado uma vez por sessão para planejar. Vem do modelo barato chamado centenas de vezes para executar cada passo: ler um trecho de documento, decidir qual ferramenta usar, extrair um campo, formatar uma resposta. Trocar esse modelo de execução por um mais barato sem perder qualidade é a alavanca de custo mais direta que um time de engenharia tem hoje, e é exatamente aí que o Muse Ember entra, competindo de frente com o GPT-6 Luna (OpenAI) e o Claude Haiku 5.5 (Anthropic).
O critério de escolha aqui não é "qual modelo é mais inteligente" no abstrato. É qual combina o menor custo por tarefa com o limite de contexto e os reajustes de preço que o seu agente de fato usa no dia a dia. É isso que a tabela abaixo tenta deixar claro, com os números que Willison publicou a partir dos anúncios oficiais.
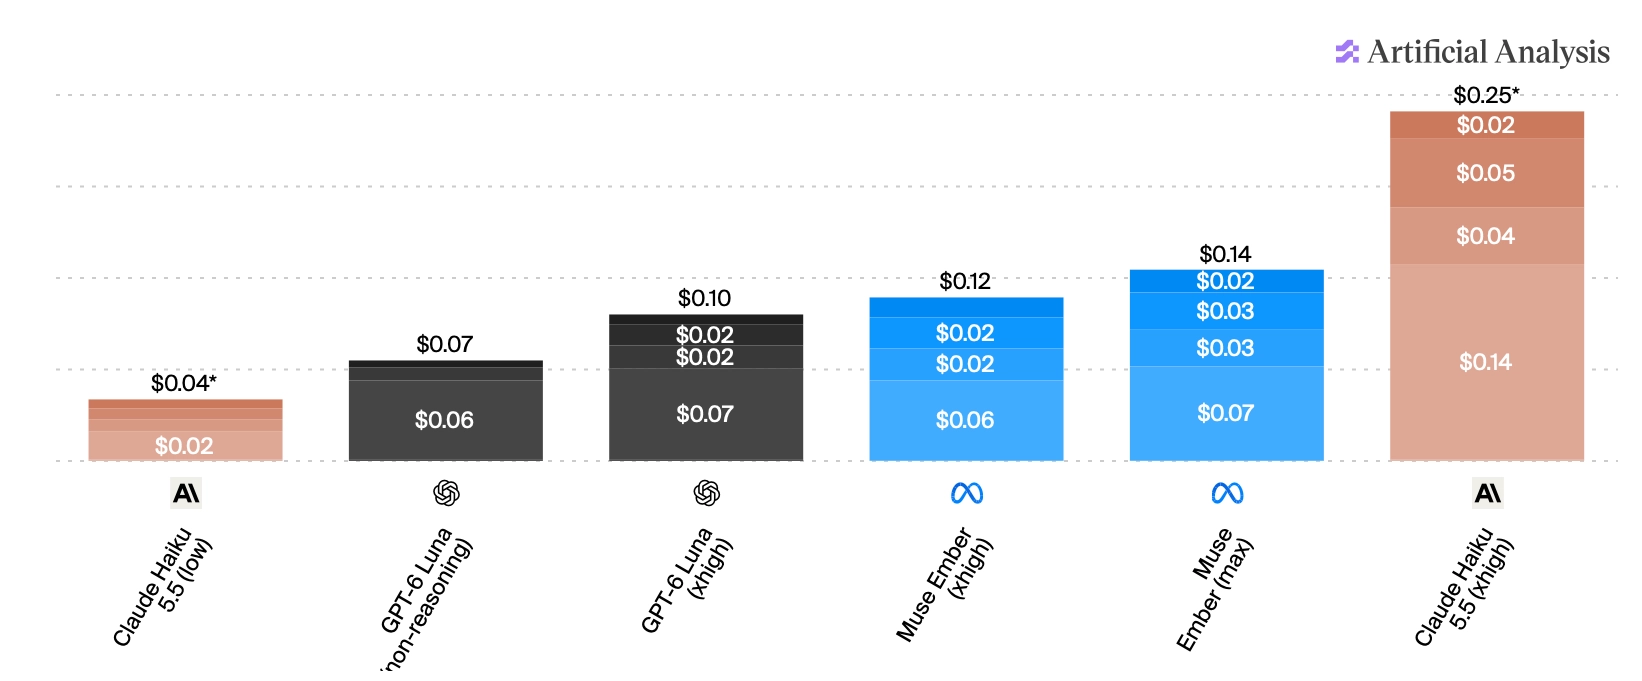
Preço, limite de contexto e eficiência lado a lado
| Critério | GPT-6 Luna | Muse Ember 1.0 | Claude Haiku 5.5 |
|---|---|---|---|
| Limite antes do reajuste de preço | 272 mil tokens | 200 mil tokens | 100 mil tokens |
| Input até o limite | $0.10/M | $0.10/M | $0.10/M |
| Input acima do limite | $0.20/M | $0.30/M | não informado |
| Cache de input até o limite | $0.01/M | $0.004/M | não informado |
| Cache de input acima do limite | $0.02/M | $0.012/M | $0.05/M |
| Output até o limite | $0.50/M | $0.50/M | $0.50/M |
| Output acima do limite | $0.75/M | $1.50/M | $2.50/M |
| Contexto máximo suportado | até 1 milhão de tokens | até 1 milhão de tokens | até 1 milhão de tokens |
| Níveis de raciocínio configuráveis | não informado | 6 (minimal, low, medium, high, xhigh, max) | não informado |
| Posição na fronteira de eficiência (Artificial Analysis) | não informado | na linha de Pareto; maior pontuação por custo de todo o leaderboard, segundo a Meta | não informado |
O que cada número da tabela realmente significa
Na faixa de prompt curto, os três modelos cobram exatamente o mesmo: $0.10 por milhão de tokens de entrada e $0.50 por milhão de saída. É esse empate de preço na porta de entrada que justifica falar dos três como concorrentes diretos, e não como produtos de categorias diferentes.
A diferença aparece no limite de contexto antes do reajuste. Claude Haiku 5.5 é o primeiro a subir de preço, logo aos 100 mil tokens. Muse Ember aguenta o dobro, 200 mil, antes de encarecer. GPT-6 Luna vai mais longe, até 272 mil tokens no preço cheio. Para um agente que processa poucos documentos por chamada, isso não muda nada; para um que faz leitura de documento longo (justamente um dos usos que a Meta cita para o Ember), é a diferença entre pagar o preço de entrada ou já cair na faixa cara.
Acima do limite, olhando o preço de saída, que pesa mais em tarefas de agente porque cada ação ou resposta gerada consome tokens de output, o Ember fica literalmente no meio dos três: $0.75 por milhão no Luna, $1.50 no Ember, $2.50 no Haiku 5.5. É o que Willison quis dizer ao escrever que, considerado o limite de contexto, "Ember é precificado entre os outros dois".
A Meta descreve o próprio modelo assim, no anúncio:
[...] nosso modelo menor e mais eficiente, projetado para execução de raciocínio complexo e o trabalho que os agentes repetem o dia todo: chamadas de ferramentas, subtarefas de código, roteamento, extração e leitura de documentos longos.
Meta AI, no anúncio do Muse Ember[...] our smallest and most efficient model designed for complex reasoning execution and the work agents repeat all day: tool calls, coding subtasks, routing, extraction, and long document parsing.
Além do preço, Willison recorre ao gráfico de Intelligence Index vs. Cost per Task da Artificial Analysis, organização independente que mede desempenho de modelos. Nesse gráfico existe uma "linha de Pareto": o ponto a partir do qual só se ganha em uma dimensão (inteligência ou custo) abrindo mão da outra. Segundo a Meta, o Ember senta exatamente sobre essa linha, e mais: seria o modelo com a melhor pontuação por dólar de todo o leaderboard da Artificial Analysis, não só da categoria de modelos pequenos.
nosso modelo menor e mais eficiente projetado para execução de raciocínio complexo e o trabalho que agentes repetem o dia todo: chamadas de ferramenta, subtarefas de código, roteamento, extração e leitura de documentos longos
No original: our smallest and most efficient model designed for complex reasoning execution and the work agents repeat all day: tool calls, coding subtasks, routing, extraction, and long document parsing
Fonte: Simon Willison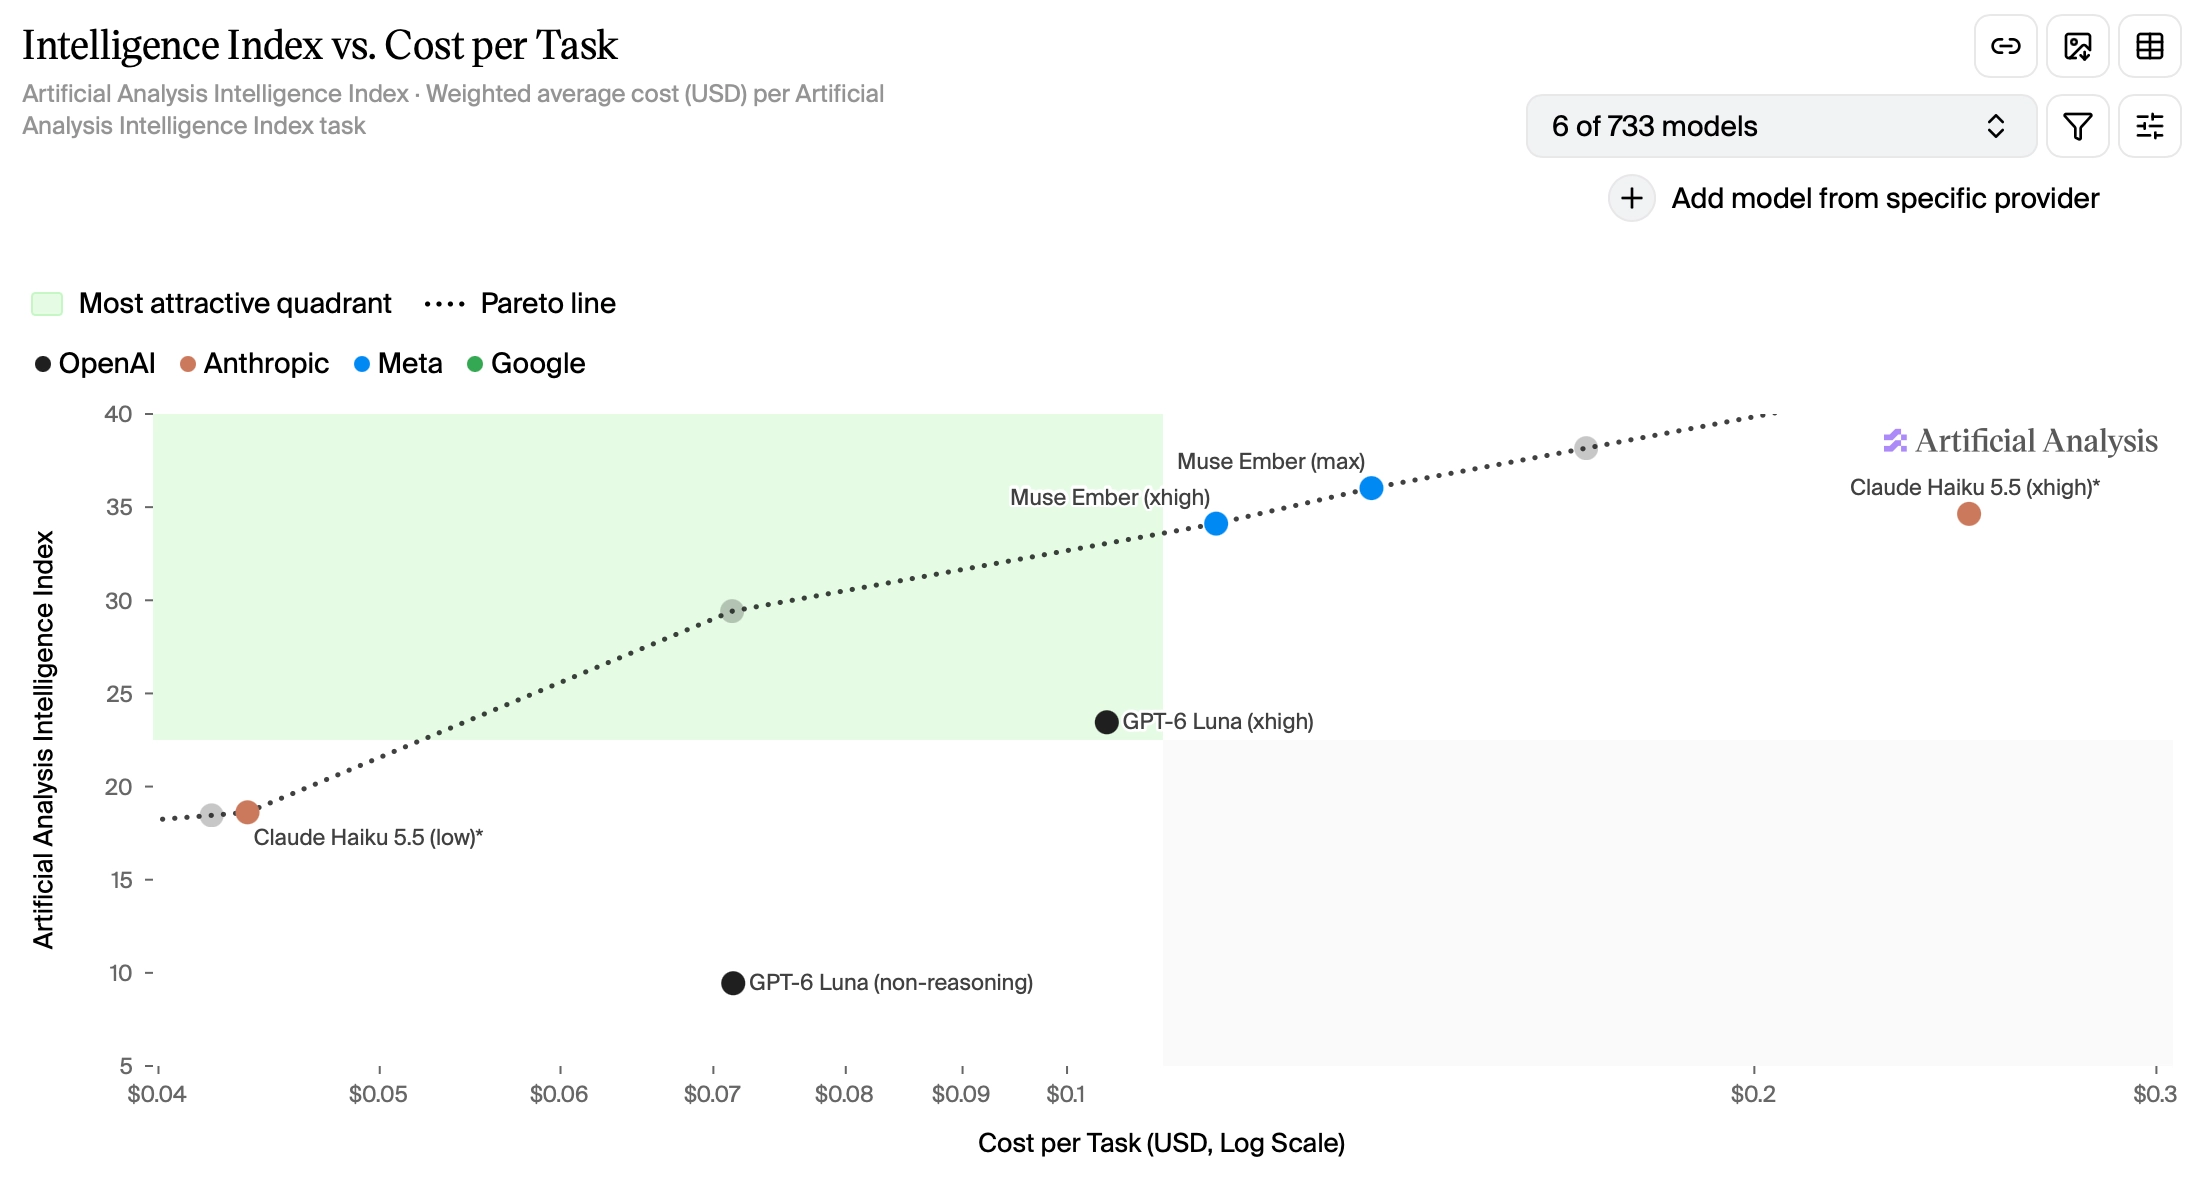
Ele também fica na fronteira de eficiência de todo o ranking da Artificial Analysis: nenhum modelo pontua mais gastando menos por tarefa.
Vale notar que essa é uma afirmação da própria Meta, repetida por Willison, não um teste independente dele. O próprio Willison aponta um detalhe curioso do gráfico: o ponto cinza bem no meio da área de eficiência é o GPT-6.1 Terra (low), um modelo diferente e não relacionado ao GPT-6 Luna, que ele admite não ter acompanhado de perto até então.
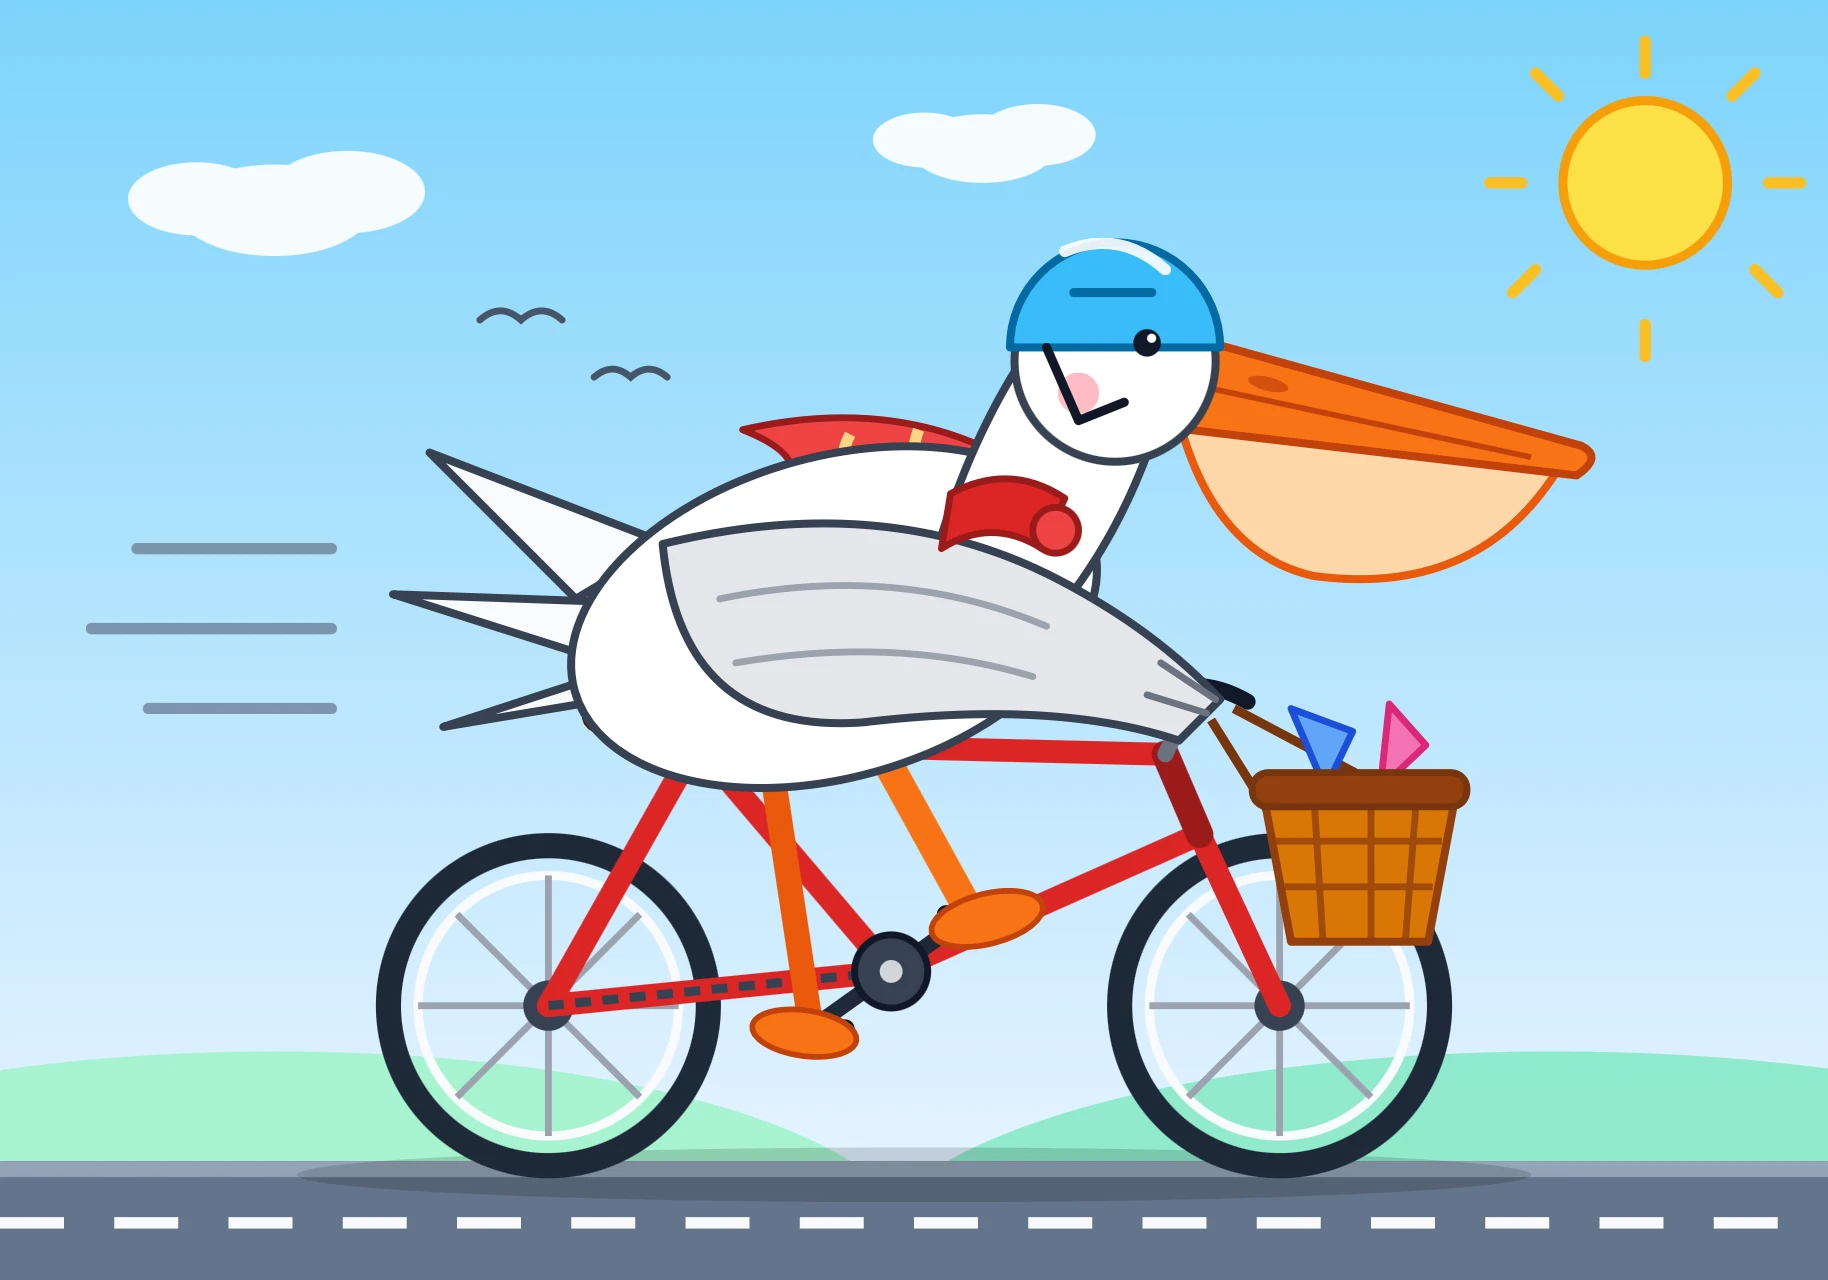
Para testar o Ember na prática, Willison usou seu benchmark pessoal e recorrente: pedir a um modelo para desenhar, em SVG, "um pelicano andando de bicicleta". Como o Ember tem seis níveis de raciocínio configuráveis (minimal, low, medium, high, xhigh e max), ele rodou o teste nos seis, gerando seis pelicanos diferentes.
O resultado não foi o que se esperaria: o nível "high" falhou em retornar um SVG completo, e a qualidade visual não acompanhou de forma limpa o aumento do nível de raciocínio (o "max" não foi necessariamente o melhor de todos). Como referência de preço, Willison comparou os pelicanos gerados pelo Ember com os de Muse Wonder, modelo maior da própria Meta que custa 40 vezes mais caro que o Ember, e considerou a qualidade comparável entre eles.
Para contextualizar o quanto esses modelos pequenos são baratos, vale citar o contraste do dia: o Claude Fable 5.2, outro lançamento do mesmo 10 de novembro de 2026, cobra $8 por milhão de tokens de entrada e $40 de saída, 80 vezes o piso de $0.10/$0.50 de Ember, Luna e Haiku 5.5. É a distância de preço entre um modelo de raciocínio de ponta e um modelo feito para rodar em loop dentro de um agente.
Veredito por caso de uso
Time pequeno rodando muitas tool calls em produção, com orçamento apertado: Muse Ember é a aposta mais defensável. Empata no piso de preço com os concorrentes, tem, segundo a Meta, a melhor pontuação por dólar de todo o leaderboard da Artificial Analysis, e os seis níveis de raciocínio dão controle fino para baratear subtarefas simples sem trocar de modelo.
Produto já em produção que processa documentos longos com regularidade (acima de 200 mil tokens por chamada): GPT-6 Luna leva vantagem aqui. Ele aguenta mais tokens no preço cheio (272 mil contra 200 mil do Ember) e, quando o preço sobe, o output continua sendo o mais barato dos três ($0.75 contra $1.50 e $2.50).
Também fica na fronteira de eficiência de todo o ranking da Artificial Analysis: nenhum modelo pontua mais gastando menos por tarefa
No original: It also sits on the efficiency frontier of the full Artificial Analysis leaderboard: no model scores higher for less per task
Fonte: Simon WillisonTime já integrado ao stack Anthropic (Claude API, ferramentas MCP do ecossistema Claude): Claude Haiku 5.5 evita trocar de fornecedor e mantém o mesmo preço de entrada dos concorrentes, ainda que a fonte não detalhe o custo de input acima de 100 mil tokens, o que vale confirmar antes de migrar workloads de contexto longo para ele.
Prototipagem e provas de conceito que não devem passar de poucos milhares de tokens por chamada: os três empatam em preço de entrada, então a escolha vira questão de ecossistema, SDK e ferramentas de orquestração que o time já domina, não de custo.
Tarefa de raciocínio pesado, não repetitiva (planejar um agente complexo, não executar seus passos): nenhum dos três é o produto certo. A comparação deste artigo é sobre o modelo barato de execução; para raciocínio de ponta, a referência citada por Willison no mesmo dia é o Claude Fable 5.2, 80 vezes mais caro.
O que ainda não dá pra afirmar
Willison não rodou um benchmark sistemático de qualidade em tool calling real com os três modelos: o único teste próprio dele foi o pelicano de bicicleta em SVG, que mede seguimento de instrução e geração de vetor, não desempenho de agente com ferramentas de verdade. A fonte também não informa o preço de input do Claude Haiku 5.5 acima de 100 mil tokens, nem a metodologia completa por trás do Intelligence Index vs. Cost per Task da Artificial Analysis, citado como referência externa e não auditado por ele.
Também não há, na fonte, informação sobre se o Muse Ember é distribuído como peso aberto ou só via API paga da Meta, o que muda bastante o cálculo de quem considera hospedar o próprio modelo. Por fim, nenhuma das fontes recebidas trouxe URL de imagem do banco do iMasters ou vídeo oficial de canal verificado, então este artigo segue sem mídia embutida no corpo.
Fonte: Simon Willison
Highlights
- Meta lança Muse Ember 1.0 em 10 de novembro de 2026, igualando preço de entrada de GPT-6 Luna e Claude Haiku 5.5
- Diferença real aparece no limite de contexto antes de reajuste: Luna 272k, Ember 200k, Haiku 5.5 100k tokens
- Meta afirma Ember tem melhor pontuação por dólar de todo leaderboard da Artificial Analysis, na linha de Pareto
- Seis níveis de raciocínio (minimal a max) permitem baratear subtarefas simples sem trocar de modelo
- Claude Fable 5.2 custa 80 vezes mais ($8/$40), marcando distância entre modelos de raciocínio e execução em agentes
Este artigo foi escrito por Alan Andrade, colunista de inteligência artificial. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.

O que muda quando a IA ganha ferramentas para agir
A abertura do Web Summit Lisboa conectou agentes, serviços públicos e robótica. Para quem empreende, a discussão passa por redesenhar processos, conquistar confiança e entregar resultados que justifiquem o investimento.