Réplicas de leitura de região cruzada para Amazon Aurora
Agora é possível criar uma réplica de leitura em outra região. Aprenda como!

Você já tem o poder de dimensionar a capacidade de leitura das suas instâncias do Amazon Aurora criando réplicas de leitura adicionais a um cluster existente. Agora é possível criar uma réplica de leitura em outra região. Esse novo recurso permitirá executar uma recuperação de desastres por região cruzada e escalar sua leitura. Você também pode usá-lo para migrar de uma região para outra ou para criar um novo ambiente de banco de dados↳Banco de dados134 conteúdosSQL ou NoSQL: eis a questão!!Data · mar 2020Banco de dados: como organizar e dar segurança para milhões de dados de loteriasData · mai 20215 serviços gratuitos na cloud para bancos de dados PostgresData · fev 2025Ver tudo em Data → em uma região diferente.
Criar uma réplica de leitura em outra região também cria um cluster Aurora nessa região. Este cluster pode conter até 15 réplicas a mais de leitura, com uma latência de replicação muito baixa (tipicamente menor que 20 ms) na região (entre as regiões, a latência varia de acordo com a distância entre a origem e destino). Você pode usar este modelo para duplicar seu cluster e ler a configuração de réplicas em todas as regiões para recuperação de desastres. No caso de uma interrupção regional, você pode promover a réplica de região cruzada para ser a mestre. Isso permitirá que você minimize o tempo de inatividade para a sua aplicação de região cruzada. Este recurso se aplica a clusters do Aurora não criptografados.
Antes que você comece realmente criar a réplica de leitura, você precisa cuidar de um par de pré-requisitos. Você precisa ter certeza de que uma VPC e os grupos de sub-rede do banco de dados existem na região alvo e você precisa habilitar o log binário no cluster existente.
Configurando o VPC
Uma vez que o Aurora sempre é executado dentro de um VPC, garanta que o VPC e os grupos de sub-rede do banco de dados existam na região alvo. Veja o meu:

Ativando o log binário
Antes de criar uma réplica de leitura de região cruzada, você precisa habilitar o log binário para o seu cluster existente. Crie um novo grupo de parâmetros do cluster DB (se você ainda não estiver usando um não padrão):

Ative o log binário (escolha MIXED) e clique em Save Changes:

Em seguida, modifique a Instância DB, selecione o novo Cluster Parâmetro Grupo DB, verifique imediatamente aplicáveis e clique em Continue. Confirme as suas modificações e, em seguida, clique no botão Modify DB Instance para seguir:

Selecione a instância e a reinicie, então, espere até que esteja pronto.
Criar replica de leitura
Com os pré-requisitos preparados, é hora de criar a réplica de leitura. De dentro do AWS Management Console, selecione o cluster de origem e escolha Create Cross Region Read Replica no menu Instance Actions:

O nome do novo cluster e a nova instância, e depois escolha a região alvo. Escolha a DB Subnet Group e defina as outras opções como desejado, em seguida, clique em Create:

O Aurora vai criar o cluster e a instância. Os estados de ambos os itens permanecerão em creating até que os itens sejam criados e os dados replicados (isso pode levar algum tempo, dependendo da quantidade de dados armazenados no cluster existente).
Este recurso já está disponível e você já pode começar a usá-lo.


Federação de Service Mesh Multicloud: Orquestrando Tráfego Zero-Trust entre Nuvens via Istio e SPIFFE/SPIRE
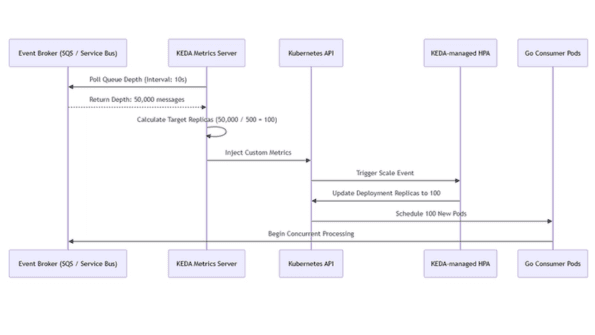
Arquitetando o dimensionamento automático orientado a eventos em várias nuvens: federando KEDA e Go na AWS e no Azure
Governança Multicloud e GitOps: Unificando Clusters Kubernetes com Azure Arc e Flux
 Cláudio Raposo
Arquitetura de Identidade Multicloud de Confiança Zero: Federando SPIFFE/SPIRE na AWS e no Azure
Cláudio RaposoArquitetura de CQRS Multicloud: Desacoplando Domínios de Leitura e Gravação entre AWS e Azure
Cláudio RaposoAWS Cellular Architecture: Escalando Sistemas Event-Driven com DynamoDB, SNS e SQS
Cláudio Raposo