Cada PR ganhou uma URL. Por que a homologação continua quebrando?
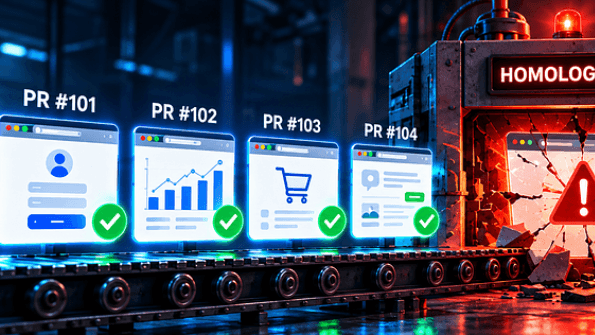
Preview deployments ajudam na revisão, mas dados, filas e dependências compartilhadas podem manter os mesmos conflitos.

Imagine um time que acabou de adotar preview deployments. Cada PR recebe um link, e o QA já não precisa esperar que alguém publique a interface em homologação para começar a revisão.
Durante um teste de checkout, porém, o estoque muda sem explicação. Em outro preview, uma operação consome o cadastro de que o primeiro teste precisava. As URLs são diferentes, mas o banco continua sendo o mesmo.
O time volta a perguntar quem alterou o quê e tenta reconstruir a massa de testes. A revisão, que deveria estar olhando para o comportamento da mudança, fica parada até alguém recuperar as condições para testar.
Ter uma URL por PR ajuda bastante, mas não resolve, por si só, a disputa de homologação. Se cada preview continua alterando o estado usado pelos demais, parte do conflito continua lá. Pedir mais cuidado para quem está testando dificilmente vai resolver.
Para mim, a diferença aparece quando seguimos a operação além da tela. Banco, fila, worker e integrações também fazem parte do teste.
Preview não é sinônimo de ambiente inteiro isolado
Um preview deployment coloca uma versão da aplicação à disposição para avaliação antes da publicação final. Pode servir para revisar uma tela, demonstrar uma funcionalidade ou executar testes sobre uma mudança específica.
A documentação da Vercel diferencia URLs de preview associadas à branch, que acompanham suas atualizações, de URLs associadas ao deployment de um commit. Já o GitLab descreve review apps como ambientes temporários criados por branch ou merge request.
Um ambiente efêmero acrescenta outra característica importante: seu ciclo de vida. Ele é criado para uma finalidade delimitada e removido quando deixa de ser necessário. Pode atender a uma revisão humana, uma suíte de testes ou até um experimento sem interface web.
Os conceitos se encontram, mas não são a mesma coisa. Um frontend↳Front-end60 conteúdosFront-end em larga escala: quando seu projeto vira um Frankenstein (e como evitar)Dev (Back & Front) · mar 2026Build e bundling no front-end: 7 decisões que impactam performance de verdadeDev (Back & Front) · abr 2026Como modelar APIs pensando no front-end: 8 práticas para evitar retrabalho entre timesDev (Back & Front) · abr 2026Ver tudo em Dev (Back & Front) → com URL exclusiva pode continuar acessando a API e o banco de homologação. Um ambiente temporário, por outro lado, pode ter API, worker e banco próprios sem oferecer uma tela para alguém abrir no navegador.
Eu começaria definindo o que a avaliação precisa demonstrar. Revisar espaçamento e navegação exige um ambiente bem diferente daquele necessário para validar uma mudança no processamento de pagamentos. Eu decidiria isso antes de escolher a ferramenta.
A URL é exclusiva. O estado também é?
Pense em dois PRs de um sistema de pedidos. Um muda o cálculo de desconto e o outro altera a reserva de estoque. Ambos têm preview, mas usam o mesmo banco de homologação.
Se um teste consumir o estoque esperado pelo outro, os endereços separados não evitarão a interferência. Com workers acontece algo parecido: se os dois previews consumirem a mesma fila, uma mensagem pode acabar processada pela versão errada.
Para decidir o que separar, eu seguiria o caminho da operação que está sendo testada:
Parte do fluxo O que eu verificaria Frontend e API Quais versões estão em execução e como o tráfego chega até elas? Banco de dados↳Banco de dados134 conteúdosSQL ou NoSQL: eis a questão!!Data · mar 2020Banco de dados: como organizar e dar segurança para milhões de dados de loteriasData · mai 20215 serviços gratuitos na cloud para bancos de dados PostgresData · fev 2025Ver tudo em Data → Cada preview tem estado independente? Que credencial impede o acesso ao estado dos demais? Filas e workers Quem pode publicar e consumir as mensagens deste teste? Cache e arquivos: As chaves, objetos e permissões estão separados? Integrações externas: A chamada vai para um sandbox, um simulador ou um sistema compartilhado?
Eu não duplicaria a arquitetura inteira só porque criamos previews. Um serviço compartilhado pode funcionar muito bem quando oferece contratos estáveis e separação adequada dos dados.
O que eu evitaria é compartilhar sem perceber. Nesse caso, o resultado do teste começa a depender do que outra pessoa está fazendo naquele momento.
Criar um namespace também não encerra a discussão. A documentação de multi-tenancy do Kubernetes↳Kubernetes18 conteúdosGerenciamento de infraestrutura multicloud com Kubernetes proporciona otimização e economiaDevSecOps · set 2021Azure Kubernetes Services – AKS: referências gratuitas e dicas para solução de problemas comunsDevSecOps · abr 2019Kubernetes em produção: o que ninguém te conta e você aprende tarde demaisDev (Back & Front) · abr 2026Ver tudo em DevSecOps → apresenta namespaces como parte de um conjunto que inclui autorização, políticas de rede e quotas. O isolamento depende desses controles, da infraestrutura disponível e também do nível de confiança entre os workloads.
E isso não significa que precisamos de Kubernetes para adotar previews. Eu começaria identificando o que realmente pode interferir na validação e só depois decidiria como separar esses recursos.
Press enter or click to view image in full size

Dados de teste não podem ser um detalhe do deploy
A aplicação pode subir sem erros e ainda ser inútil para a revisão. Basta o banco estar vazio enquanto o cenário depende de um pedido com histórico.
Copiar dados de produção resolve rapidamente a falta de registros, mas traz outro problema: informação sensível começa a circular por ambientes que executam código ainda em avaliação.
Eu começaria com dados sintéticos, versionados e reproduzíveis. A massa precisa representar situações que realmente importam para o produto, como pedido cancelado, cliente sem permissão, pagamento recusado ou integração indisponível. Se tudo depender de cadastros preparados à mão, reconstruir o cenário depois de uma falha continuará dando trabalho.
Há plataformas que permitem provisionar a estrutura sem copiar os registros. O Neon documenta branches schema-only, nas quais o banco recebe o schema e depois pode ser preenchido com dados de teste. É uma forma interessante de preparar a massa, embora isso sozinho não resolva a segurança do ambiente.
Migrations merecem atenção parecida. Criar um banco do zero já com o schema novo não demonstra que a atualização funciona sobre a versão anterior. Se eu quiser testar essa passagem, preciso preparar o estado de origem e aplicar a mudança sobre ele.
Mesmo uma migration bem-sucedida sobre uma massa pequena não comprova que teremos tempo aceitável ou ausência de bloqueios com o volume e a concorrência de produção. O preview ajuda a encontrar incompatibilidades mais cedo, mas alguns ensaios operacionais continuam necessários.
Se houver necessidade de usar dados derivados de produção, autorização, minimização, tratamento e retenção desses dados precisam entrar no processo. Criar uma branch do banco não anonimiza os dados por mágica.
O ciclo de vida precisa terminar de verdade
O trabalho não termina quando o link aparece no PR. Antes de entregar o ambiente para revisão, eu gostaria de saber se ele realmente está pronto para o teste esperado.
A abertura do PR pode iniciar build e testes, depois provisionar os recursos, aplicar migrations, carregar os dados e fazer verificações de prontidão. Se a URL aparecer antes de tudo isso terminar, o revisor pode perder tempo investigando uma aplicação que simplesmente ainda não estava pronta.
Junto do link, eu esperaria encontrar:
-
Qual commit está em execução;
-
Qual artefato foi implantado;
-
Qual versão dos dados de teste foi usada;
-
Quais dependências são reais, compartilhadas ou simuladas;
-
Quais testes passaram e onde consultar seus resultados;
-
Quem responde pelo ambiente e quando ele expira.
Tem uma ambiguidade aí que eu acho especialmente fácil de passar despercebida. Um novo push pode atualizar o deployment de uma branch sem mudar sua URL. Quem abre o link depois encontra outra versão, enquanto o comentário de aprovação continua no PR.
Uma URL associada ao commit ajuda a identificar o código, mas os dados e serviços externos ainda podem mudar. Por isso eu registraria junto da aprovação o contexto do teste, não apenas o endereço visitado.
O GitLab oferece mecanismos como on_stop e auto_stop_in para apoiar o encerramento das review apps. Só que marcar o ambiente como parado não comprova que banco externo, bucket ou credencial temporária também foram removidos.
Eu combinaria o encerramento no merge ou no fechamento do PR com um prazo de expiração e uma busca periódica por recursos órfãos. Imagine um pipeline cancelado depois de criar o banco, mas antes de registrar o ambiente. O banco pode continuar existindo sem aparecer no lugar onde o time acompanha os previews.
A limpeza precisa poder ser repetida com segurança e atingir somente os recursos daquele preview. Eu não daria a esse processo uma permissão ampla capaz de alcançar homologação ou produção apenas para simplificar o descarte.
Já os resultados necessários para auditar a revisão podem permanecer pelo prazo definido pelo time. Destruir o ambiente e preservar a evidência do teste são coisas diferentes.
Press enter or click to view image in full size

Código em revisão não merece credenciais de produção
Um preview executa código que ainda está em avaliação, incluindo scripts de build, dependências e mudanças no próprio pipeline. Abrir um PR não torna esse conjunto confiável.
O GitHub alerta para o risco de executar código não confiável em workflows privilegiados, inclusive em usos inadequados de pull_request_target e workflow_run. Automatizar a publicação do preview é ótimo, mas eu não daria a esse código permissões maiores só para facilitar o processo.
PRs externos ou ainda não confiáveis precisam de uma política própria. Uma opção é separar as etapas sem privilégios das operações autorizadas de provisionamento, controlando também quais artefatos e entradas passam de uma etapa para outra. A identidade usada no deploy deveria acessar apenas os recursos que realmente precisa criar ou atualizar.
Esse cuidado continua no runtime. URL difícil de adivinhar não substitui autenticação. Chaves de produção não deveriam estar disponíveis e os efeitos externos precisam ir para destinos controlados: e-mails para um coletor de testes, pagamentos em sandbox e webhooks para endereços permitidos.
Em aplicações que usam modelos de IA↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI →, eu colocaria nessa mesma conta as chaves, o orçamento e as ferramentas acessíveis ao agente. Uma resposta gerada durante a validação não deveria ter autorização para disparar uma operação real em outro sistema.
Dois previews verdes ainda podem produzir um merge vermelho
Separar os ambientes reduz bastante a interferência durante a revisão. Só que ainda precisamos descobrir se as mudanças funcionam juntas.
Dois PRs podem passar nos próprios testes e falhar quando combinados. Um altera o contrato da API enquanto o outro ainda depende do comportamento anterior. Uma migration funciona isoladamente, mas entra em conflito com outra alteração de schema. Nenhum dos previews individuais testou aquela combinação.
Por isso eu não venderia preview deployments como um projeto para eliminar homologação. Começaria retirando dela as validações que não precisam disputar um espaço coletivo e manteria os testes que dependem do conjunto.
Etapa Pergunta principal Preview da mudança Este PR se comporta como esperado nas condições em que foi testado? Validação integrada A combinação das mudanças continua compatível? Validação operacional: O comportamento se sustenta nas condições relevantes de volume, configuração e dependências?
A validação integrada pode acontecer em um ambiente compartilhado com controle de versão e deploy, em um ambiente efêmero de integração ou em testes sobre o resultado combinado das mudanças. Eu escolheria o formato de acordo com o produto e com o que o time precisa descobrir.
O cuidado é não tratar a aprovação de um PR isolado como evidência de uma combinação que nunca foi executada.
Eu também tentaria manter os templates e o processo de build próximos dos usados na entrega real, deixando claras as diferenças de configuração. Um teste de performance executado em uma topologia reduzida, por exemplo, não me diz sozinho qual será a capacidade do ambiente de produção.
Press enter or click to view image in full size

Comece pelo conflito que mais custa ao time
Replicar tudo a cada PR pode custar mais do que o problema que estamos tentando resolver. Para um piloto, eu escolheria um fluxo que sofre bastante com interferência e cujas dependências o time consegue delimitar.
Pode ser uma aplicação web com API e dados sintéticos. Em outro produto, talvez faça mais sentido começar por um serviço com fila exclusiva e simulador de pagamento. Um PR que altera apenas documentação provavelmente não precisa da mesma infraestrutura.
Antes de começar, eu combinaria escopo, responsável, acesso, dados, limites de recursos e descarte. Depois acompanharia o que realmente mudou no trabalho de quem valida:
-
Tempo entre pedir o ambiente e conseguir começar a validação;
-
Tempo de espera por homologação;
-
Testes interrompidos pela interferência de outra mudança;
-
Falhas de provisionamento e limpeza;
-
Custo por ambiente ativo e por validação concluída;
-
Defeitos de integração que os previews individuais não identificaram.
Eu usaria essas métricas para avaliar o piloto, não para anunciar benefícios antes de medir alguma coisa. Sem conhecer a situação anterior, fica difícil saber se melhoramos o processo ou apenas colocamos mais automação nele.
Na conta também entram armazenamento, builds, tráfego, serviços externos e manutenção da plataforma, não apenas compute. Criar recursos sob demanda, limitar concorrência e suspender o que está ocioso pode ajudar. Mas existe um limite prático: se o ambiente nunca está disponível quando o revisor precisa dele, parte da espera que queríamos remover simplesmente voltou com outro nome.
Mais mudanças exigem evidências melhores
Se a IA aumentar o volume de código proposto, depender de um único ambiente compartilhado para toda a validação pode concentrar ainda mais a espera na revisão. Distribuir links por PR ajuda a organizar esse trabalho, mas eu não usaria isso como motivo para reduzir o cuidado na aprovação.
O que me interessa no preview é poder observar o comportamento daquela mudança e manter as evidências próximas do PR. Um agente pode preparar cenários, executar testes e organizar os resultados, mas o time ainda precisa decidir se aqueles cenários cobrem o que deveria ser coberto e quais limitações do ambiente são aceitáveis.
Se cada PR já tem uma URL e homologação continua quebrando, eu olharia primeiro para o que esses previews ainda compartilham. Talvez o banco tenha recebido uma migration de outro PR, a fila esteja sendo consumida por outro worker ou o teste esteja chamando uma API diferente daquela que imaginávamos.
Eu quero conseguir olhar para um teste e saber em quais condições ele foi executado, o que estava isolado, o que continuava compartilhado e o que ainda falta validar antes da entrega.
No seu time, o que mais interrompe a validação em homologação: disputa por deploy, dados compartilhados ou alguma dependência difícil de isolar?

Como monitorar eventos da blockchain com ReactJS e Web3.js

Aplicações Java inteligentes usando Spring AI e Gemini

O banco de dados está no Brasil. Você sabe para onde sua IA envia os dados?
O modelo não fez tudo aquilo. O sistema fez.
 Cezar Taurion
Processamento de Documentos em Larga Escala: Pipeline de OCR Assíncrono com Azure AI Document Intelligence, Azure Functions e PostgreSQL
 Cláudio Raposo
Como criar um bot para copy trade na Binance Spot com Node.js
 Luiz Fernando Duarte Junior
Quando o agente de IA vira funcionário: um problema de identidade
 Ramon Ribeiro