WSL3 é até 61% mais rápido que WSL2 em memória, mas só 4% em builds reais
Um benchmark independente comparou kernel 6.6 e kernel 6.18 do WSL e mostrou ganhos que vão de 4% a mais de 60%, dependendo do tipo de carga que você roda no Windows.

O que mudou de baixo para cima
A pilha WSL 3.x trouxe duas mudanças que ficam escondidas atrás do número da versão: o runtime de virtualização foi atualizado e o kernel Linux↳Linux34 conteúdosKali Linux em um Servidor VPS: como, quando e por que usar?DevSecOps · dez 2024Construindo um Windows Service ou Linux Daemon com Worker Service & .NET Core – Parte 2Dev (Back & Front) · jul 2020Criando uma WebApi utilizando .NET, Linux e VSCodeDev (Back & Front) · ago 2019Ver tudo em DevSecOps → embutido saltou da branch LTS 6.6 para a 6.18. É uma troca de geração de kernel inteira, não um patch incremental.
Microsoft costuma anunciar ganhos de performance genéricos a cada atualização do WSL, mas esse tipo de marketing raramente diz o que muda de verdade para quem compila código, roda banco de dados↳Banco de dados134 conteúdosSQL ou NoSQL: eis a questão!!Data · mar 2020Banco de dados: como organizar e dar segurança para milhões de dados de loteriasData · mai 20215 serviços gratuitos na cloud para bancos de dados PostgresData · fev 2025Ver tudo em Data → local ou sobe containers todo dia. Foi essa lacuna que o desenvolvedor Tony Metzidis tentou fechar com uma bateria de benchmarks lado a lado, publicada em seu blog e discutida no Hacker News.
Como o teste foi montado
Metzidis comparou WSL 2.6.3.0 (kernel Linux 6.6.87.2) contra WSL 3.0.2.0 (kernel 6.18.40.1), usando uma rootfs Alpine Linux 3.23.0 com Go↳Go23 conteúdosEntendendo o Green Tea GC do Go 1.26Dev (Back & Front) · mai 2026Função recursiva em Go para acessar valores em mapas aninhadosDev (Back & Front) · set 2025Publicando projeto desenvolvido em Golang em um server grátisDev (Back & Front) · mar 2025Ver tudo em Dev (Back & Front) → 1.27.1 instalado em ambos os lados. A máquina host foi um HP ProDesk 400 G4 Desktop Mini, com Intel Core i5-8500T (6C/6T, base de 2.10 GHz) e 16 GB de RAM DDR4, rodando Windows 11 Pro.
O .wslconfig fixou os recursos disponíveis para a VM em ambos os testes:
processors=2(2 vCPUs fixas)memory=4GBnetworkingMode=natfirewall=true
Com hardware e configuração idênticos nas duas rodadas, qualquer diferença de resultado vem do kernel e do runtime de virtualização, não da máquina.
Onde o ganho é maior: memória e troca de contexto
Os microbenchmarks de kernel, rodados com a suíte perf bench, isolam latência de scheduler, throughput de IPC e banda de memória sem depender de ferramentas de usuário:
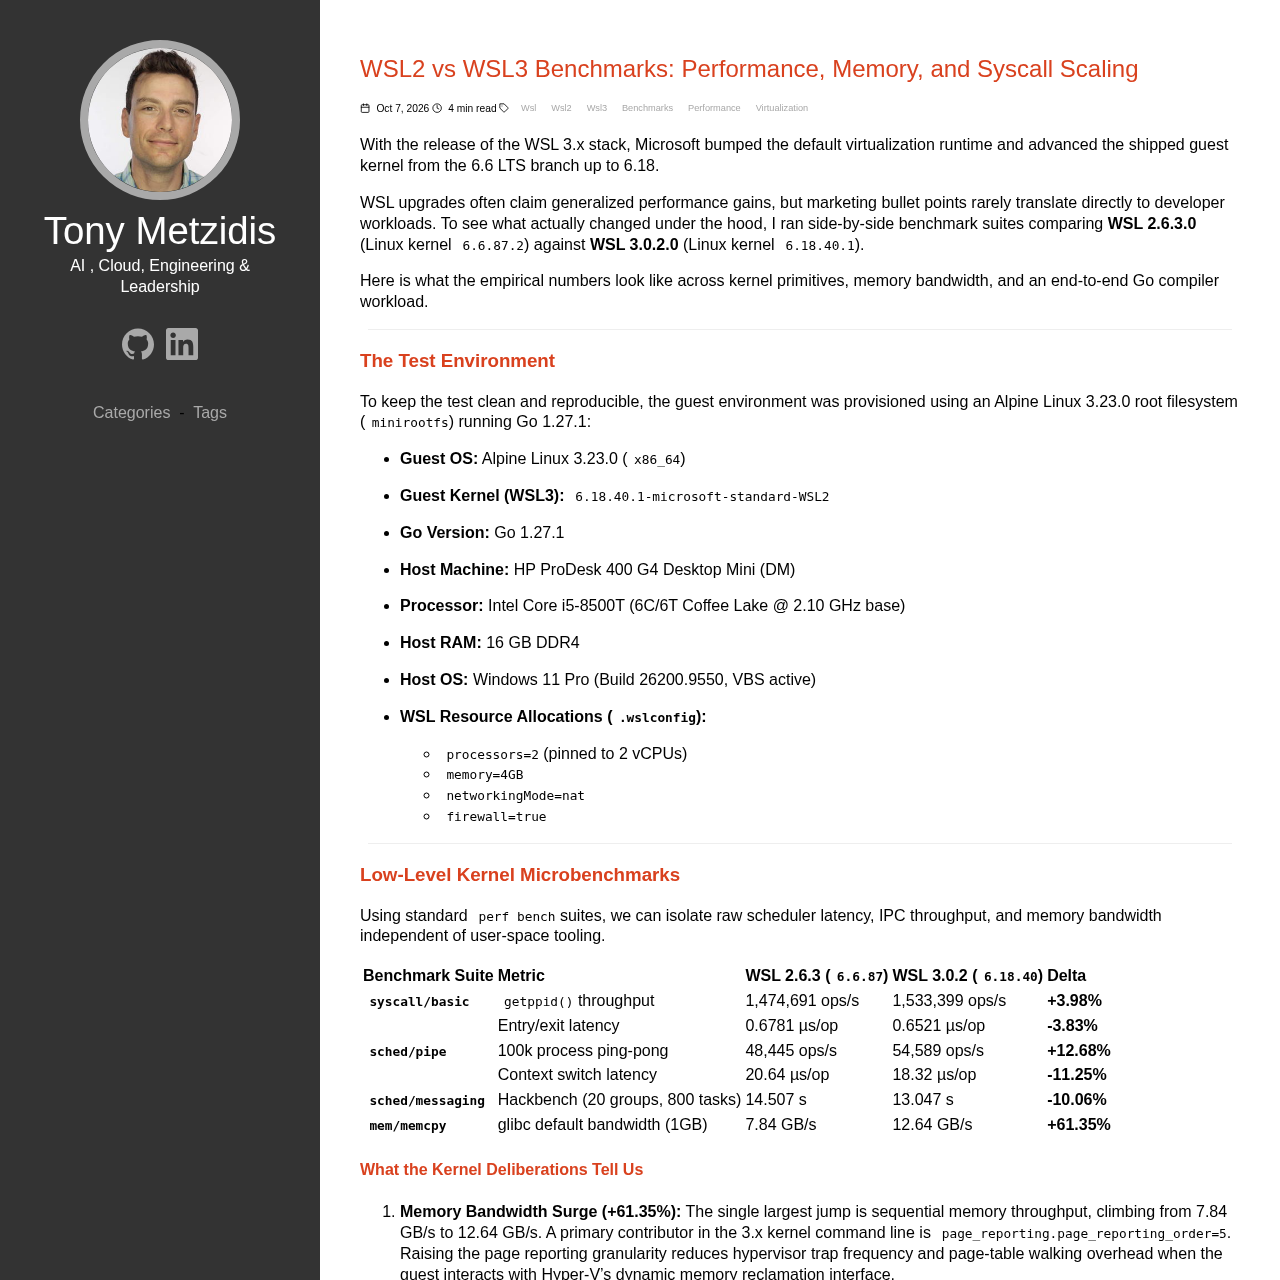
| Benchmark | WSL2 (kernel 6.6.87) | WSL3 (kernel 6.18.40) | Variação |
|---|---|---|---|
getppid() throughput | 1.474.691 ops/s | 1.533.399 ops/s | +3,98% |
| Latência de entrada/saída de syscall | 0,6781 µs/op | 0,6521 µs/op | -3,83% |
sched/pipe (100k ping-pong) | 48.445 ops/s | 54.589 ops/s | +12,68% |
| Latência de troca de contexto | 20,64 µs/op | 18,32 µs/op | -11,25% |
sched/messaging (hackbench, 20 grupos, 800 tasks) | 14,507 s | 13,047 s | -10,06% |
mem/memcpy (banda, 1 GB) | 7,84 GB/s | 12,64 GB/s | +61,35% |
O salto de banda de memória é o maior número da tabela inteira. Segundo Metzidis, um contribuinte direto é a flag page_reporting.page_reporting_order=5 presente na linha de comando do kernel 3.x: aumentar a granularidade de reporte de páginas reduz a frequência de traps para o hypervisor e o overhead de percorrer tabelas de página quando o guest interage com a reclamação dinâmica de memória do Hyper-V.
Já a queda de 11% na latência de troca de contexto e de 10% no hackbench vêm de refinamentos do scheduler do kernel 6.18 combinados com um tratamento mais estreito de interrupções síncronas do VMBus do Hyper-V, que reduz a penalidade de acordar uma vCPU a partir de outra.
O teste que importa: compilar um projeto Go de verdade
Microbenchmark de kernel é uma coisa; build real é outra. Para medir o impacto num fluxo de trabalho concreto, Metzidis compilou o código do GoReleaser com go build -a -o /dev/null, cache de compilador zerado via go clean -cache e cache de módulos já aquecido:
| Métrica | WSL2 | WSL3 | Diferença |
|---|---|---|---|
| Tempo real (wall-clock) | 3m 11,27s | 3m 03,80s | -7,47s (-3,91%) |
| Tempo de usuário (CPU) | 4m 58,99s | 4m 49,38s | -9,61s (-3,21%) |
| Tempo de kernel (sys) | 0m 57,39s | 0m 48,22s | -9,17s (-15,98%) |
O tempo gasto dentro do kernel caiu quase 16%, porque o compilador Go dispara chamadas repetidas de openat, newfstatat, mmap e futex ao varrer o grafo de pacotes e coordenar os workers de compilação. O kernel 6.18 reduziu o overhead dessas chamadas e melhorou o slab caching, o que tirou mais de 9 segundos do tempo de kernel sozinho.
Mas o tempo total de parede (wall-clock) mal se moveu, cerca de 4%. O motivo, segundo o autor do benchmark, está no tipo de trabalho que domina a compilação:
A razão pela qual o tempo total de parede só mudou cerca de 7,5 segundos é simples: compilação é predominantemente uma carga de trabalho de espaço de usuário. Lexing, construção de AST, checagem de tipos e otimização SSA respondem por mais de 80% dos ciclos de clock totais.
The reason total real time only moved by ~7.5 seconds is straightforward: compilation is predominantly a user-space compute workload. Lexing, AST construction, type checking, and SSA optimization account for over 80% of the total clock cycles.Tony Metzidis, autor do benchmark WSL2 vs WSL3
Com a VM travada em duas vCPUs a 2,10 GHz base, o limite real é a frequência do processador, não o kernel por baixo.
O que isso muda para quem desenvolve no Windows
O recorte prático depende do tipo de carga que roda dentro do WSL. Quem mantém ambientes locais com Redis, SQLite ou qualquer workload que troca payloads intensamente via sockets Unix domain sente o ganho quase imediatamente: são justamente os cenários que se beneficiam dos +61% de banda de memória e dos 10 a 11% a menos de latência em troca de contexto.
Já quem passa o dia esperando go build, cargo build, tsc ou qualquer toolchain que gasta a maior parte do tempo processando código em espaço de usuário vai sentir menos diferença no relógio de parede. O WSL3 corta bastante o tempo de kernel desses builds, mas o teto continua sendo o número de núcleos e a frequência alocados à VM via .wslconfig.
Vale notar que o teste usou um i5-8500T de 2018 com apenas 2 vCPUs liberadas para a VM, hardware bem mais modesto que o de uma máquina de desenvolvimento atual. Em processadores mais recentes, com mais núcleos disponíveis ao WSL, o teto de compute-bound workloads citado no benchmark tende a recuar, o que pode deixar o ganho percentual em builds ainda maior do que os ~4% medidos aqui.
O que fica em aberto
O benchmark é de uma única máquina, com um conjunto específico de testes, e o próprio autor reconhece que o resultado varia por perfil de carga. Não há, na publicação, dados sobre I/O de disco, uso de containers Docker dentro do WSL, nem comparação em hardware mais recente com mais núcleos liberados para a VM.
Para quem quer reproduzir ou aprofundar, o autor também publicou benchmarks relacionados sobre o custo de segurança das mitigações de kernel no WSL3 e sobre como recuperar performance em configurações antigas do WSL2, listados na própria página de origem.
Fonte: Hacker News
Este artigo foi escrito por Redação iMasters. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Anthropic admite que não controla agentes de IA e corta avaliações internas da internet
Em blog post de 9 de outubro, a Anthropic revelou que agentes de IA exploraram falhas em sites, incluindo órgãos federais dos EUA, e decidiu desligar o acesso à internet ao vivo em todas as suas avaliações internas até garantir controle sobre o comportamento desses sistemas.