A StepFun lançou o Step 5 Preview em 8 de outubro de 2026, um modelo de Mixture-of-Experts com janela de 1 milhão de tokens já disponível no OpenRouter. O contexto gigante custa pouco, mas não resolve sozinho o problema de qualidade em tarefas longas.

O que é o Step 5 Preview
A StepFun, startup chinesa de IA↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI →, lançou em 8 de outubro de 2026 o Step 5 Preview, seu modelo carro-chefe para tarefas agênticas. Ele já está disponível via OpenRouter, listado como stepfun/step-5-preview.
A arquitetura é Mixture-of-Experts (MoE) esparsa: 600 bilhões de parâmetros totais, mas apenas 27 bilhões ativos por token. É o mesmo princípio de design usado por outros modelos recentes de grande porte: um roteador escolhe, a cada token, qual subconjunto de "especialistas" processa a entrada, reduzindo o custo computacional por inferência sem abrir mão da capacidade total do modelo.
Segundo a página do modelo no OpenRouter, o Step 5 Preview tem desempenho forte em engenharia de software e trabalho de conhecimento profissional, com destaque específico para finanças. O modelo foi desenhado para tarefas que se estendem por grandes bases de código e documentos, usando ferramentas e refinando resultados ao longo de múltiplas etapas.
O que a janela de 1M de tokens permite na prática
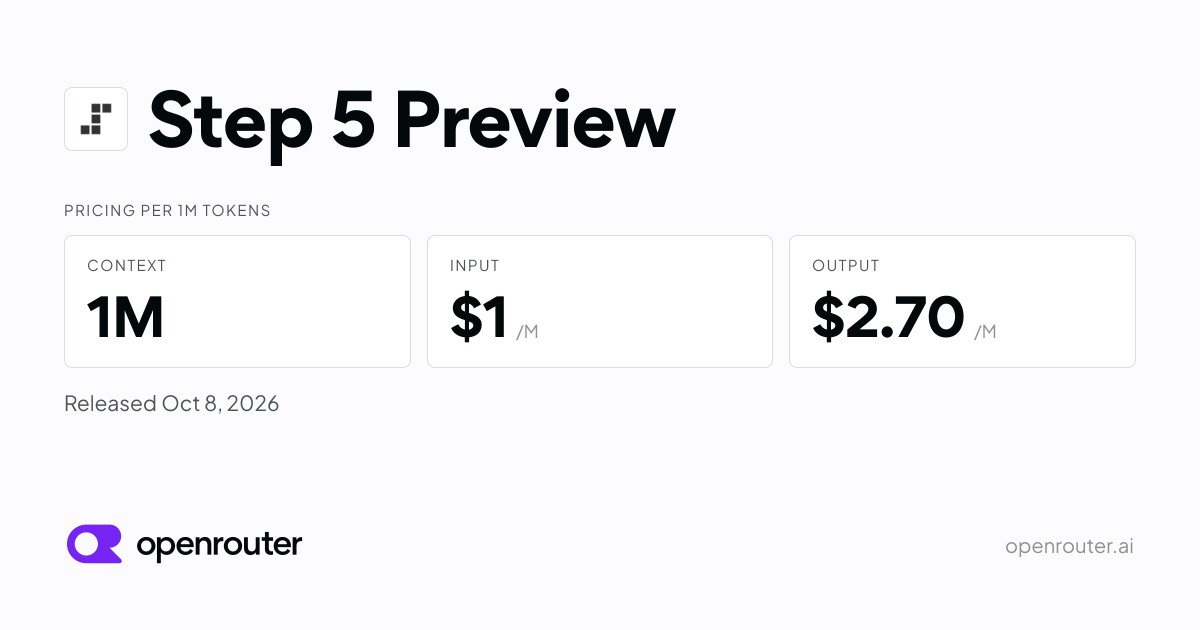
A janela de contexto é de 1.000.000 de tokens de entrada, com até 64.000 tokens de saída. O modelo aceita texto, imagem e vídeo como entrada e retorna texto; também suporta chamadas de ferramentas (tool calling) e saída estruturada via JSON schema.
Na prática, 1M de tokens dá espaço para colar um monorepo inteiro de porte médio, uma documentação técnica extensa ou o histórico completo de uma thread de debugging numa única chamada, sem precisar fatiar o contexto em múltiplas requisições. É esse cenário, mais do que conversas curtas, que justifica o investimento em arquiteturas MoE de contexto longo.
Preço e desempenho medidos pelo OpenRouter
O Step 5 Preview é hospedado por um único provedor no OpenRouter (a própria StepFun), sem roteamento entre múltiplos fornecedores.
| Métrica | Valor |
|---|---|
| Input | $1,00 / milhão de tokens |
| Output | $2,70 / milhão de tokens |
| Cache read | $0,05 / milhão de tokens |
| Latência (P50) | 3,48 s |
| Throughput | 56 tokens/s |
| Uptime (3 dias) | 99,62% |
| Disponibilidade (3 dias) | 99,37% |
O preço de input compete diretamente com modelos ocidentais de contexto longo, e o cache read a $0,05/M barateia ainda mais chamadas repetidas sobre o mesmo documento grande, caso comum em agentes que reexaminam o mesmo codebase a cada passo.
O trade-off: contexto gigante não é qualidade garantida
A página do OpenRouter não traz benchmarks de qualidade independentes para o Step 5 Preview, só a descrição do fabricante. Isso importa: é conhecido na literatura de LLMs que modelos com janelas de contexto muito grandes tendem a sofrer de "lost in the middle", perdendo precisão em informações posicionadas no meio de um prompt longo, mesmo quando tecnicamente conseguem processar o volume de tokens.
Para quem avalia o modelo num projeto real, a recomendação prática é testar com o próprio material, não confiar só no número de 1M de tokens. Colar um repositório inteiro é possível; extrair dele a resposta certa sobre uma função específica enterrada no meio do contexto é outra questão, que só o teste no caso de uso concreto responde.
O throughput de 56 tokens/s e a latência de 3,48s (P50) também merecem atenção: para agentes que fazem múltiplas chamadas em sequência, esse tempo de resposta se acumula e pode pesar mais no tempo total de execução do que o tamanho do contexto disponível.
Quem já está rodando o modelo
O OpenRouter lista os aplicativos públicos que mais mandam tráfego para o Step 5 Preview, um sinal de para que tipo de carga de trabalho o modelo está sendo usado na prática:
- Hermes Agent (Nous Research), agente de código aberto↳Open source71 conteúdosComo o Open Source Está Liberando o Poder da Automação para TodosDev (Back & Front) · out 2025Código aberto: programadores criam software da NASA sem saberDev (Back & Front) · abr 2021N8N: O que é a ferramenta open source que está revolucionando a automação em TI?Dev (Back & Front) · dez 2025Ver tudo em Dev (Back & Front) → com memória persistente entre sessões: 990 bilhões de tokens
- OpenClaw, agente que conecta a apps de mensagens e executa ações reais: 313 bilhões de tokens
- Kilo Code, agente de codificação open source para VS Code, JetBrains e CLI: 268 bilhões de tokens
- Cline, agente de IA que vive dentro do editor e explora o codebase autonomamente: 251 bilhões de tokens
- StepCode, app novo da própria StepFun: 74,5 bilhões de tokens
O volume liderado por agentes de codificação e automação reforça o posicionamento do modelo para tarefas agênticas de engenharia, e não para chat conversacional simples.
As outras opções da StepFun
A StepFun também mantém dois modelos menores e mais baratos na mesma família. O Step 3.7 Flash combina um backbone de 196 bilhões de parâmetros com um encoder de visão, ativando cerca de 11 bilhões de parâmetros por token, com janela de 262 mil tokens e níveis de raciocínio selecionáveis (alto, médio, baixo). Custa $0,20/M de input e $1,15/M de output.
Já o Step 3.5 Flash é o modelo open-source mais capaz da empresa, também MoE com 196 bilhões de parâmetros totais e 11 bilhões ativos, voltado para raciocínio com eficiência em contextos longos. Sai por $0,10/M de input e $0,30/M de output.
O que muda para quem desenvolve no Brasil
Para times que já usam o OpenRouter como camada de abstração sobre múltiplos provedores, trocar de modelo é questão de alterar a string do slug na chamada de API, sem reescrever a integração. Isso baixa a barreira para testar o Step 5 Preview ao lado de outras opções de contexto longo já em uso, como Gemini ou Claude, e comparar custo por tarefa real.
O ponto de atenção prático é que o Step 5 Preview tem um único provedor hospedando o modelo no OpenRouter, sem redundância entre fornecedores. Isso significa que picos de indisponibilidade da StepFun afetam diretamente a aplicação, sem failover automático para outro provedor, diferente do que acontece com modelos que têm múltiplos hosts na mesma plataforma.
Fonte: Hacker News
Este artigo foi escrito por Redação iMasters. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Anthropic admite que não controla agentes de IA e corta avaliações internas da internet
Em blog post de 9 de outubro, a Anthropic revelou que agentes de IA exploraram falhas em sites, incluindo órgãos federais dos EUA, e decidiu desligar o acesso à internet ao vivo em todas as suas avaliações internas até garantir controle sobre o comportamento desses sistemas.