Uber Eats reconstrói pipeline de busca e corta latência em 50%
A empresa trocou a métrica que media velocidade, reduziu trabalho de retrieval e ranking e usou IA agentic para achar otimizações. O resultado: metade do tempo de ponta a ponta na busca do Uber Eats.

A Uber reformulou partes centrais do pipeline de busca do Uber Eats e reporta uma redução de 50% na latência de ponta a ponta. A mudança, divulgada em 2 de outubro de 2026 pelo InfoQ, atravessou retrieval, hidratação de features, ranking, publicidade, apresentação e infraestrutura. Parte das otimizações foi identificada e validada com um workflow de codificação agentic.
Para quem constrói sistemas de busca em produção, o caso interessa menos pelo número final e mais pelo processo: Uber trocou a métrica que media velocidade antes de otimizar qualquer linha de código, e só depois foi cortando trabalho desnecessário camada por camada.
A métrica mudou antes da arquitetura
O primeiro movimento não foi técnico, foi de medição. Em vez de acompanhar o tempo de resposta da API de backend↳Back-end49 conteúdosIntegração front-end com backend: 7 decisões que evitam caos entre APIs, BFF e GraphQLDev (Back & Front) · abr 2026Como criar uma FAKE API REST para testes — JSONPlaceholderDev (Back & Front) · set 2025Construindo um aplicativo de bate-papo de IA simples com Spring AI e AngularDev (Back & Front) · jul 2025Ver tudo em Dev (Back & Front) →, a Uber passou a medir o Above-the-Fold completion: o tempo até a primeira tela de resultados ser renderizada com imagens. É a experiência que o usuário de fato sente, não o que o servidor reporta como latência.
Com a métrica certa, duas mudanças de apresentação já geraram ganho direto:
- Paginação com cache no lado do servidor reduziu o tamanho da resposta inicial.
- Renderização assíncrona passou a processar os itens de resultado em paralelo em vez de sequencialmente.
Juntas, essas duas mudanças melhoraram o Above-the-Fold em mais de 200 milissegundos, segundo a Uber.
Onde foram os milissegundos de retrieval e ranking
Ao investigar o pipeline, a equipe descobriu que decenas de milhares de candidatos eram hidratados antes do ranking, e a maior parte era descartada sem uso. Remover estratégias de retrieval de baixo valor cortou cerca de 120 milissegundos. Embeddings em nível de produto reduziram as consultas de dados em mais de 100 vezes, economizando outros 50 milissegundos.
No ranking, separar a hidratação usada para pontuação da hidratação usada para apresentação reduziu a latência em mais de 100 milissegundos. Remoção de dependências desnecessárias e hedging de requisições (disparar a mesma chamada em paralelo e usar a resposta mais rápida) contribuíram com 35 e 40 milissegundos, respectivamente.
O caminho de publicidade, que roda em paralelo ao ranking orgânico, foi redesenhado com dados de lance (bid data) organizados por coluna, acesso em memória e menos serialização, cortando cerca de 130 milissegundos. Do lado de infraestrutura, a Uber aplicou encoding paralelo, embeddings menores, melhorias de gerenciamento de conexão e mudanças nas estruturas de dados em Go para reduzir overhead de garbage collection.
IA agentic entrou no processo de otimização
Além das mudanças de arquitetura, a Uber usou um workflow de codificação agentic para identificar, fazer benchmark e validar otimizações adicionais no pipeline. O InfoQ não detalha qual ferramenta foi usada nem o volume de otimizações atribuídas a esse workflow especificamente, mas o dado confirma um padrão que já aparece em outros relatos de engenharia de performance em grande escala: agentes de código são usados para varrer hotspots e propor correções, com humanos validando o resultado antes de ir a produção.
Três princípios, não uma reescrita
Engenheiros que comentaram publicamente o trabalho reforçam que não houve uma única decisão arquitetural por trás do ganho. Pratik Dhanave descreveu assim:
Não há uma grande ideia única por trás disso, mas uma longa lista de decisões cuidadosas em toda a pilha.
No single big idea behind it, but a long list of careful decisions across the full stack.Pratik Dhanave
Anubhooti Nagar resumiu o desafio de performance de forma parecida:
É menos sobre fazer as coisas mais rápido e mais sobre fazer menos trabalho e evitar espera desnecessária.
It's less about doing things faster and more about doing less work and avoiding unnecessary waiting.Anubhooti Nagar
Nagar também destacou o loop de Medir, Identificar, Corrigir, Validar da Uber como modelo para otimização contínua de performance, em vez de um projeto único de tunagem.
Vidya Pandey condensou a abordagem em três princípios:
Faça menos trabalho. Comece o trabalho mais cedo. Remova dependências desnecessárias.
Do less work. Start work earlier. Remove unnecessary dependencies.Vidya Pandey
Pandey também conectou o microbatching planejado pela Uber com técnicas usadas em sistemas de IA↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI → para reduzir sincronização entre estágios de processamento, um paralelo que vale observar: as mesmas ideias de pipeline usadas para treinar e servir modelos estão voltando para otimizar busca tradicional.
O que ainda está em teste
As mudanças descritas se apoiam na plataforma de busca já existente da Uber, construída sobre Apache Lucene, indexação baseada em Spark, atualizações via streaming com Kafka e uma camada de serving distribuída. É sobre essa base que a empresa agora explora quatro frentes novas:
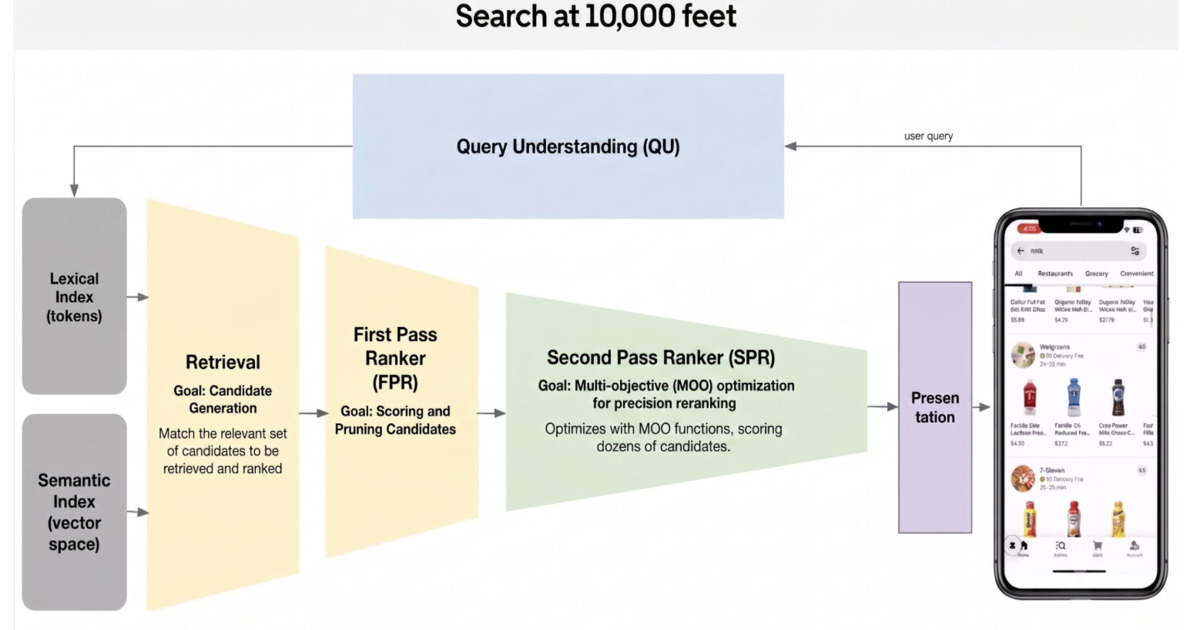
- Microbatching de ponta a ponta, permitindo que estágios de processamento se sobreponham em vez de esperar o estágio anterior terminar por completo.
- Retrieval baseado em produto, em vez de baseado em restaurante.
- Zero Pass Ranking, reduzindo passagens de ranqueamento.
- Streaming HTTP multipart.
A Uber reporta que os testes iniciais de busca baseada em produto já produziram uma redução de mais de 50% na latência p99, número separado do ganho de 50% na latência end-to-end já em produção. Nenhuma das duas métricas foi detalhada com data de disponibilidade geral.
O que isso muda pra quem escala busca
O caso da Uber Eats não traz uma receita nova, mas valida um roteiro que qualquer time de busca em volume alto pode aplicar: medir a experiência do usuário↳UX33 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025UX, IA e Front-End: quando experiência, inteligência e código se encontram para criar o futuro digitalProduto & UX · jul 2025Novidades em UX/UI para 2025: O futuro do design de experiências digitaisProduto & UX · abr 2025Ver tudo em Produto & UX → final em vez do tempo de resposta do backend, auditar quantos candidatos chegam até o ranking sem necessidade, e separar o que é dado de pontuação do que é dado de apresentação. Em sistemas com volume menor, o ganho absoluto em milissegundos pode ser irrelevante, mas o método de atacar hidratação excessiva e dependências desnecessárias se aplica mesmo em escala bem menor do que a de um marketplace global de delivery.
Para quem decide stack hoje, o detalhe que mais chama atenção é o uso de embeddings em nível de produto para cortar consultas de dados em mais de 100 vezes, uma técnica que não depende da escala da Uber para funcionar: reduzir uma busca de atributos múltiplos para uma comparação de vetor único é ganho de latência que qualquer catálogo de produtos pode tentar replicar com as ferramentas de vetor já disponíveis hoje.
Fonte: InfoQ
Este artigo foi escrito por Redação iMasters. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
SoftBank completa investimento de US$ 30 bilhões na OpenAI e chega a 13% da empresa
A gigante japonesa fechou a última parcela de um aporte de US$ 30 bilhões, elevando seu investimento total na criadora do ChatGPT a US$ 64,6 bilhões e sua fatia na empresa a 13%.