PS5LM roda modelos GGUF via llama.cpp dentro de um PS5 jailbroken
Projeto de código aberto coloca o llama.cpp para rodar na GPU do console e expõe o modelo carregado por uma API compatível com OpenAI e Anthropic, acessível a qualquer dispositivo da rede local.
- Leitura
- 6 min
- Tabelas
- 1
- Código
- 1
- Fontes
- 1
PS5LM roda modelos GGUF via llama.cpp dentro de um PS5 jailbroken
Projeto de código aberto↳Open source71 conteúdosComo o Open Source Está Liberando o Poder da Automação para TodosDev (Back & Front) · out 2025Código aberto: programadores criam software da NASA sem saberDev (Back & Front) · abr 2021N8N: O que é a ferramenta open source que está revolucionando a automação em TI?Dev (Back & Front) · dez 2025Ver tudo em Dev (Back & Front) → coloca o llama.cpp para rodar na GPU do console e expõe o modelo carregado por uma API compatível com OpenAI e Anthropic, acessível a qualquer dispositivo da rede local.
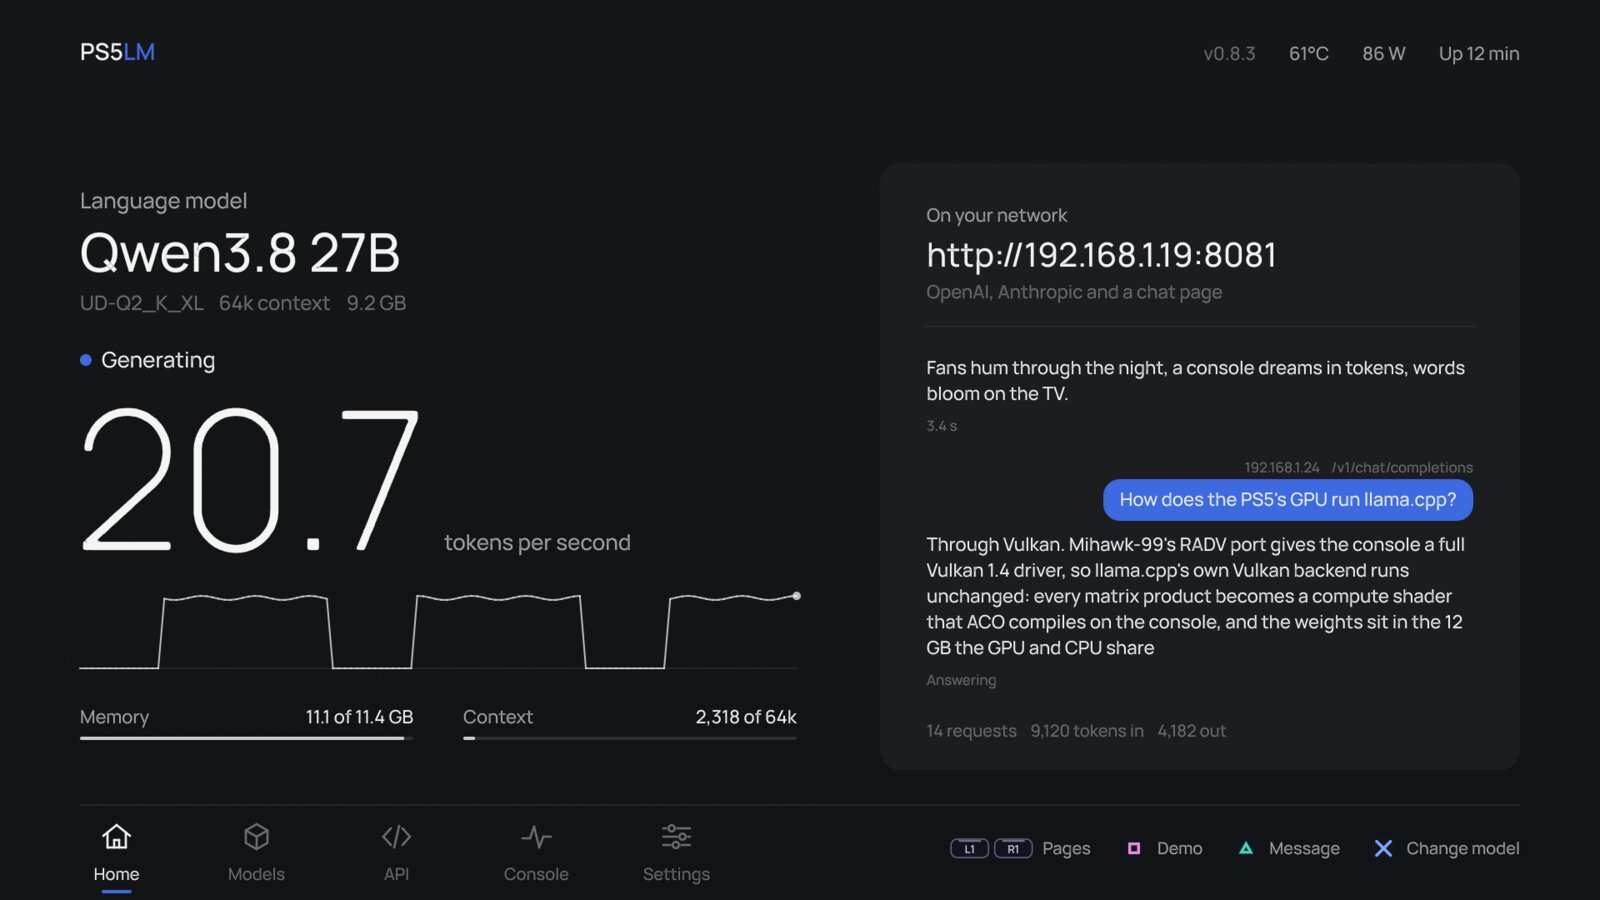
Nota da redação: a legenda da imagem abaixo cita '20,7 tokens por segundo' para o Qwen 3.8 27B. Essa precisão não consta no README do projeto, que fala apenas em 'about 20 tokens a second'. A tabela de desempenho no corpo deste artigo usa a cifra correta, '~20 tokens/s'; a casa decimal na legenda da imagem não tem fonte e deve ser desconsiderada pelo leitor.
O console virou servidor de inferência
O PS5LM é um projeto de código aberto que roda o llama.cpp direto na GPU de um PlayStation 5 com jailbreak, carrega um modelo em formato GGUF e serve esse modelo para qualquer notebook, celular ou ferramenta de linha de comando conectado à mesma rede. Não precisa de PC ligado, de nuvem nem de conta em serviço nenhum: o próprio console vira o servidor.
A interface roda na TV, com abas de Home, Models, Console, API e Settings navegáveis pelo controle. É possível trocar de modelo, baixar um novo direto do Hugging Face, acompanhar temperatura e uso de GPU/CPU, e ver cada requisição chegando em tempo real na tela, com o dispositivo que perguntou e a resposta sendo escrita.
Por baixo do capô: Vulkan, RDNA 2 e memória compartilhada
O projeto usa o backend Vulkan do llama.cpp sobre a GPU RDNA 2 do console, através do PS5_Vulkan, uma camada construída sobre os drivers RADV do Linux↳Linux34 conteúdosKali Linux em um Servidor VPS: como, quando e por que usar?DevSecOps · dez 2024Construindo um Windows Service ou Linux Daemon com Worker Service & .NET Core – Parte 2Dev (Back & Front) · jul 2020Criando uma WebApi utilizando .NET, Linux e VSCodeDev (Back & Front) · ago 2019Ver tudo em DevSecOps → adaptados para rodar no PS5. Até 11,4 GB da memória compartilhada do aparelho ficam disponíveis para o modelo e seu contexto, e todas as arquiteturas e quantizações que o llama.cpp já suporta funcionam sem adaptação extra.
Um planejador interno lê cada arquivo GGUF antes de carregar e escolhe automaticamente o maior contexto e o melhor cache que cabem na memória livre naquele momento. Modelos com projetor de imagem, como Gemma 4, MiniCPM-V e d1, também funcionam, aceitando fotos tanto no chat quanto nas consultas de decisão.
Desempenho medido em um PS5 Slim
O repositório publica uma tabela de referência rodada em um PS5 Slim:
| Modelo | Tamanho | Desempenho |
|---|---|---|
| Qwen 3.5 0.8B (Q4_K_M) | 0,5 GB | 207 tokens/s |
| Qwen 3.5 9B (Q4_K_M) | 5,3 GB | 55 tokens/s |
| Qwen 3.8 27B (UD-Q2_K_XL) | 9,2 GB | ~20 tokens/s, contexto de 64k |
| d1 Omni 600M (decisão) | 1,1 GB | 3 perguntas em 0,3s; imagem 720p + 7 perguntas em 2,9s |
São números do próprio README do projeto, não medição independente, mas dão uma ideia concreta de que modelos de até ~10B parâmetros quantizados rodam em velocidade de conversação em tempo real num hardware que já está na sala de milhões de brasileiros.
Fala a língua que as ferramentas de dev já entendem
O servidor expõe /v1/chat/completions no formato da OpenAI e /v1/messages no formato da Anthropic, além de uma página de chat que abre em qualquer navegador. Isso significa apontar um client existente para http://<console>:8081 e usar o modelo carregado como se fosse qualquer outro provedor de API.
A documentação do projeto confirma que o Claude Code funciona apontando para esse endpoint, e o arquivo docs/CLI.md do repositório cobre o uso a partir de ferramentas como opencode e Codex. Na prática, dá para programar com assistência de IA↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI → sem mandar uma linha de código para fora da própria rede doméstica.
Modelos de decisão: resposta tipada sem gerar texto
Além de gerar texto, o PS5LM carrega os chamados "decision models" (d1, Clef, OpenJev, entre outros) e responde ao endpoint /v1/systemone, o mesmo formato que o projeto Ollaya usa para rodar esse tipo de modelo em PC. A ideia é fazer o modelo responder perguntas tipadas sobre um texto em uma única passagem, sem gerar nenhuma palavra:
curl http://<console>:8081/v1/systemone -H 'Content-Type: application/json' -d '{
 "state": "I was charged twice this month. Refund me or I cancel.",
 "questions": {
 "intent": {"type": "choice", "instructions": "What does the customer want?",
 "criteria": {"refund": null, "information": null, "cancel": null}},
 "angry": {"type": "noul", "instructions": "Is the customer angry?"}
 }
}'
Para quem constrói chatbots de atendimento ou pipelines de classificação de intenção, isso é uma alternativa de baixa latência a mandar cada mensagem para um modelo generativo completo só para extrair uma categoria.
O preço de entrada: um PS5 fora do suporte oficial
Nada disso funciona em um PS5 de fábrica. O requisito é um console em firmware entre 7.00 e 13.60, já jailbroken, com os seguintes payloads carregados:
- kstuff-lite: os patches de kernel que permitem rodar homebrew, obrigatório;
- etaHEN: o suporte a homebrew em si;
- ShadowMountPlus: coloca o PS5LM na tela inicial a partir de
/data/homebrew; - elfldr (porta 9021): telemetria de temperatura, energia e espaço livre, via ps5-exporter, recomendado;
- ftpsrv (porta 2121): usado para instalar o app e copiar modelos de um PC.
A instalação é manual: copiar a pasta PPSA99575 para /data/homebrew via FTP, abrir o app, baixar um modelo pela aba Suggested ou colocar um .gguf em PS5LM/models (interno ou num pendrive) e carregar. O README é explícito: o projeto não tem qualquer vínculo com a Sony, e não distribui arquivos de SDK, chaves, firmware ou pesos de modelo de terceiros.
Fazer jailbreak em um PS5 significa rodar o console fora do suporte e das atualizações oficiais do fabricante, e o próprio intervalo de firmware aceito (7.00 a 13.60) já deixa de fora quem atualizou o aparelho para versões mais recentes. É um caminho técnico, não um recurso de produto, e quem for atrás precisa entender que está em terreno não suportado pela Sony antes de decidir.
Por que isso importa para quem desenvolve no Brasil
GPU dedicada boa o suficiente para rodar modelos de 9B a 27B parâmetros custa caro aqui, e nuvem com GPU cobra por hora de uso. O PS5LM aponta para um caminho diferente: hardware que boa parte dos devs brasileiros já tem debaixo da TV, com GPU RDNA 2 ociosa fora do horário de jogo, virando banco de testes para prototipar agentes, validar prompts ou rodar modelos de classificação sem depender de internet nem de cartão de crédito internacional.
O projeto também mostra a profundidade da cena de homebrew por trás disso: ele nasceu do PS5LM Plus, de abhi245y, e se apoia no PS5_Vulkan de Mihawk-99, nos patches de driver do PS5CEMU-HAR, na interface ps5-homebrew-ui de BlackBearReloaded e no SDK de John Törnblom, além do llama.cpp e do ggml fazendo o trabalho pesado de inferência. É licenciado em GPL-3.0, com o código em github.com/cobanov/PS5LM, e no fechamento desta matéria somava 424 estrelas e 24 forks no repositório.
Fica em aberto o quanto esse caminho escala: a memória compartilhada do console trava o tamanho prático dos modelos bem abaixo do que uma GPU dedicada recente aguenta, e cada atualização de firmware da Sony é uma ameaça real ao jailbreak que sustenta tudo isso. Para quem só quer testar um modelo local sem gastar com hardware novo, ainda assim, é a oportunidade mais barata que existe hoje.
Fonte: Hacker News
Este artigo foi escrito por Redação iMasters. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.

CRA da União Europeia transforma supply chain security em obrigação de código para quem exporta pro bloco
Um podcast da InfoQ com o CTO da OpenSSF detalha como ferramentas como Scorecard e SLSA viraram caminho prático para cumprir o Cyber Resilience Act, a lei europeia que já afeta quem exporta software para o bloco.