H100 custa de US$ 2,69 a US$ 12,29 por hora, dependendo de onde você aluga

- Leitura
- 5 min
- Tabelas
- 1
- Fontes
- 1
Levantamento comparou o preço do mesmo H100 SXM 80GB em AWS, Azure e neoclouds como RunPod: para o chip idêntico, a diferença chega a 4,57 vezes por hora de uso.
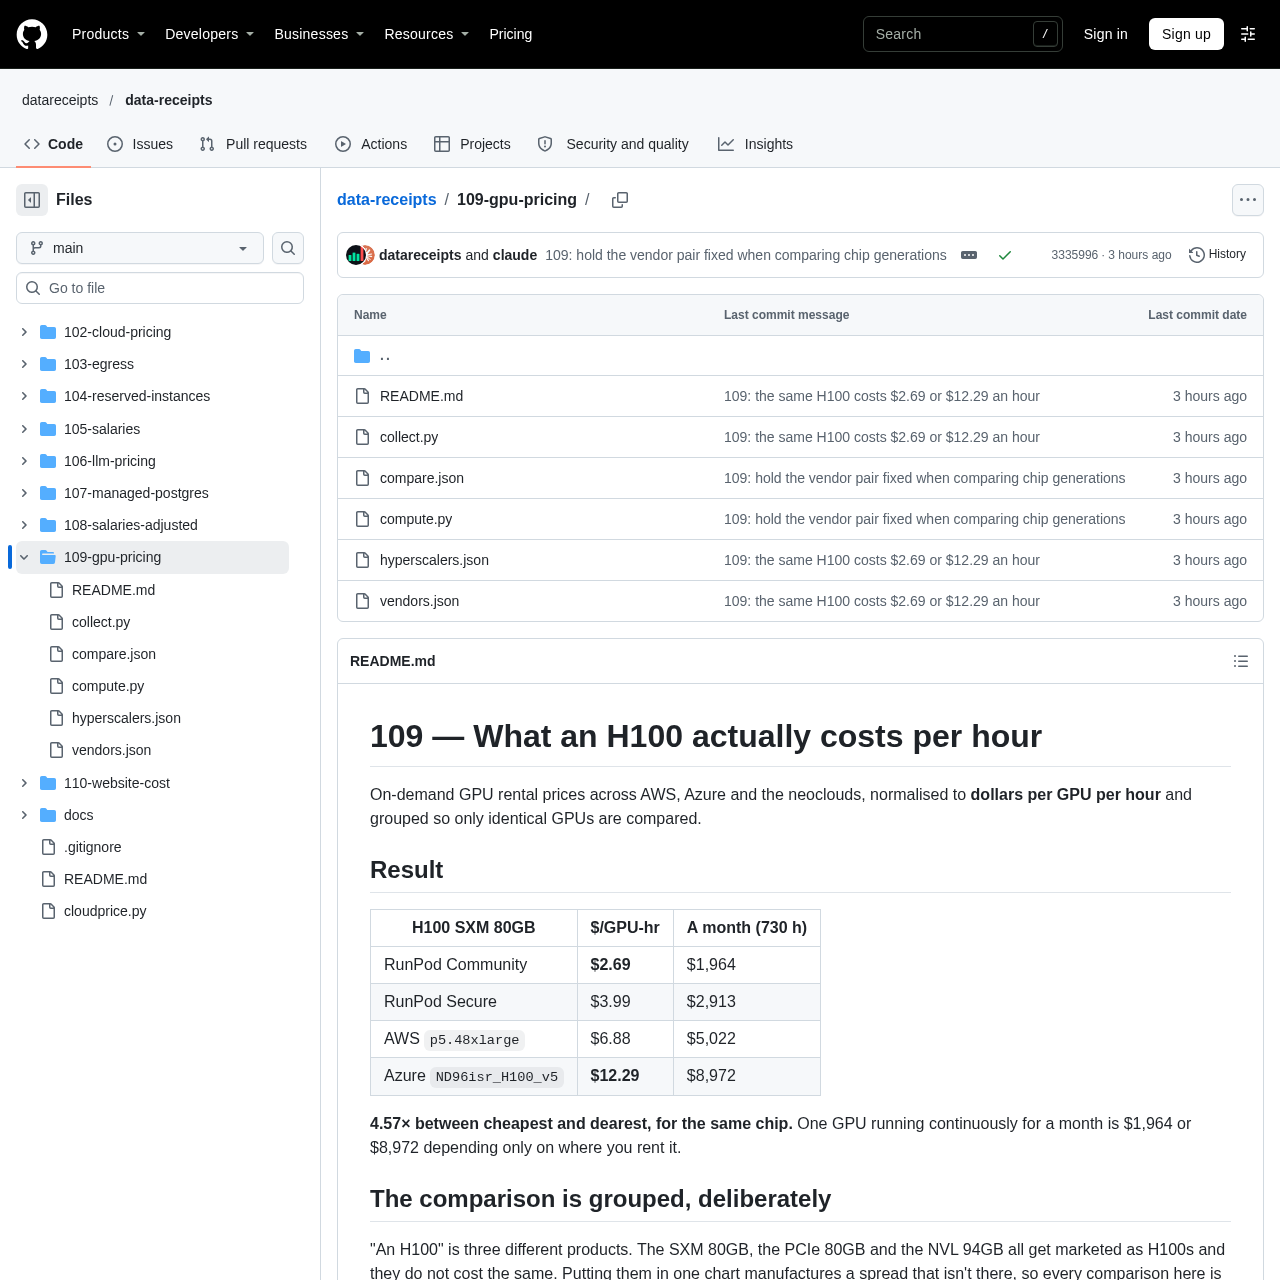
Um levantamento publicado no repositório data-receipts, no GitHub, comparou o preço por hora do mesmo modelo de GPU em diferentes provedores de nuvem e chegou a um número que deveria incomodar quem aprova orçamento de infraestrutura de IA↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI →: o H100 SXM 80GB, quando alugado sob demanda, custa de US$ 2,69 a US$ 12,29 por hora dependendo de onde você aluga. Rodando o chip 24 horas por dia durante um mês (730 horas), isso é a diferença entre US$ 1.964 e US$ 8.972 pela mesma peça de hardware.
O dado vem do diretório 109-gpu-pricing do repositório, que usa as APIs oficiais de preço da AWS↳AWS20 conteúdosE-mails de verificação com AWS SES + Lambda (Node.js) e Terraform: do zero ao envioDevSecOps · out 2025Codex na AWS: chegada do agente da OpenAI à nuvem da AmazonDevSecOps · abr 2026Salesforce e AWS ampliam colaboração em IA, CRM e marketplaceDevSecOps · nov 2023Ver tudo em DevSecOps → e da Azure (collect.py puxa o AWS Price List e o Azure Retail Prices, sem autenticação) e cruza com preços de neoclouds transcritos manualmente, com data e URL de origem registradas em vendors.json.
O gap de preço, em números
A comparação é restrita ao H100 SXM 80GB, a mesma variante de GPU em todos os provedores:
| Provedor | VM/SKU | US$/GPU-hora | US$/mês (730h) |
|---|---|---|---|
| RunPod Community | hardware de terceiros | $2.69 | $1.964 |
| RunPod Secure | - | $3.99 | $2.913 |
| AWS | p5.48xlarge | $6.88 | $5.022 |
| Azure | ND96isr_H100_v5 | $12.29 | $8.972 |
A razão entre a ponta mais barata e a mais cara é 4,57 vezes. RunPod Secure e RunPod Community são contadas como a mesma empresa no cálculo, já que a Community é só uma camada de hardware de terceiros hospedado pela mesma plataforma.
Um H100 não é sempre o mesmo H100
A metodologia do levantamento evita um erro comum em comparação de preço de GPU: tratar "H100" como um produto único. Existem pelo menos três variantes vendidas sob esse nome, com memória e interconexão diferentes, o SXM 80GB, o PCIe 80GB e o NVL 94GB, e misturá-las infla artificialmente o spread. Por isso cada comparação no repositório é feita dentro de um único grupo de (modelo, memória).
O mesmo cuidado vale dentro de um único provedor. A Azure vende o A100 PCIe 80GB em VMs de uma, duas e quatro GPUs, e o preço por GPU muda: $3.67 na VM de uma GPU, $4.78 nas de duas e quatro. Se a comparação pegasse a configuração errada de cada lado, uma diferença de preço dentro da própria Azure apareceria como se fosse diferença de mercado entre provedores. O levantamento sempre usa a rota mais barata de cada vendor até a GPU específica.
O que o preço barato não inclui
Em resumo: os 4,57x não são margem pura, o README do projeto é explícito sobre isso. Sair da SKU ND96isr_H100_v5 da Azure para o RunPod Community significa abrir mão de três coisas concretas:
- InfiniBand de alta velocidade. A SKU ND da Azure tem 400 Gbps por GPU de interconexão Quantum-2 com GPU Direct RDMA, o que viabiliza treino distribuído entre múltiplos nós. É essa interconexão que justifica a SKU ND custar mais do que a própria SKU
NCda Azure para um único H100, que sai a $6.98 por hora. - SLA de datacenter. O RunPod Community é hardware de terceiros alugando capacidade própria, sem a garantia operacional de um datacenter de hyperscaler.
- Compliance corporativo, capacidade reservada e o resto da superfície de um hyperscaler, que pesa em contrato com empresas grandes mas não em uma instância isolada.
O projeto resume o trade-off de forma direta: quem faz fine-tuning em um único nó está pagando por uma interconexão que nunca vai usar; quem treina em 64 nós não tem a linha barata como opção.
Quando vale pagar mais (e quando não vale)
Esse recorte importa na prática para quem decide onde rodar carga de IA no dia a dia. Inferência, fine-tuning de modelo único e experimentação em um nó só não se beneficiam de InfiniBand de 400 Gbps entre GPUs que nunca vão se comunicar entre máquinas, então a diferença de $6,88 (AWS p5.48xlarge) para $2,69 (RunPod Community) é dinheiro deixado na mesa sem ganho técnico correspondente.
Já treino distribuído de verdade, com checkpoint síncrono entre dezenas de nós, depende da interconexão que só a SKU cara oferece: tentar economizar ali tende a estourar o tempo de treino e anular a economia de hora. A decisão de onde alugar GPU, portanto, não é só sobre o preço por hora listado: é sobre que parte da pilha de hardware o workload de fato usa.
Os números têm limites explícitos
O próprio repositório documenta as limitações do método, o que vale reproduzir porque muda a leitura prática do spread:
- São preços de lista sob demanda. Preço reservado, de uso comprometido ou spot corta os números do hyperscaler, e o spot em particular estreitaria bastante a diferença entre os 4,57x.
- Uma região por provedor. AWS em
us-east-1, Azure emeastus; preços variam por região. - A contagem de GPUs por VM vem da documentação do fabricante, não do rótulo de preço, já que a AWS reporta "640 GB HBM3" para a
p5e a Azure reporta memória total do acelerador, sem declarar o modelo por GPU em nenhuma das duas. - A Lambda Labs ficou de fora do spread principal. A página pública da empresa informa que as tarifas listadas passam a valer em 16 de novembro de 2026; as tarifas atuais estão atrás de login, então os dados da Lambda aparecem separados e rotulados no repositório, não misturados ao cálculo do 4,57x.
- Disponibilidade não entra no preço. Um H100 barato que você não consegue provisionar não é, na prática, um preço.
Quem quiser reproduzir ou atualizar a comparação tem o pipeline completo publicado: rodar python3 collect.py baixa o índice de preços da AWS (cerca de 1 GB) e os preços de varejo da Azure, e python3 compute.py refaz o agrupamento e o cálculo do spread a partir de hyperscalers.json, vendors.json e compare.json. Para equipe de engenharia que decide onde rodar carga de GPU com alguma regularidade, essa é uma planilha de referência melhor do que confiar na página de preço de um único provedor.
Fonte: Hacker News
Highlights
- H100 SXM 80GB custa entre US$ 2,69 e US$ 12,29 por hora conforme o provedor
- RunPod Community oferece a rota mais barata; Azure ND, a mais cara com InfiniBand
- Para fine-tuning em nó único, pagar por InfiniBand de 400 Gbps não gera ganho técnico
- Treino distribuído de verdade depende da interconexão cara; economizar ali anula a economia
- Repositório GitHub publica pipeline completo para reproduzir e atualizar a comparação
Este artigo foi escrito por Redação iMasters. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Pinterest substitui pipeline de clustering por LLM Qwen3 de 4B parâmetros
O Pinterest trocou um pipeline de clustering hierárquico por um LLM Qwen3 de 4 bilhões de parâmetros para inferir os objetivos de longo prazo de quem usa o app, com ganhos de até 1,3% em métricas de engajamento, segundo reportagem da InfoQ.