Pinterest substitui pipeline de clustering por LLM Qwen3 de 4B parâmetros

- Leitura
- 5 min
- Fontes
- 1
O Pinterest trocou um pipeline de clustering hierárquico por um LLM Qwen3 de 4 bilhões de parâmetros para inferir os objetivos de longo prazo de quem usa o app, com ganhos de até 1,3% em métricas de engajamento, segundo reportagem da InfoQ.
O Pinterest trocou o sistema que infere o que cada usuário está tentando fazer na plataforma, batizado internamente de "journey" (jornada), de um pipeline clássico de clustering para um modelo de linguagem↳LLMs48 conteúdosConsiderações básicas de hardware para modelos de linguagem em código aberto: Memória, Desempenho e ViabilidadeMarketing Tech · out 2025Modelos de linguagem sob ataque: o lado obscuro da IA generativaDevSecOps · mai 2025Criando um LLM – modelo de linguagem de grande escala – do zero com TransformersAI · abr 2024Ver tudo em AI → generativo de 4 bilhões de parâmetros, derivado da família Qwen3. A mudança foi detalhada em reportagem da InfoQ publicada em 9 de novembro de 2026, com base em material técnico do próprio Pinterest.
O caso interessa a quem constrói sistemas de recomendação porque mostra um padrão que vem se repetindo em empresas de escala: trocar uma cadeia de modelos especializados (embeddings, clustering hierárquico, ranking, heurísticas de diversidade) por um único LLM que recebe histórico bruto e gera texto estruturado como saída. É menos "adicionar IA" e mais "colapsar um pipeline inteiro dentro de um prompt".
O que era uma jornada antes do LLM
O Pinterest define jornada como um objetivo que conecta interesses, intenção e contexto ao longo de várias sessões. O exemplo dado pela empresa é alguém reformando uma cozinha: a pessoa busca modelos de armários, salva ideias de bancada e depois explora azulejos ou iluminação. Separadamente, são interações soltas; juntas, sugerem um projeto coerente.
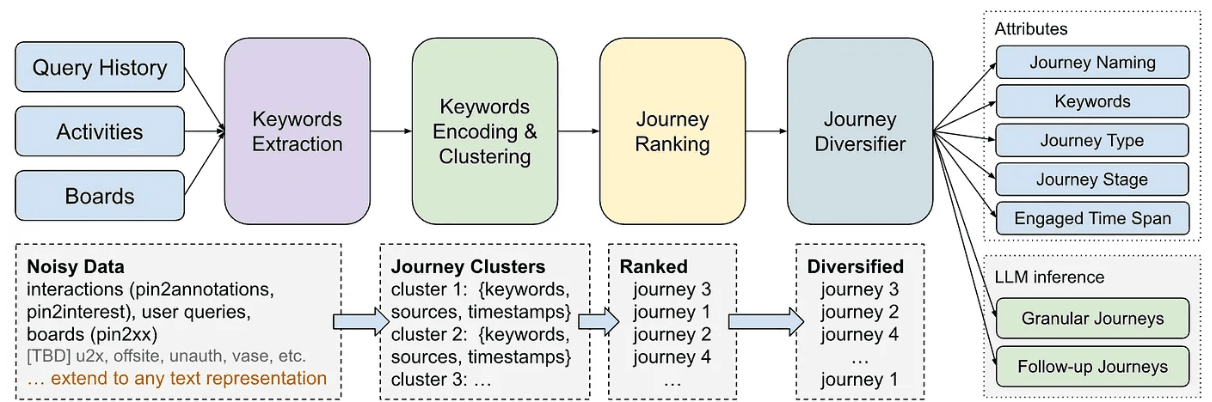
O sistema anterior extraía palavras-chave da atividade do usuário, agrupava essas palavras por similaridade de embeddings e clustering hierárquico, nomeava os clusters resultantes e então aplicava modelos adicionais de ranking e heurísticas de diversidade para decidir o que mostrar. Funcionava melhor do que notificações baseadas só em interesse isolado, mas tinha falhas conhecidas: fragmentava atividades relacionadas em jornadas separadas, gerava rótulos genéricos demais ou confundia engajamento incidental com intenção sustentada.
Tratar a jornada como texto gerado, não como cluster
No novo desenho, inferir uma jornada virou uma tarefa de geração. O modelo fine-tuned lê um histórico cronológico de até 150 ações do usuário numa janela de 360 dias, junto com um perfil compacto, e gera um conjunto ranqueado de nomes de jornada diretamente como saída de texto.
O prompt dá peso maior a buscas e salvamentos do que a cliques incidentais, e instrui o modelo a considerar recorrência, recência e especificidade antes de nomear uma jornada. Boa parte da lógica de negócio que antes vivia em modelos de ranking e filtros separados migrou para dentro das instruções do prompt: evitar fundir interesses não relacionados, suprimir atividade pontual e tags automáticas ruidosas, e devolver um resultado vazio quando não há evidência suficiente de uma jornada real.
Essa migração de lógica para o prompt tem uma consequência prática que vale registrar: o Pinterest passou a tratar mudanças nessas instruções como lançamentos de produção, não como edições triviais de texto. Para quem desenha sistemas parecidos, é um sinal de que prompt em produção pede o mesmo rigor de revisão e rollout que código.
Treinando sem dataset humano em massa
Construir esse fine-tuning sem um grande volume de dados rotulados por humanos foi outro desafio de engenharia. O Pinterest usou modelos de fronteira para gerar exemplos sintéticos de treinamento a partir dos próprios históricos de atividade dos usuários, e então usou esses exemplos para ajustar modelos menores e de peso aberto da família Qwen3, via fine-tuning supervisionado (SFT) combinado com LoRA.
A equipe testou variantes de 0,6 bilhão a 8 bilhões de parâmetros antes de fechar no modelo de 4B, escolhido pelo equilíbrio entre qualidade de inferência e throughput de serving. É um dado útil para quem está decidindo tamanho de modelo para uma tarefa de produção: o maior nem sempre vence quando o custo de servir entra na conta.
Servir um LLM generativo na escala do Pinterest
Rodar esse modelo no volume de usuários do Pinterest exigiu uma pilha de inferência dedicada. A empresa colocou o NVIDIA Dynamo na frente de workers vLLM rodando em GPUs L40S, combinando continuous batching, PagedAttention e roteamento sensível a prefix cache para melhorar a eficiência da inferência.
Um dos ganhos de throughput mais relevantes, porém, não veio de otimizar a inferência em si, e sim de evitar rodá-la. O sistema rastreia quando a jornada de cada usuário foi gerada pela última vez e pula o reprocessamento de quem já foi atendido nos últimos dias. Para times que lidam com custo de servir modelo em escala, é um lembrete direto: a chamada mais barata ao LLM é a que não acontece.
Os números do teste A/B
A avaliação da qualidade das jornadas combinou comparações lado a lado, um LLM separado atuando como juiz de relevância e aderência à atividade do usuário, e experimentos online. O teste A/B inicial, rodado nos Estados Unidos e no Canadá, comparou o novo sistema generativo com o pipeline de clustering e reportou:
- 1,1% de melhora no click-through de e-mail;
- 1,3% de aumento na taxa de abertura de push;
- ganhos estatisticamente significativos em engajamento e retenção, segundo o Pinterest.
São números modestos em termos percentuais, mas tratam-se de métricas agregadas de uma base de usuários do tamanho do Pinterest, onde frações de ponto percentual já representam volume relevante de interações.
Um padrão que não é só do Pinterest
A InfoQ traça um paralelo com o trabalho da Netflix em modelos de fundação para personalização, que aprende representações a partir de longas sequências de interação de assinantes para reutilizar em modelos de recomendação a jusante. A diferença central é que a Netflix foca em representações reutilizáveis internamente, enquanto o Pinterest gera descrições explícitas de jornada em linguagem natural, mas as duas abordagens usam histórico comportamental de longo prazo para enriquecer uma infraestrutura de personalização já existente, sem substituí-la por completo.
Fica em aberto, pela reportagem, qual foi o custo de inferência comparado ao pipeline anterior em termos absolutos, e como o sistema se comporta fora do teste inicial em EUA e Canadá, em mercados com padrões de uso diferentes. Para quem avalia uma migração parecida, essas são exatamente as perguntas a fazer antes de trocar um pipeline de clustering testado por um LLM generativo em produção.
Fonte: InfoQ
Highlights
- Pinterest trocou clustering por LLM Qwen3 de 4 bilhões de parâmetros para inferir jornadas de usuários
- Teste A/B mostrou 1,1% de melhora em email click-through e 1,3% em taxa de abertura de push
- Modelo de 4B escolhido após testar variantes de 0,6B a 8B: equilíbrio entre qualidade e throughput
- Sistema evita reprocessar usuários atendidos nos últimos dias: chamada mais barata ao LLM é a que não acontece
- Lógica de negócio migrou do ranking e filtros separados para dentro das instruções do prompt
Este artigo foi escrito por Redação iMasters. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Memória de agentes de IA busca um padrão comum inspirado no OpenTelemetry
Um post no blog da LoreKit argumenta que a memória de agentes de IA vive hoje o mesmo caos de formatos que a observabilidade tinha antes do OpenTelemetry, e propõe os primeiros passos para um padrão comum.