Google libera o EnvHarness, framework que adapta ambientes de treino às fraquezas de cada agente de IA
A empresa abriu o código do EnvHarness, camada que reconfigura o ambiente de treino conforme as falhas de cada agente, sem tocar no código dele. Em testes, a técnica elevou o desempenho em benchmarks como WebArena e SWE-bench Verified.

A Google abriu o código do EnvHarness, um framework que adapta dinamicamente o ambiente de treino de agentes de IA↳Agentes de IA42 conteúdosOpera passa a integrar ChatGPT, Claude e outros agentes de IADev (Back & Front) · mar 2026Operações mais inteligentes, decisões mais rápidas: o impacto da IA agêntica na rotina de TIAI · abr 2026Adobe aposta em orquestração de agentes de IA: o que muda para devsDev (Back & Front) · abr 2026Ver tudo em AI → às fraquezas identificadas em cada um, sem alterar o agente, o ambiente original ou o sistema de avaliação. O trabalho foi descrito em artigo técnico da empresa e noticiado pela InfoQ em 16 de outubro de 2026. Segundo os pesquisadores, a abordagem melhora tanto a eficácia quanto a eficiência do aprendizado, ajudando agentes a superar pontos cegos que benchmarks estáticos não conseguem mais expor.
O problema do ambiente que para de ensinar
Agentes autoevolutivos costumam melhorar reescrevendo os próprios prompts e adquirindo novas habilidades, mas raramente adaptam o ambiente em que operam. Isso tem uma consequência direta: depois que o agente aprende a resolver as tarefas de um benchmark fixo, não há mais nada novo para aprender ali.
Um agente que continua melhorando contra um benchmark congelado eventualmente para de aprender com ele. Os estados iniciais, as regras e o feedback são os mesmos para todo aprendiz em todo estágio, então, quando o agente consegue resolver as tarefas, o ambiente não tem mais nada a ensinar.
An agent that keeps improving against a frozen benchmark eventually stops learning from it. The start states, the rules and the feedback are the same for every learner at every stage, so once the agent can solve the tasks, the environment has nothing further to teach.Pesquisadores do Google, no artigo do EnvHarness
Criar ambientes novos para cada estágio de treino é caro: exige pipelines específicos de domínio e, muitas vezes, depende de verificadores caros ou pouco confiáveis. Mesmo com esse esforço, o ambiente resultante continua estático. Foi para resolver essa equação que a equipe criou o EnvHarness.
Três peças que não tocam no agente
O EnvHarness funciona como uma camada programável de componentes plugáveis que envolve um ambiente estático, mudando apenas a interface pela qual o agente interage com ele. A estrutura interna e o sistema de avaliação do ambiente original ficam intocados.
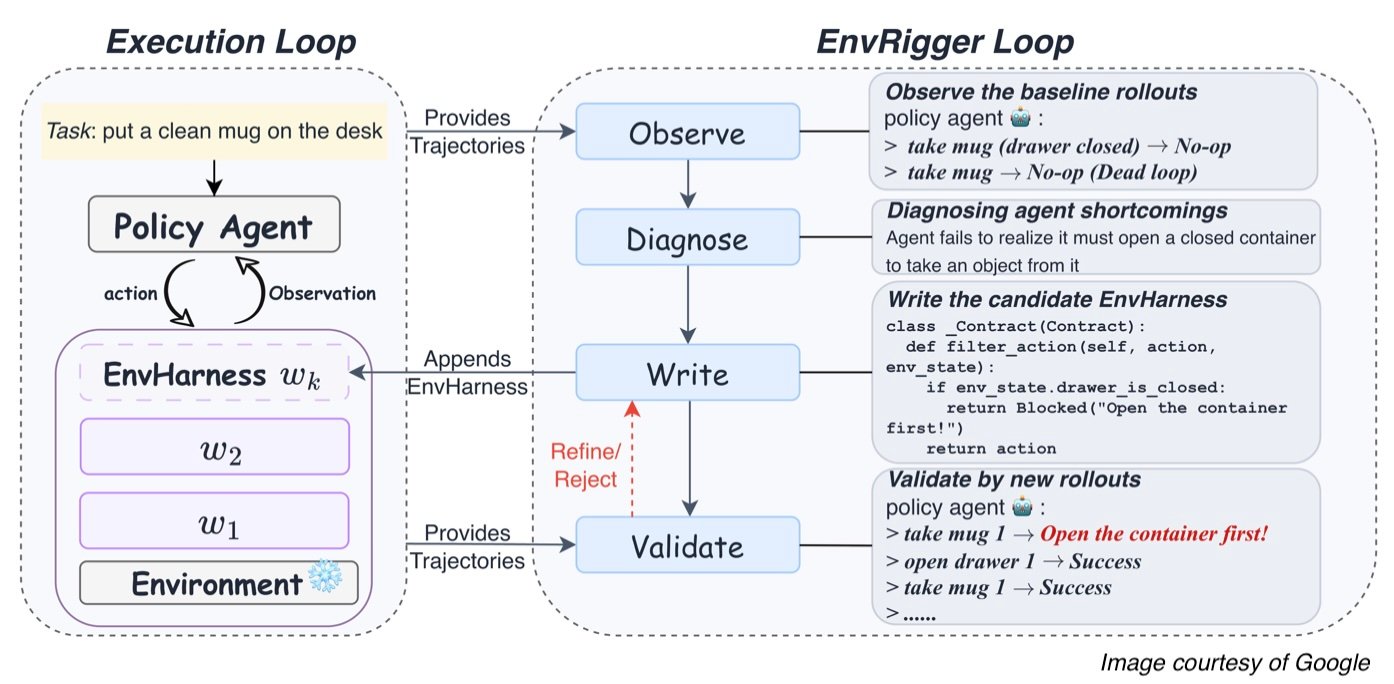
O framework encapsula o ambiente usando sua interface padrão de reset() e step() e oferece três tipos de componentes combináveis:
- setup: personaliza o estado inicial do ambiente;
- rule: restringe as transições de estado em resposta às ações do agente;
- link: personaliza a observação apresentada ao agente.
Combinando esses três blocos, quem treina um agente consegue introduzir mutações no comportamento do ambiente sem reescrever a lógica de avaliação que já existia (e que, em muitos casos, levou meses para ser validada).
EnvRigger fecha o ciclo
Além da camada de wrappers, o EnvHarness traz o EnvRigger, componente que determina automaticamente como adaptar um ambiente a um agente específico. Ele faz isso analisando o comportamento do agente, identificando fraquezas recorrentes, gerando modificações direcionadas e validando essas mudanças com novas interações.
Rodar o laço do EnvRigger repetidamente permite uma coevolução contínua entre agente e ambiente, segundo os pesquisadores, com ganhos de desempenho que se acumulam conforme cresce o número de tarefas customizadas. Na prática, isso significa que o ambiente deixa de ser uma fotografia fixa de dificuldade e passa a reagir ao histórico de erros do agente.
Ganhos nos benchmarks
Segundo o artigo da Google, adicionar a camada EnvHarness melhorou o desempenho de agentes em benchmarks como WebArena, SWE-bench Verified e ALFWorld, sem modificar a lógica central de nenhum deles. Os pesquisadores testaram quatro modelos:
- Gemini 3.1 Flash-Lite
- Qwen3.6 27B
- Gemini 3.5 Flash
- Claude Sonnet 4.6
Todos apresentaram ganhos de desempenho entre 2,9 e 3,7 pontos percentuais com a adição do EnvHarness, segundo a InfoQ. Os pesquisadores concluem que o framework entrega ganhos consistentes onde ambientes estáticos não conseguem, generaliza entre domínios por ter uma interface agnóstica de domínio, e melhora a eficiência ao corrigir comportamentos que desperdiçam tentativas do agente.
O que achou quem já olhou o anúncio
Comentando o lançamento em post no LinkedIn, Asif Razzaq, fundador e CEO da Marketechpost, destacou que a técnica preserva o trabalho humano já feito na construção dos benchmarks:
Ele embrulha um ambiente existente através da interface padrão
wraps an existing environment through the standard reset/step interface, so the original tasks and human-built verifiers stay in place. An LLM designer writes the wrappers against flaws it finds in the agent's own rollouts.Asif Razzaq, fundador e CEO da Marketechpost, em post no LinkedInreset()/step(), então as tarefas originais e os verificadores construídos por humanos permanecem no lugar. Um projetista de LLM escreve os wrappers contra as falhas que encontra nas próprias execuções do agente.
O engenheiro de DevOps↳DevOps29 conteúdosHabilite o Código de Segurança Azure DevOpsDevSecOps · jun 2025O que é DevOps – minha experiência como executivo nessa frenteDev (Back & Front) · abr 2026DevOps: a automação de processos de TI como estratégia de eficiência operacionalDev (Back & Front) · set 2024Ver tudo em DevSecOps → Aniket Kumar, citado na mesma reportagem, destacou que os três componentes (chamados por ele de Stage, Contract e Chain) oferecem uma abstração limpa que preserva os verificadores de benchmark, evitando uma armadilha comum de outras abordagens de escalonamento de ambientes de treino.
O que muda para quem constrói agentes no Brasil
Para equipes brasileiras que treinam ou ajustam agentes com reinforcement learning, a promessa prática do EnvHarness é reduzir o custo de manter ambientes de treino relevantes. Hoje, times que já usam ambientes no padrão reset()/step() (o mesmo modelo popularizado por bibliotecas de estilo Gym) costumam precisar reescrever pipelines inteiros de geração de cenário sempre que o agente estaciona em um platô de desempenho.
Com o EnvHarness, a lógica de adaptação fica num wrapper plugável, o que em tese permite reaproveitar o mesmo ambiente de avaliação (e seus verificadores já validados) em vários ciclos de treino, só trocando os componentes de setup, rule e link conforme o agente evolui. Isso pode interessar especialmente a quem constrói agentes para tarefas de navegação web, automação de testes ou engenharia de software assistida, os mesmos domínios cobertos por WebArena, SWE-bench Verified e ALFWorld.
Fica em aberto, pelo material disponível até agora, o endereço exato do repositório e os termos de licenciamento do código aberto↳Open source71 conteúdosComo o Open Source Está Liberando o Poder da Automação para TodosDev (Back & Front) · out 2025Código aberto: programadores criam software da NASA sem saberDev (Back & Front) · abr 2021N8N: O que é a ferramenta open source que está revolucionando a automação em TI?Dev (Back & Front) · dez 2025Ver tudo em Dev (Back & Front) →, além de dados de custo computacional do laço do EnvRigger rodando em escala. Também não há, na reportagem, comparação direta com frameworks concorrentes de geração de currículo adaptativo para agentes, o que deixa para quem for testar a tarefa de validar se os ganhos de 2,9 a 3,7 pontos percentuais se sustentam fora dos benchmarks usados no paper.
Fonte: InfoQ
Este artigo foi escrito por Redação iMasters. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Meta lança o Muse Spark, modelo open-weight de 816 bilhões de parâmetros para código e agentes
A gigante de tecnologia liberou os pesos do Muse Spark, um modelo com 816 bilhões de parâmetros voltado a programação e tarefas agênticas, que já pode ser baixado, adaptado e rodado localmente.