Como rodar Spring Batch distribuído sem message broker, só com banco de dados
Um artigo publicado na InfoQ descreve um padrão para distribuir jobs do Spring Batch entre vários nós usando apenas o banco relacional que o framework já exige, trocando a fila de mensagens por heartbeats e updates condicionais no SQL. A ideia não substitui o remote partitioning clássico, mas evita subir um Kafka ou RabbitMQ só para isso.

O problema que o artigo ataca
Spring Batch é o framework padrão para processamento em lote na JVM há mais de uma década: jobs montados em steps, com um repositório de metadados que torna as execuções reiniciáveis. Funciona bem em uma única máquina, até o dia em que o volume de dados estoura a janela de processamento.
A resposta consolidada do próprio framework para esse cenário é o remote partitioning: um step gerenciador divide o trabalho em partições e as distribui para workers via um message broker, seja Apache Kafka, RabbitMQ ou um provedor JMS, usando o Spring Integration. Funciona, mas exige subir, proteger e monitorar uma camada de mensageria inteira só para esse fim.
Um artigo publicado em 21 de outubro de 2026 na InfoQ, assinado por Janardhan Reddy Chejarla e revisado por Michael Redlich, propõe uma alternativa para o caso comum: equipes que já mantêm um banco relacional bem operado (Spring Batch exige um para seu job repository, de qualquer forma) e não têm apetite para manter um cluster de mensageria apenas para fazer fan-out de partições de batch. O texto completo está na InfoQ.
As quatro perguntas que qualquer coordenação precisa responder
Reduzido ao essencial, batch distribuído sempre tem que resolver quatro questões, com ou sem broker:
- Como o trabalho é dividido e para quantos workers, já que dividir demais gera overhead e dividir de menos deixa nós ociosos.
- Quem é o responsável por uma execução específica, dividindo o trabalho, acompanhando até o fim e finalizando o job.
- Como um worker toma posse de uma partição sem que um segundo worker rode a mesma partição ao mesmo tempo.
- O que acontece quando um nó morre no meio da execução, e como recuperar o trabalho em andamento sem violar a regra anterior.
Um broker resolve boa parte disso de graça: sua fila entrega cada mensagem a um único consumidor e desacopla produção de execução. Tirar o broker significa responder cada uma dessas perguntas explicitamente em SQL↳SQL64 conteúdosSQL Server – Como evitar SQL Injection?Data · mai 2019Azure SQL DB Managed InstanceData · abr 2019SQL Server – Como evitar SQL Injection? Pare de utilizar Query Dinâmica como EXEC(@Query)Data · abr 2019Ver tudo em Data →, contra um banco pensado para estado compartilhado durável, não para despacho de mensagens.
Três tabelas fazem o papel do broker
O desenho usa o banco que o Spring Batch já exige como único plano de coordenação, sem broker e sem serviço de coordenação como o Apache ZooKeeper. Todo o estado do cluster vive em tabelas SQL comuns, inspecionáveis com um SELECT.
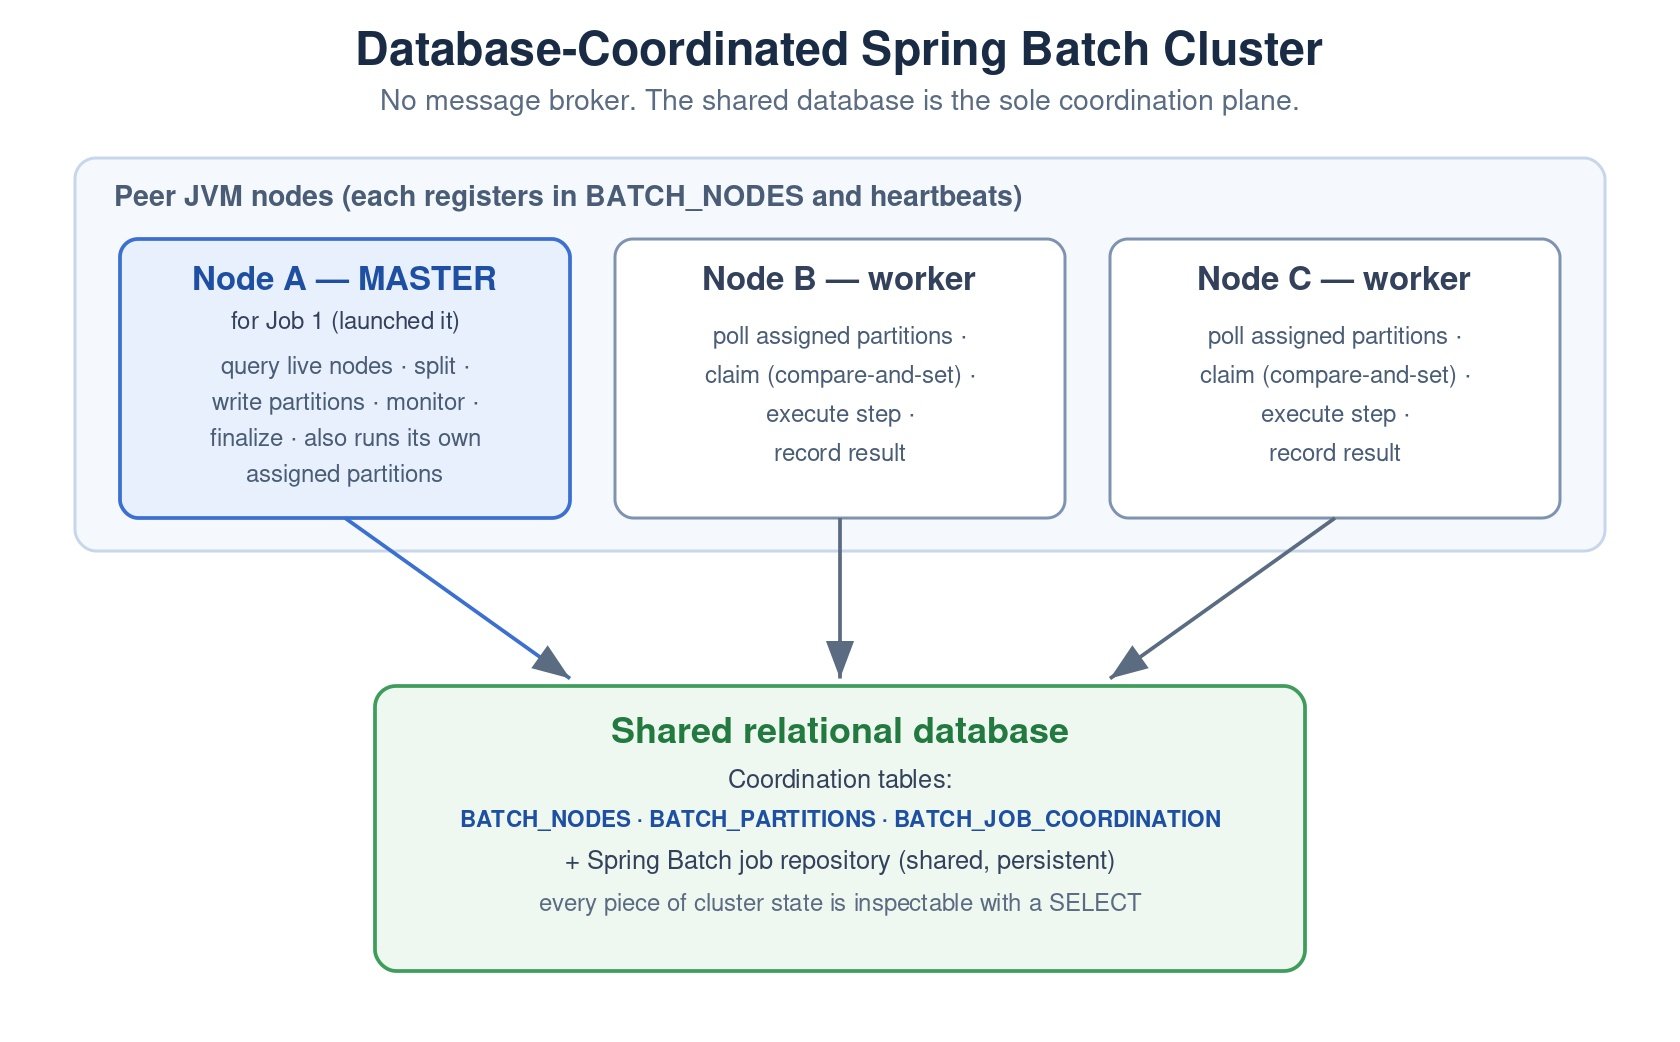
Três tabelas complementam o schema do Spring Batch. A BATCH_NODES é o registro de nós, com status (active ou unreachable), timestamp do último heartbeat e carga atual. A BATCH_PARTITIONS acompanha o ciclo de vida de cada partição, indexada pelo step_execution_id daquela partição (cada partição é, ela mesma, um StepExecution do Spring Batch), com nó atribuído, status (PENDING, CLAIMED, COMPLETED ou FAILED) e se pode ser transferida para outro nó em caso de falha. A BATCH_JOB_COORDINATION amarra cada execução de job ao seu nó master e ao manager step.
O payload de cada partição continua sendo um ExecutionContext do Spring Batch, escrito pelo master e lido de volta por quem executa. Isso significa que o repositório compartilhado e durável continua sendo exigência do remote partitioning, com ou sem broker: a diferença é que, no desenho tradicional, o broker carrega só um ponteiro para a partição, nunca o dado em si. O que esse padrão remove é o broker, não o repositório.
Não existe um master eleito para o cluster inteiro. O nó que lança um job vira master daquela execução específica, e só dela. Dois jobs lançados em dois nós diferentes têm dois masters distintos rodando ao mesmo tempo, o que evita reintroduzir a máquina de eleição de líder e o ponto único de falha que tirar o broker deveria eliminar.
O que muda no código: quase nada
Para quem já escreve partitioned steps no Spring Batch, a pergunta prática é onde o código muda. A resposta, segundo o artigo, é quase nenhuma linha, porque o encaixe usa um extension point que o framework sempre teve: o Partitioner decide como dividir o trabalho e o PartitionHandler decide como executar cada partição.
O TaskExecutorPartitionHandler embutido roda tudo em threads locais; o remote partitioning tradicional troca por um MessageChannelPartitionHandler que envia via broker. O manager step continua montado da mesma forma:
new StepBuilder("reconcileStep.manager", jobRepository)
 .partitioner("reconcileStep", clusterAwarePartitioner) // como o trabalho é dividido
 .partitionHandler(clusterAwarePartitionHandler) // como as partições são distribuídas
 .step(reconcileStep) // o worker step comum
 .aggregator(aggregator)
 .build();
A linha .partitionHandler(...) é todo o ponto de extensão: o padrão fornece seu próprio PartitionHandler, que escreve linhas de partição no banco e as monitora no lugar onde o handler baseado em broker atuaria. O worker step continua sendo um step chunk-oriented ou tasklet comum, os resultados são agregados pelo StepExecutionAggregator padrão, e o restart funciona pelo JobRepository de sempre. Transformar um deployable em membro do cluster é configuração, não código: uma flag liga o comportamento, com auto-configuração registrando o nó, iniciando o heartbeat e o polling, sem cliente de broker nem beans extras.
Como o master conduz a execução
O master step é um partitioned step comum do Spring Batch, rodando no nó que lançou o job. O que o torna master é onde o PartitionHandler executa: quando o Spring Batch chama o método handle(...) do handler, ele bloqueia naquele nó até a execução distribuída inteira terminar.
Dentro dessa chamada, o master faz quatro coisas em ordem: registra a execução na tabela de coordenação como STARTED, grava uma linha PENDING por partição, roda um loop de monitoramento que reatribui partições órfãs de nós removidos e verifica se ainda há algo pendente, e finalmente marca o job como COMPLETED ou falha o step se alguma partição terminou como FAILED. Workers nunca chamam o master e o master nunca chama os workers: toda decisão passa por leitura e escrita nessas tabelas, o que explica por que perder um master afeta só aquele job, nunca o cluster inteiro.
Dimensionando o trabalho para o cluster vivo
O remote partitioning tradicional divide o trabalho antes de saber quanta capacidade existe para executá-lo, geralmente com um grid size fixo. Sem broker, o master consulta o banco para saber quantos nós estão vivos nesse instante e passa essa contagem para o Partitioner, que então decide quantas partições criar (um ou dois por nó vivo, por exemplo) e quais parâmetros vão em cada ExecutionContext.
Uma estratégia de atribuição então mapeia partições para nós: round-robin para distribuição uniforme, fixed-node-count para confinar um job a n nós, ou least-loaded, que direciona cada partição para o nó com menor carga reportada. A atribuição é fixa a partir desse ponto, ou seja, é posicionamento e não rebalanceamento em tempo real: um nó que termina cedo não puxa partições de um colega mais lento, e só a falha de um nó move trabalho. Essa é justamente a vantagem de rebalanceamento que a semântica pull de um broker dá de graça e que esse desenho sacrifica.
Como evitar execução duplicada
O ponto crítico de correção é a transição de PENDING para CLAIMED, feita com um único UPDATE condicional que também serve para as transições seguintes:
-- claim, depois complete ou fail: um único UPDATE guardado
UPDATE batch_partitions
SET status = ?, -- CLAIMED, depois COMPLETED ou FAILED
 last_updated = CURRENT_TIMESTAMP
WHERE step_execution_id = ?
 AND assigned_node = ?
 AND status IN ('PENDING', 'CLAIMED');
A cláusula WHERE só aceita uma linha que ainda esteja PENDING ou CLAIMED: uma vez que a partição chega a um estado terminal (COMPLETED ou FAILED) ou é reatribuída, nenhuma escrita tardia consegue movê-la. Isso não é uma fila concorrida com SELECT ... FOR UPDATE SKIP LOCKED: como as partições já vêm pré-atribuídas, o update guardado governa o ciclo de vida, não o despacho. A garantia de um-nó-por-partição que um broker dá pela fila aqui vem da transição de estado linha a linha.
Recuperação de falha de nó
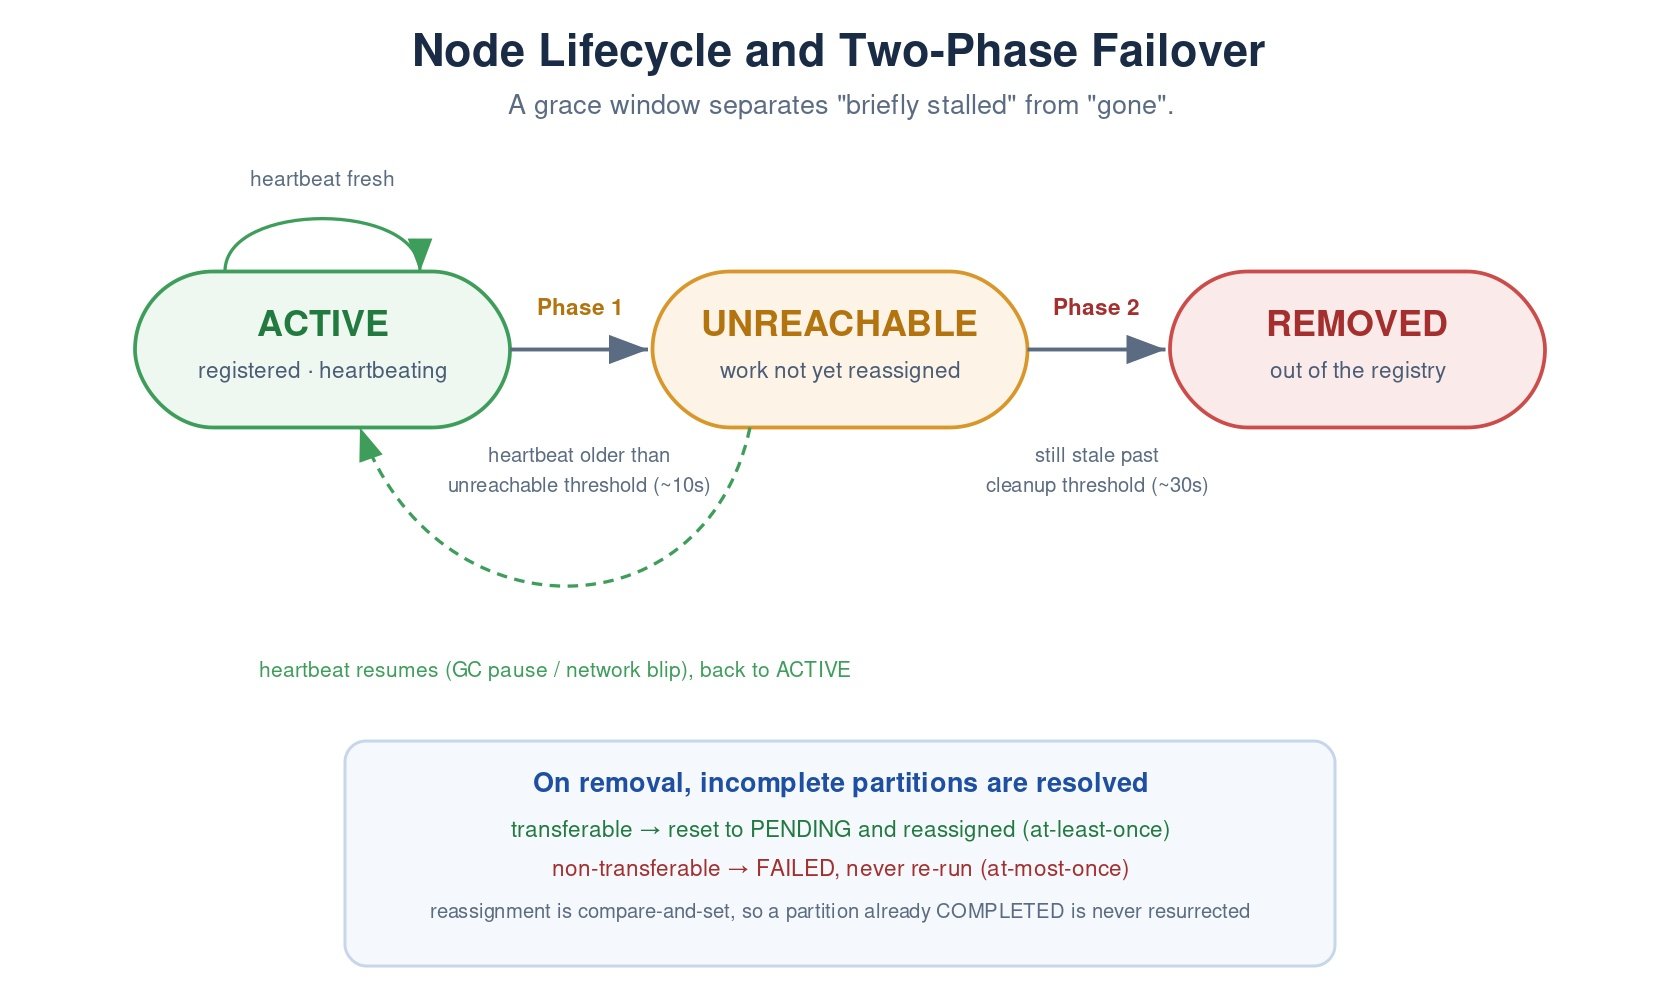
Cada nó atualiza um timestamp de heartbeat num intervalo configurável, comparado contra o relógio do próprio banco, o que evita problemas de skew entre relógios de máquinas diferentes. A detecção e a remoção são descentralizadas: todo nó roda a varredura de limpeza, então a morte de um único monitor não deixa o cluster cego.
A recuperação é um processo em duas fases, com defaults de produção de cerca de dez segundos para marcar um nó como unreachable e trinta segundos para removê-lo de fato e reatribuir suas partições incompletas e transferíveis. O contrato de correção é explícito: trabalho transferível roda pelo menos uma vez e precisa ser idempotente; trabalho não transferível roda no máximo uma vez e é marcado como falho em vez de movido. Uma partição nunca é silenciosamente perdida.
Onde esse padrão faz sentido, e onde não faz
O próprio artigo delimita o teto da abordagem: ela serve para clusters pequenos a médios, onde simplicidade operacional e custo pesam mais do que latência extrema. Passado um certo ponto, com contenção de banco demais, clusters muito grandes ou necessidade de latência sub-segundo, um broker continua sendo a ferramenta certa.
Para quem mantém pipelines de reconciliação financeira noturna, ETL de porte médio ou validação de dados em nós provisionados dinamicamente na nuvem, e já opera um banco relacional bem cuidado, o padrão elimina uma camada operacional inteira sem abrir mão de failover automático. Vale a leitura do artigo original na InfoQ para quem for implementar: o texto completo detalha ainda as métricas de observabilidade↳Observabilidade11 conteúdosObservabilidade para APIs: os desafios e benefícios dessa abordagemDev (Back & Front) · jan 2025Falhas em Observabilidade afetam os Apps e a Segurança das OrganizaçõesDev (Back & Front) · nov 2023ADK Java 1.0: O Google quer que você pare de gambiarra Python no seu backendMarketing Tech · abr 2026Ver tudo em DevSecOps → expostas e os cenários de teste usados para validar o comportamento de failover.
Fonte: InfoQ
Este artigo foi escrito por Redação iMasters. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Google abre o código do TorchTPU, backend nativo do PyTorch para TPUs
O repositório google-pytorch/torch_tpu implementa kernels ATen para rodar PyTorch direto em TPUs, mas o compilador XLA continua por baixo do capô.