OpenAI Agents SDK: como montar handoffs e guardrails entre agentes antes de ir para produção
O OpenAI Agents SDK oferece três peças (agentes, handoffs e guardrails) para orquestrar times de LLMs em Python. O tutorial mostra como montá-las e onde a arquitetura tende a quebrar antes da produção.

O OpenAI Agents SDK é a biblioteca Python↳Python56 conteúdosVSCode + Python + Alexa: Desenvolva e teste skills para alexa localmente com pythonDev (Back & Front) · out 2025Dominando decoradores em Python: um guia completo com exemplosDev (Back & Front) · jan 2025Desenvolvimento de software: diferenças entre Python, JavaScript e JavaGestão Dev & TI · nov 2024Ver tudo em Dev (Back & Front) → que a OpenAI mantém como sucessora do Swarm, o experimento que a empresa usava internamente para testar padrões de orquestração multiagente. A diferença declarada na documentação oficial do projeto é posicionamento: o Swarm era exploratório, o Agents SDK é descrito como "production-ready". Na prática isso significa um conjunto pequeno de primitivas (agentes, handoffs, guardrails) em vez de uma pilha de abstrações para aprender antes de escrever a primeira linha.
O pacote se instala com pip install openai-agents e por padrão usa a Responses API da OpenAI por baixo dos panos, mas embrulhada num runtime que resolve turnos, chamadas de tool e checagens de segurança sem que o desenvolvedor precise escrever esse loop na mão. É esse runtime, não o modelo em si, que a documentação chama de "agent loop": ele continua a execução até a tarefa ser considerada concluída, trocando mensagens, chamando tools e, se configurado, delegando para outro agente no meio do caminho.
O agente mínimo e o que o Runner faz por baixo
O exemplo "hello world" da documentação cabe em quatro linhas e já expõe a ideia central: um Agent é só um LLM↳LLMs48 conteúdosConsiderações básicas de hardware para modelos de linguagem em código aberto: Memória, Desempenho e ViabilidadeMarketing Tech · out 2025Modelos de linguagem sob ataque: o lado obscuro da IA generativaDevSecOps · mai 2025Criando um LLM – modelo de linguagem de grande escala – do zero com TransformersAI · abr 2024Ver tudo em AI → com instruções e, opcionalmente, tools; quem executa é o Runner.
from agents import Agent, Runner

agent = Agent(name="Assistant", instructions="You are a helpful assistant")
result = Runner.run_sync(agent, "Write a haiku about recursion in programming.")
print(result.final_output)
Com OPENAI_API_KEY definida no ambiente, esse código já roda local, sem servidor, sem fila de mensagens. O ponto é que Runner.run_sync esconde o loop de tool-calling: se o agente tivesse uma function tool anexada, o SDK decidiria sozinho quando chamá-la, leria o retorno e decidiria se a tarefa já terminou ou se precisa de mais um turno. Isso é conveniente até o momento em que algo dá errado dentro desse loop e o desenvolvedor não tem visibilidade do que aconteceu, o que empurra a tracing embutida do SDK de "recurso bacana" para pré-requisito de debug.
Handoffs: quando um agente passa a bola para outro
A peça que dá nome ao "time de agentes" da pauta é o handoff. A documentação descreve handoffs como agentes tratados como tools de outros agentes, um mecanismo para "coordenar e delegar trabalho entre múltiplos agentes". Na prática, isso resolve um problema real: um único prompt de sistema gigante tentando cobrir triagem, suporte técnico e faturamento tende a confundir o modelo sobre qual conjunto de instruções vale em cada mensagem.
O padrão recomendado separa isso em agentes especializados com um agente de triagem na frente:
from agents import Agent, Runner

billing_agent = Agent(
    name="Billing agent",
    instructions="Resolve billing questions. Be precise about amounts and dates.",
)

tech_agent = Agent(
    name="Tech support agent",
    instructions="Diagnose technical issues. Ask for logs when relevant.",
)

triage_agent = Agent(
    name="Triage agent",
    instructions="Decide if the user needs billing or technical help, and hand off accordingly.",
    handoffs=[billing_agent, tech_agent],
)

result = Runner.run_sync(triage_agent, "Minha fatura veio duplicada este mês")
print(result.final_output)
O agente de triagem não resolve a fatura duplicada: ele decide, com base nas instruções, que o billing_agent deve assumir a conversa, e o SDK transfere o contexto da execução para esse segundo agente. Essa é a diferença prática entre handoff e simplesmente chamar outro agente como tool: no handoff, o controle do turno muda de dono; numa chamada de tool comum, o agente original continua no comando e só usa a resposta do outro como insumo.
Em resumo: handoff serve para delegação completa de responsabilidade; agente-como-tool serve para consulta pontual sem trocar quem está no volante. Escolher o modelo errado é uma das formas mais comuns de a orquestração travar: um pipeline que devia delegar e só consulta acaba com um agente genérico tentando fazer tudo mal feito, e um pipeline que devia consultar e faz handoff perde o fio da conversa original.
Guardrails: a trava que roda em paralelo, não depois
A documentação é específica sobre como os guardrails devem se comportar: "run input validation and safety checks in parallel with agent execution, and fail fast when checks do not pass". Isso é uma escolha de arquitetura, não um detalhe de implementação. Guardrail não é um filtro que roda depois da resposta pronta, checando o texto final; ele roda junto do agente principal, e se falhar, interrompe a execução antes de gastar mais chamadas de modelo.
Um guardrail de entrada típico barra, por exemplo, pedidos que claramente não pertencem ao domínio do agente (alguém tentando usar o bot de faturamento para pedir conselho jurídico), e um guardrail de saída valida se a resposta do modelo respeita um formato ou política antes de chegar ao usuário. O ganho de rodar em paralelo é latência: o guardrail não espera o agente terminar para começar a checar, e o SDK aborta assim que a primeira falha aparece, antes de o usuário receber uma resposta que nunca deveria ter sido gerada.
Sessions: memória entre turnos, e por que a opção padrão não serve para produção
A terceira peça da pauta é a persistência de contexto. A documentação define Sessions como "a persistent memory layer for maintaining working context within an agent loop", e aqui está o ponto que separa um protótipo local de algo que sobrevive a um restart de serviço: existe mais de uma implementação de sessão, e a diferença entre elas é exatamente onde a orquestração quebra antes de ir para produção.
O SDK documenta, entre outras, SQLAlchemySession, Async SQLite session, RedisSession, MongoDBSession, DaprSession, EncryptedSession e AdvancedSQLiteSession. A existência dessa lista inteira é o sinal: uma sessão em memória de processo (a opção mais simples para rodar localmente) desaparece a cada reinício do serviço, e qualquer orquestração com handoffs de várias etapas que dependa de lembrar o que o triage_agent decidiu dois turnos atrás perde esse histórico no primeiro deploy que reiniciar o container.
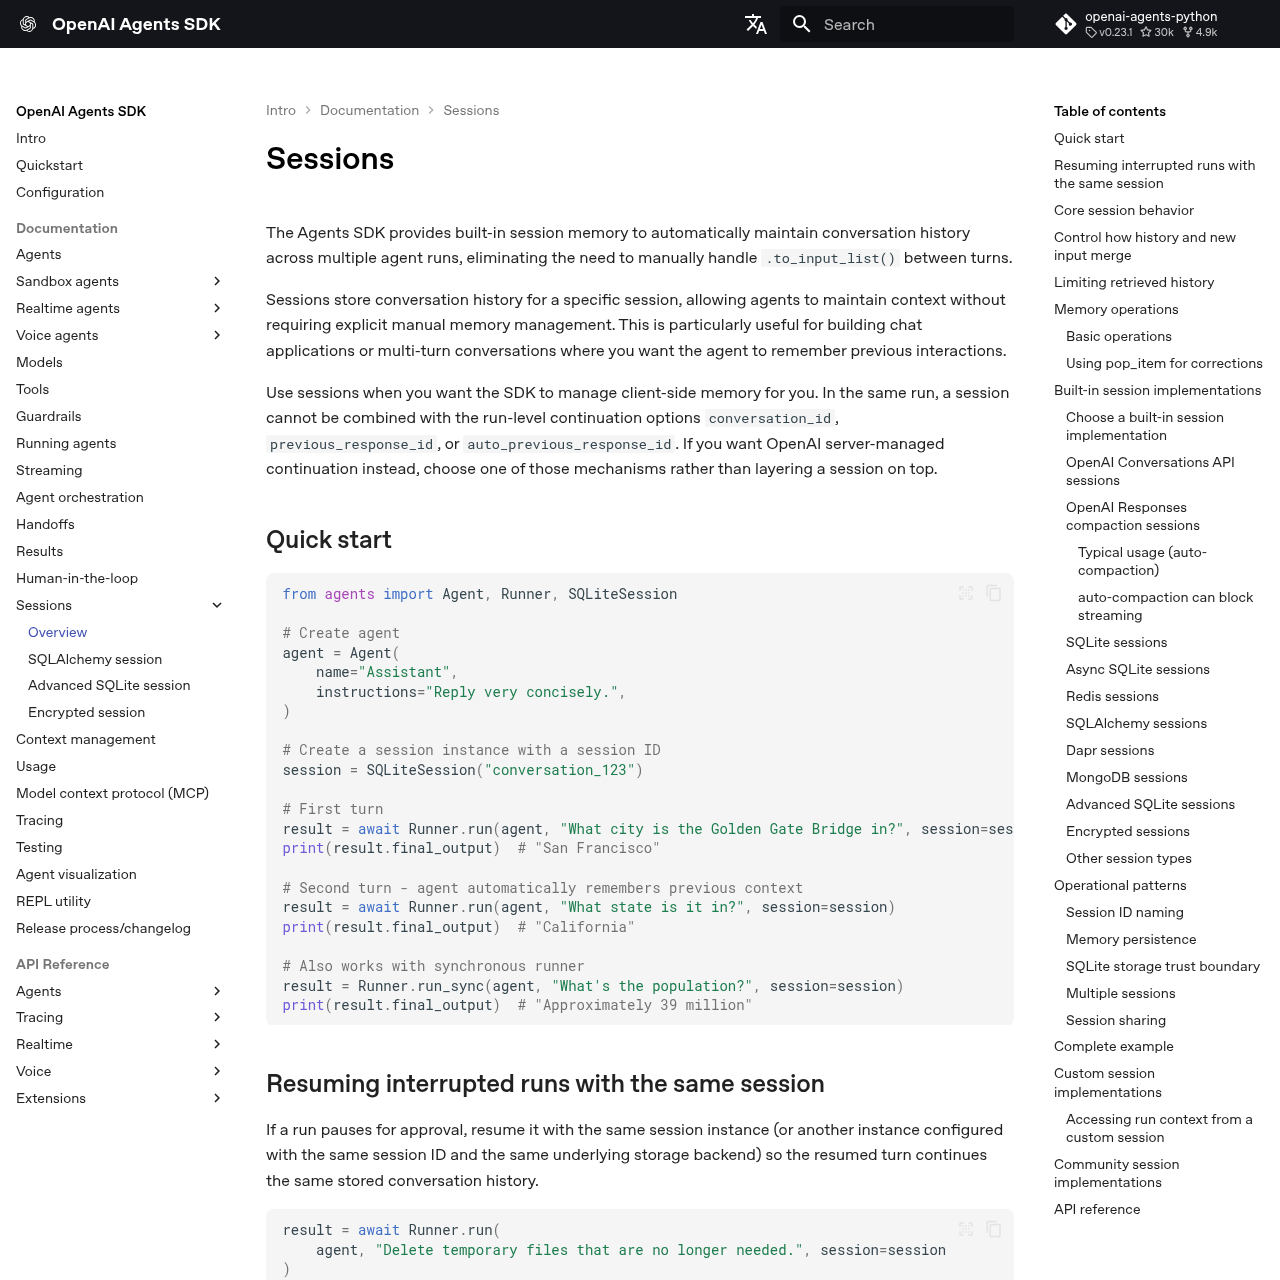
Para quem pretende levar esse tipo de time de agentes para produção, a escolha de backend de sessão não é um detalhe de configuração tardio, é uma decisão que precisa entrar no desenho da arquitetura desde o protótipo, especialmente se o fluxo envolve compliance (onde EncryptedSession entra em jogo) ou múltiplas instâncias do serviço rodando atrás de um load balancer (onde sessão em memória simplesmente não existe como opção).
Onde a coisa trava antes de chegar em produção
Reunindo as três peças, os pontos de atrito mais prováveis num time de agentes real aparecem em lugares específicos:
- Loops de handoff sem critério de parada: se o agente A delega para B e as instruções de B permitem delegar de volta para A, nada no SDK impede um ping-pong indefinido sem um limite de turnos definido explicitamente.
- Guardrail que falha silenciosamente: um guardrail mal configurado que nunca dispara dá falsa sensação de segurança; a tracing embutida do SDK é a única forma confiável de confirmar que ele está sendo avaliado a cada execução.
- Sessão em memória esquecida em produção: funciona perfeito no notebook do desenvolvedor e perde todo o histórico assim que dois workers do serviço atendem o mesmo usuário em requisições diferentes.
- Confundir handoff com tool call: usar handoff para uma simples consulta pontual faz o agente principal perder o controle da conversa sem necessidade.
Agents SDK ou Responses API direto: a pergunta que vem antes do código
A própria documentação recomenda não tratar isso como escolha única: "muitas aplicações usam o SDK para workflows gerenciados e chamam a Responses API diretamente para caminhos de baixo nível". Vale a Responses API pura quando o fluxo é curto, de um turno só, e o time quer controlar explicitamente o dispatch de tools e o estado. Vale o Agents SDK quando o runtime precisa gerenciar turnos, guardrails, handoffs ou sessões sozinho, ou quando o agente precisa operar por múltiplas etapas coordenadas, como o time de triagem, faturamento e suporte técnico descrito acima.
Para quem está decidindo migrar um fluxo artesanal de prompts encadeados para o SDK, o caminho mais seguro é começar pelo agente único do quickstart, adicionar um handoff só quando houver dois domínios claramente distintos de instrução, e só então introduzir uma sessão com backend persistente, nessa ordem e não ao contrário.
Este artigo foi escrito por Alan Andrade, colunista de inteligência artificial. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Claude Haiku 5.5 iguala preço do GPT-6 Luna, mas esconde aumento de custo no tokenizer
A Anthropic lançou em 7 de outubro o Claude Haiku 5.5, cobrando o mesmo preço do GPT-6 Luna da OpenAI até 100 mil tokens. Só que um tokenizer menos generoso e um salto de preço acima desse limite mudam a conta de quem roda agentes em produção.