Mistral Large 4 chega em preview com 1 trilhão de parâmetros, mas pesos abertos só no fim de outubro
O salto de benchmark é real, mas os pesos abertos, que sustentam a promessa de rodar on-premise, só devem sair no fim do mês.

A Mistral lançou nesta terça (6/10) um preview via API do Large 4, modelo de 1 trilhão de parâmetros com apenas 49 bilhões ativos por token. O salto de benchmark é real, mas os pesos abertos, que sustentam a promessa de rodar on-premise, só devem sair no fim do mês.
O anúncio, feito nesta terça (6/10)
A Mistral AI↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI → publicou nesta terça-feira, 6 de outubro de 2026, um preview do Mistral Large 4 acessível pela própria API da empresa. O registro mais detalhado do lançamento saiu no blog de Simon Willison, que acompanha de perto cada novo modelo de linguagem relevante do mercado.
Os números chamam atenção: 1 trilhão de parâmetros no total, mas só 49 bilhões ativos por token. O modelo foi treinado num cluster próprio da Mistral, com 3.800 GPUs NVIDIA Grace Blackwell.
Por baixo do capô: uma Mixture-of-Experts bem esparsa
A proporção entre parâmetros totais e ativos entrega a arquitetura: é um Mixture-of-Experts (MoE), onde só uma fração dos "especialistas" do modelo participa de cada inferência. Com 49 bilhões ativos sobre 1 trilhão total, a taxa de ativação fica perto de 5%, um recorte bem mais esparso que o comum nesse tipo de arquitetura.
Na prática, isso barateia o custo computacional por token processado: a conta de inferência se aproxima da de um modelo de ~49B parâmetros densos, não de um de 1T. O problema é que o custo de memória não cai junto: para servir qualquer token, o sistema de inferência precisa ter acesso rápido a todos os experts possíveis, não só aos que serão ativados.
O salto no benchmark, e o quanto ele significa
Na Artificial Analysis, índice que a comunidade de LLMs usa como referência comparativa, o Large 4 marcou 38 pontos. Isso fica logo atrás do DeepSeek 4.1 Flash, modelo de 552 bilhões de parâmetros, mas bem à frente do antecessor direto.
| Modelo | Parâmetros (total / ativos) | Score na Artificial Analysis |
|---|---|---|
| Mistral Large 3 (dez/2025) | não divulgado | 9 |
| Mistral Large 4 (preview, out/2026) | 1 trilhão / 49 bilhões | 38 |
| DeepSeek 4.1 Flash | 552 bilhões (MoE) | pouco acima de 38 |
O Mistral Large 3, lançado em dezembro de 2025, havia marcado apenas 9 pontos no mesmo índice. Um salto de 9 para 38 é expressivo para qualquer fabricante, mas ainda não coloca o Large 4 na classe de fronteira: Willison estima que o modelo fica cerca de seis meses atrás do estado da arte, o que já é visto como uma recuperação de competitividade para a Mistral depois de uma geração fraca.
O teste informal que expõe uma particularidade dos modos de raciocínio
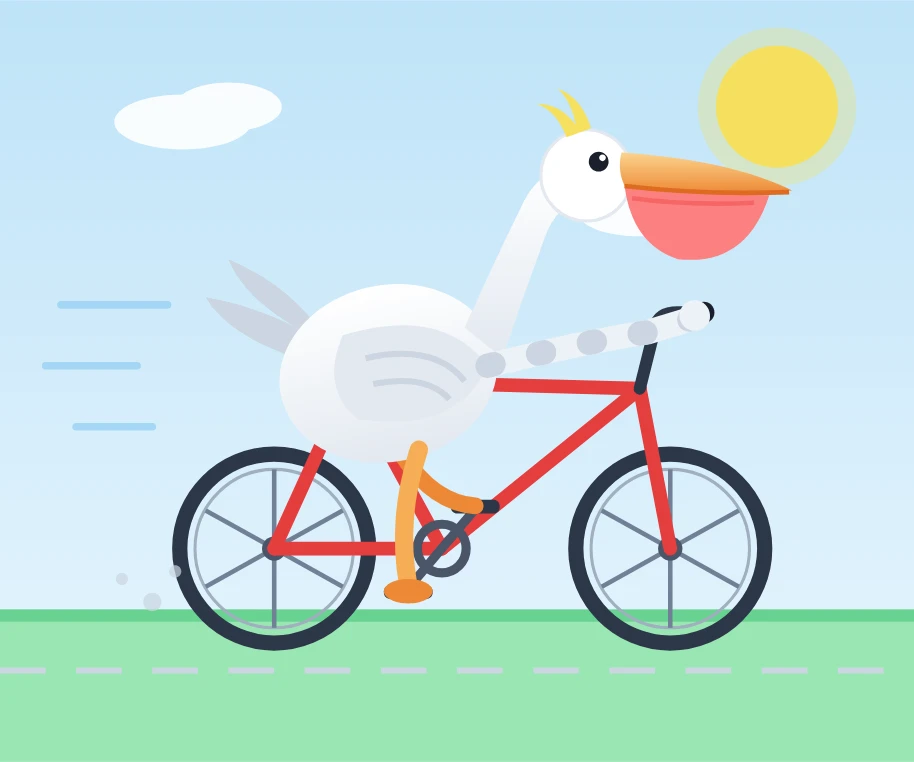
Willison mantém um benchmark pessoal e bem-humorado: pedir para cada modelo novo desenhar, em SVG, um pelicano andando de bicicleta. O resultado não mede qualidade de código em geral, mas captura de forma rápida se o modelo segue instruções espaciais complexas sem supervisão.
O Large 4 só oferece dois níveis de raciocínio pela API, none e high, sem opções intermediárias de orçamento de tokens como outros fabricantes vêm oferecendo. O resultado do teste do pelicano foi contraintuitivo: o modo high gerou um desenho melhor usando 2.717 tokens de saída, enquanto o modo none gastou mais, 3.275 tokens, e produziu um resultado pior. Para quem está decidindo entre níveis de raciocínio num pipeline de produção, isso é um lembrete de que mais tokens gastos não é sinônimo de mais raciocínio aplicado.
A letra miúda que muda o ângulo da notícia
Aqui está o ponto que separa o anúncio de hoje da promessa de "modelo europeu sem vendor lock-in": os pesos abertos do Large 4 ainda não existem. A Mistral prometeu liberá-los apenas no "fim deste mês", ou seja, até o final de outubro de 2026.
Enquanto isso não acontece, usar o Large 4 significa depender da API da Mistral, exatamente o mesmo tipo de dependência de fornecedor que qualquer modelo fechado de OpenAI, Anthropic ou Google impõe. Não há, hoje, nenhuma forma de rodar este modelo on-premise. Quem decidir integrar o preview em produção agora está apostando numa promessa de abertura futura, não usando um modelo já aberto.
O que vai pesar quando os pesos saírem
Quando (e se) os pesos forem publicados, a conta de infraestrutura para rodar o Large 4 localmente não será trivial, mesmo com a esparsidade do MoE jogando a favor. Um modelo de 1 trilhão de parâmetros, mesmo em quantização de 8 bits, ocupa algo na casa de 1 terabyte só em pesos; em 4 bits, ainda ficaria perto de 500 gigabytes.
Isso significa que, mesmo que apenas 49 bilhões de parâmetros sejam ativados por token, o servidor de inferência precisa manter todos os experts carregados em memória de GPU (ou em memória rápida o suficiente para não gerar latência por troca de disco) para atender requisições com previsibilidade. Servir um MoE desse porte exige paralelismo de experts, o que implica cluster multi-GPU, não uma workstation única. Trocar a fatura da API por hardware próprio é real, mas o hardware próprio aqui não é pequeno.
Para quem vale esperar
Para times no Brasil preocupados com soberania de dados ou que já batem de frente com custo de API em escala, o Large 4 é um nome a monitorar, não a adotar hoje. O caminho razoável é acompanhar o lançamento dos pesos no fim de outubro, avaliar os requisitos reais de serving (memória, paralelismo de experts, throughput) e comparar o resultado prático contra alternativas já abertas, como os modelos da própria DeepSeek, que hoje já publicam pesos junto com os benchmarks.
Seis meses atrás da fronteira não é um problema para boa parte dos casos de uso em produção, que não exigem o modelo mais avançado do mundo, só um modelo competente, previsível e, no caso do Large 4, potencialmente livre de lock-in de fornecedor quando a segunda metade da promessa, os pesos abertos, finalmente for cumprida.
Fonte: Simon Willison
Este artigo foi escrito por Alan Andrade, colunista de inteligência artificial. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Claude Code refina subagents e hooks e expõe os limites de automatizar revisão de PR
Três releases do Claude Code publicadas entre 1 e 3 de outubro de 2026 mexem na isolação de subagents e no comportamento de hooks como PreToolUse. Os bugs corrigidos revelam como montar (e onde não confiar cegamente em) um pipeline local de revisão de código.