
- Leitura
- 6 min
- Código
- 1
- Fontes
- 1
A IBM lançou em 12 de novembro de 2026 o LLMON, uma marcação pensada para como um modelo de linguagem lê (e não como um parser lê) e já embutiu o formato em duas versões experimentais do Granite 4.1.
A IBM publicou em 12 de novembro de 2026, no blog da Hugging Face, o LLMON (LLM↳LLMs48 conteúdosConsiderações básicas de hardware para modelos de linguagem em código aberto: Memória, Desempenho e ViabilidadeMarketing Tech · out 2025Modelos de linguagem sob ataque: o lado obscuro da IA generativaDevSecOps · mai 2025Criando um LLM – modelo de linguagem de grande escala – do zero com TransformersAI · abr 2024Ver tudo em AI → Object Notation, que se lê "lemon"): uma linguagem de marcação pensada para ser lida por um modelo de linguagem, não por um parser. Junto com o anúncio vieram dois modelos experimentais, granite-4.1-3b-LLMON-preview e granite-4.1-8b-LLMON-preview, derivados dos checkpoints base do Granite 4.1, mais um repositório no GitHub com conversores e exemplos. Para quem monta pipeline de RAG, agente ou prompt com múltiplas instruções em produção, o ângulo interessante não é o nome bonito: é o que muda na hora de estruturar o que entra no contexto do modelo.
Por que o JSON não basta para um modelo de linguagem
Um contexto longo acumula system prompt, histórico de conversa, instruções que atuam sobre documentos recuperados, resposta de ferramenta, dado de usuário, requisitos de saída e cadeia de raciocínio. Essa estrutura costuma ser codificada em JSON, formato desenhado para parsers determinísticos, não para um modelo causal.
O problema é que tokens como {, " e : também aparecem em texto comum: para o modelo, as aspas que fecham um campo e as aspas que aparecem dentro de um documento são o mesmo token, e regras de escaping que um parser segue por gramática o modelo só segue por padrão estatístico. Contar a profundidade de aninhamento por parênteses também é algo que transformers fazem mal em spans longos.
O JSON foi feito para analisadores de sintaxe, não para modelos de linguagem causais.
Equipe do IBM Granite, no blog oficial da Hugging FaceJSON was designed for parsers, not for causal language models.
Como o LLMON marca a estrutura
O LLMON é parecido com XML, mas os delimitadores de estrutura são tokens especiais reservados no tokenizer, não caracteres comuns, de modo que estrutura e conteúdo ocupam partes distintas do vocabulário. Cada trecho recebe uma tag no início e um ID de dois caracteres, retirado de um conjunto fixo que o tokenizer codifica como token único, então endereçar qualquer bloco custa sempre dois tokens.
Um bloco exec amarra instruções aos dados e requisitos sobre os quais elas devem agir, de um jeito parecido com chamar uma função e passar argumentos em uma linguagem de programação. A IBM mostra o exemplo de uma mensagem de usuário com instrução, dado e dois requisitos:
messages = [{
 "role": "user",
 "instruction": [{"value": "Write a short paragraph about", "exec": True}],
 "data": [{"value": "IBM Company", "exec": True}],
 "requirement": [
 {"value": "Use less than 10 words", "exec": True},
 {"value": "Do not use commas", "exec": True}
 ]
}]
O modelo recebe isso como seis blocos endereçáveis: instrução, dado, dois requisitos, um bloco exec que amarra tudo e um bloco de saída, com cada parte marcada exec: True ou False. Um conjunto flatten numa única string, como um chat template convencional faz, obriga o modelo a inferir sozinho qual pedaço é tarefa, qual é assunto e qual é restrição. O LLMON não substitui o chat template: ele enriquece o que já existe, informando não só qual parte pertence a qual papel (system, user, assistant), mas o que cada componente significa e como se relaciona com os outros.
JSON foi feito para analisadores de sintaxe, não para modelos de linguagem causais.
No original: JSON was designed for parsers, not for causal language models.
Fonte: Hugging Face BlogPrompt injection: os números que sustentam a promessa
A separação explícita entre instrução e dado foi desenhada para atacar diretamente o prompt injection indireto, quando uma instrução maliciosa fica escondida num documento recuperado, numa resposta de ferramenta ou num dado de usuário. A IBM testou os previews LLMON contra modelos abertos e fechados no benchmark OPI, que injeta a instrução maliciosa em tarefas clássicas de NLP, medindo robustez como 1 menos a taxa de sucesso do ataque. Os resultados reportados pela equipe:
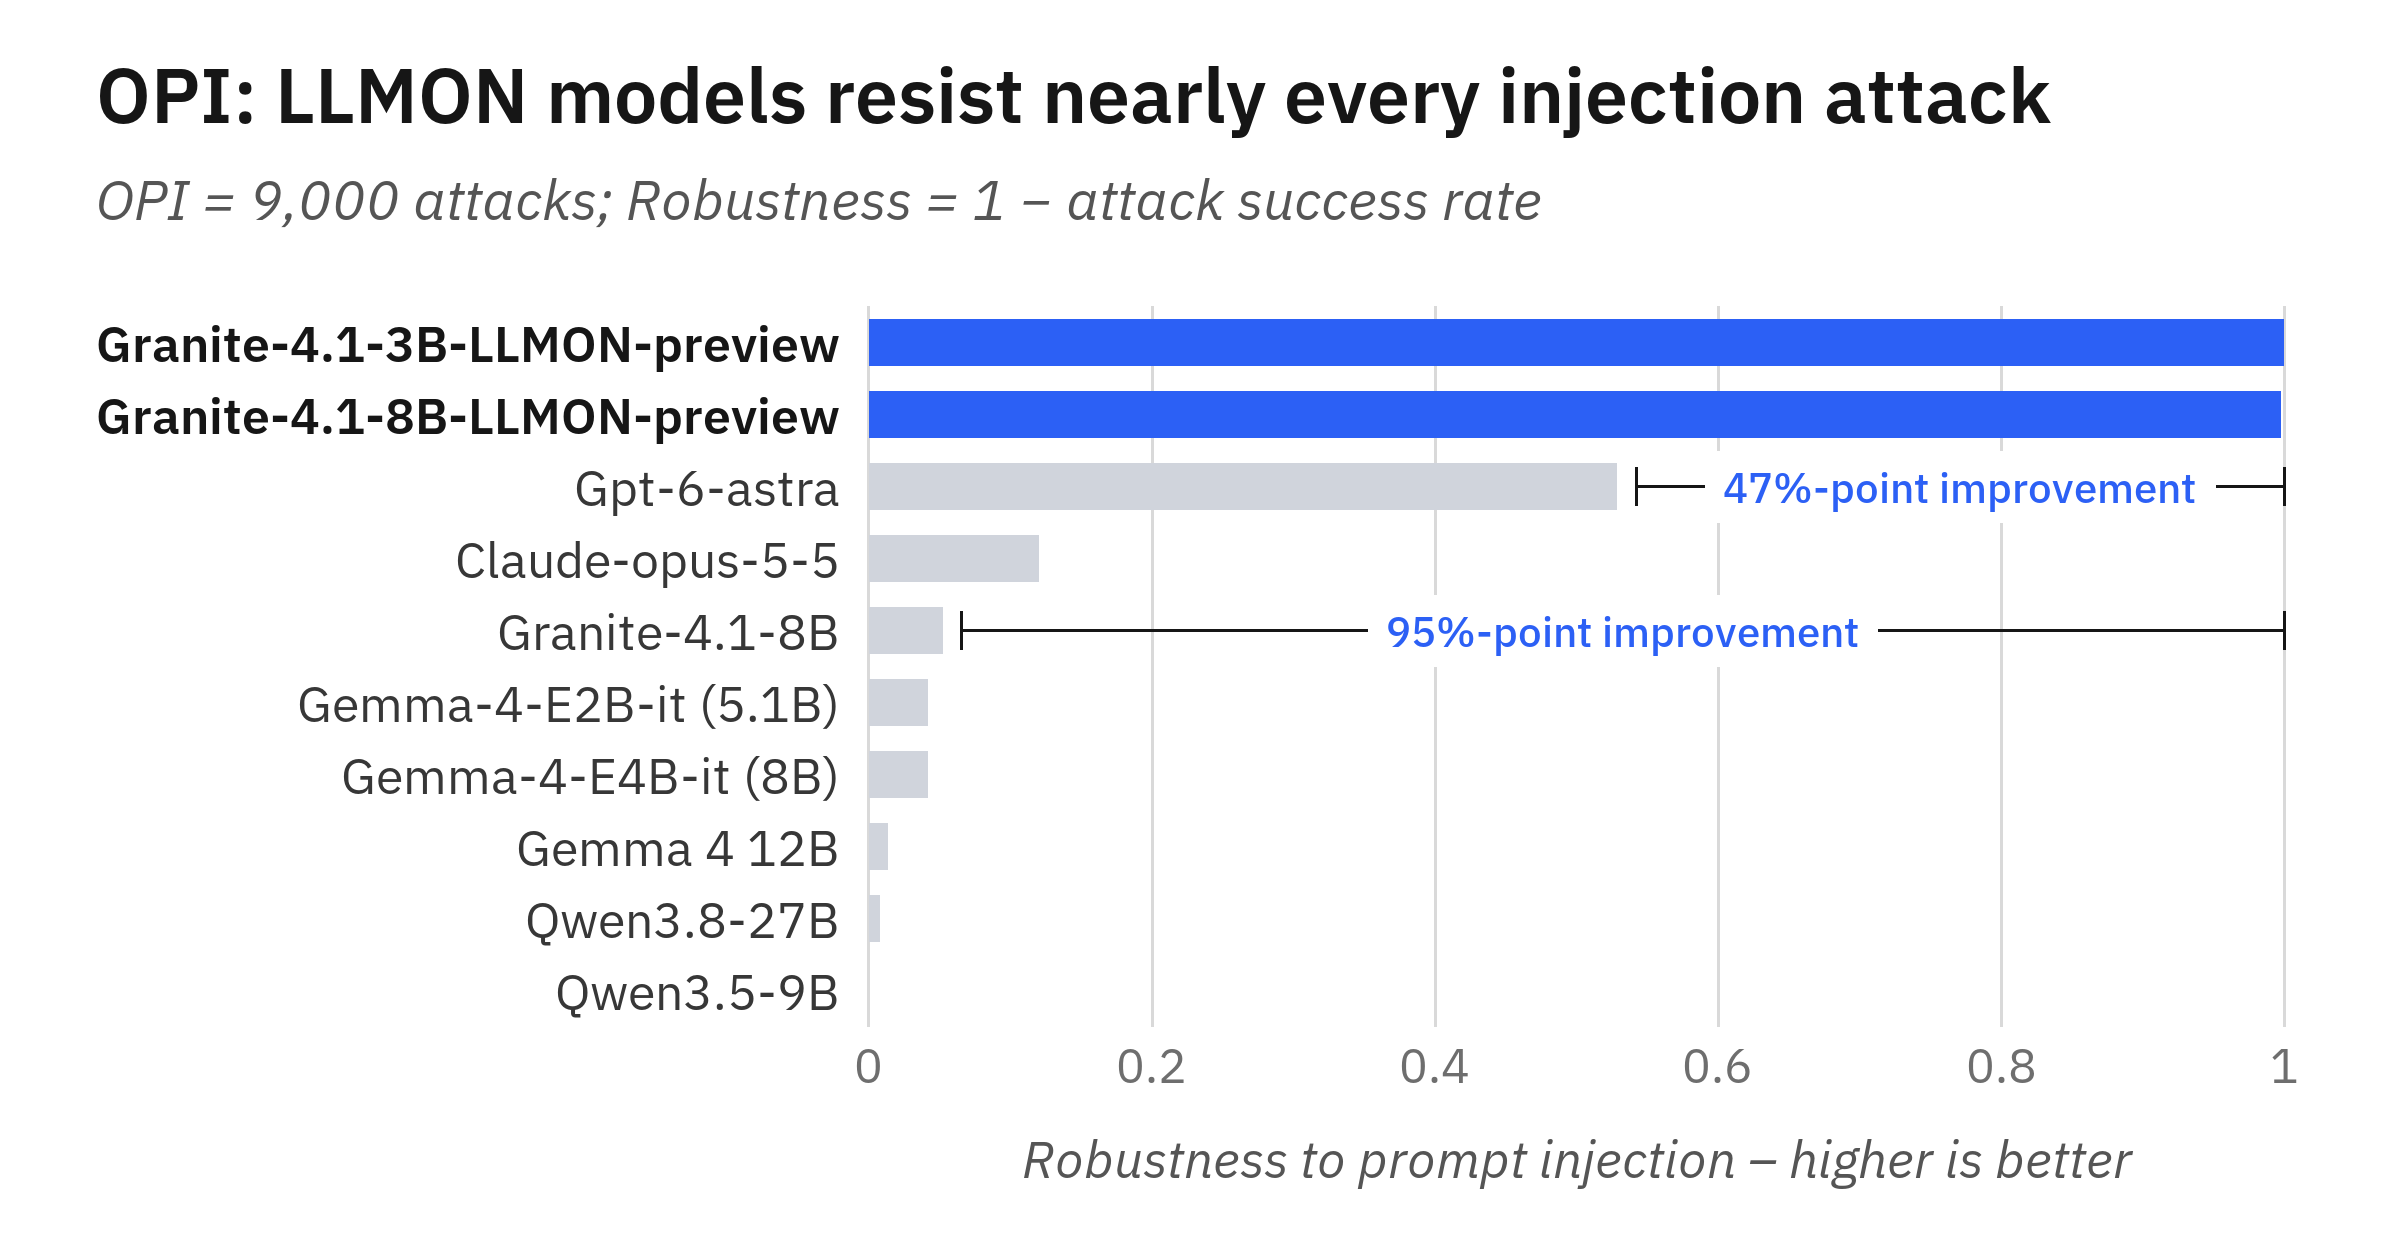
- Modelos sem LLMON seguem a instrução injetada com alta probabilidade.
- O LLMON evita 47% mais ataques do que o melhor modelo de fronteira testado.
- O LLMON evita 95% mais ataques do que o melhor modelo aberto testado.
- Tendência semelhante aparece nos benchmarks ASB e StruQ.
Vale uma ressalva que a própria equipe faz: esses benchmarks testam injeção estática, aquela que aparece de uma vez no dado. Ataques adaptativos, que se desenrolam ao longo de vários turnos de conversa, ainda estão em desenvolvimento ativo pela equipe. E a defesa não veio às custas de capacidade geral: nos benchmarks padrão, os previews LLMON ficam no mesmo patamar dos modelos Granite 4.1 Instruct correspondentes.
Como os modelos foram treinados
Os previews partem dos checkpoints base do Granite 4.1, não dos modelos instruct já lançados, para que o comportamento LLMON seja aprendido durante o pós-treinamento em vez de sobreposto a um formato de chat existente. A IBM reserializou um corpus convencional de instruction-tuning em LLMON, transformando cada componente do prompt em um bloco endereçável com um bloco exec nomeando qual instrução rodar, sobre quais dados e para onde mandar a saída.
Para ensinar o modelo a ignorar o que não é chamado, a equipe aumentou os dados com instruções e blocos de dado deliberadamente deixados sem vínculo no exec, mantendo a saída-alvo inalterada. Depois veio reforço: cinco estágios sequenciais de GRPO cobrindo raciocínio multi-domínio, RLHF, calibração de conhecimento e matemática, seguidos por um estágio final de DPO sobre mil pares de preferência construídos a partir das próprias respostas do modelo a tentativas de injeção.
Vocabulário próprio: o experimento com ScienceWorld
O LLMON não trava num schema fixo: dá para escolher nomes de tag e estrutura que façam sentido para o seu domínio e ajustar uma LoRA para que o modelo entenda esse vocabulário. A IBM demonstrou isso no ScienceWorld, benchmark de agente baseado em texto que executa tarefas de ciência elementar (como ferver água) emitindo um comando por vez.
A equipe definiu tags como instr.task.goal, req.planning_policy.rule, data.state.room, data.state.inventory e assistant.next_action, renderizou as trajetórias de referência do benchmark nesse vocabulário e treinou uma LoRA sobre um modelo LLMON. O modelo resultante joga partidas de teste nunca vistas escrevendo sua próxima ação já no vocabulário novo, e um notebook publicado no repositório mostra o fluxo completo, da conversão das trajetórias até a comparação contra o modelo base sem o ajuste.
O que já dá para testar, e o que ainda falta
Para quem já roda Granite 4.1 3B ou 8B, trocar pelo preview LLMON não exige pipeline de conversão: nomear as partes do turno (instruction, data, requirement) já basta, porque o chat template embutido transforma isso em blocos LLMON automaticamente. A biblioteca LLMON-converters vai um passo além e preserva estrutura aninhada (um JSON dentro do payload, por exemplo) como blocos tipados e endereçáveis, em vez de uma string opaca. O framework Mellea já tem suporte nativo, LLMONizando as chamadas de LLM automaticamente, e há uma visualização de atenção publicada como Space no Hugging Face para quem quer ver a separação instrução/dado acontecendo nas camadas do modelo.
A ressalva mais importante está no próprio anúncio: isso é um preview experimental, pronto para exploração e avaliação, não para produção. A regra de privilégio (instrução alcançada por um bloco exec é autoritativa; o que chega como dado é material para ler, não comando para obedecer) é um comportamento aprendido durante o treinamento, não uma garantia imposta por engenharia. Quem decidir testar em cima de dados sensíveis deve tratar o ganho de robustez contra prompt injection como evidência de benchmark, não como blindagem certificada, e acompanhar o repositório no GitHub (generative-computing/llmon) e os papers citados pela equipe para ver como a defesa evolui contra ataques adaptativos de múltiplos turnos.
Fonte: Hugging Face Blog
Highlights
- IBM lança LLMON em 12 de novembro com previews do Granite 4.1 (3B e 8B), linguagem de marcação nativa para LLMs
- LLMON evita 47% mais ataques de prompt injection que melhor modelo de fronteira testado
- Delimitadores são tokens especiais, não caracteres JSON, melhorando parsing por modelos causais
- Chat template embutido transforma structure convencional em blocos LLMON automaticamente
- Ainda experimental: defesa contra injeção é padrão estatístico aprendido, não garantia de engenharia
Este artigo foi escrito por Alan Andrade, colunista de inteligência artificial. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Jev se torna peça de infraestrutura para quem constrói agentes em produção
No AI Engineer Code Summit, o criador do Jev defendeu colocar chamadas de modelos