Particionar não é otimizar. É organizar
Se você já pesquisou sobre particionamento de tabelas, provavelmente leu que ele “melhora a performance”. Não é mentira mas, também não é verdade =D, é uma meia verdade que atrapalha mais do que ajuda. É por causa dela que tanta gente particiona uma tabela, e não vê as queries ficarem mais rápidas e conclui que “particionamento não funciona”.
Este é o primeiro post de uma série comparando como SQL↳SQL64 conteúdosSQL Server – Como evitar SQL Injection?Data · mai 2019Azure SQL DB Managed InstanceData · abr 2019SQL Server – Como evitar SQL Injection? Pare de utilizar Query Dinâmica como EXEC(@Query)Data · abr 2019Ver tudo em Data → Server e PostgreSQL implementam particionamento. Antes de descer pra sintaxe e pras diferenças de arquitetura, precisamos alinhar o conceito, porque se o motivo pra particionar estiver errado, o resto vira complexidade sem retorno.
Sobre o ambiente: todos os testes e demos da série rodam em SQL Server 2025 e PostgreSQL 18 as versões mais recentes de cada banco. Isso importa porque particionamento é uma das áreas que mais evoluiu nos últimos anos, especialmente no PostgreSQL, e muita dica antiga que circula por aí já não se aplica.
A analogia da biblioteca
Imagina uma biblioteca com 10 milhões de livros, todos numa estante única, sem divisão por ano, assunto ou autor. Achar um livro específico ainda funciona existe um catálogo, um sistema de busca. É o papel que os índices já cumprem no banco.
O problema aparece na outra ponta, bem menos comentada a biblioteca precisa retirar de circulação todos os livros anteriores a 2019. Na estante única, isso é vasculhar livro por livro, conferir a data, retirar um a um com a biblioteca aberta e gente circulando.
Numa biblioteca dividida em seções por ano, a mesma tarefa é destacar a seção “2019” da prateleira e levá-la embora inteira. Ninguém que estava lendo um livro de 2024 percebeu a movimentação.
Particionar uma tabela é exatamente isso dividir os dados em blocos físicos menores que seriam as partições com base em um critério, geralmente uma faixa de datas (mas pode ser uma lista de valores ou um hash). E o ganho central não é “achar a linha mais rápido”. É poder operar em blocos inteiros de dados sem tocar no resto.
Os três motivos reais pra particionar
Quase todo caso legítimo de particionamento cai em uma (ou mais) destas três categorias e a ordem importa:
1. Manutenção. Rebuild de índice, atualização de estatísticas, verificações de integridade tudo fica mais barato quando dá pra operar uma partição de cada vez em vez de processar a tabela inteira. Numa tabela de centenas de milhões de linhas, um rebuild completo pode levar horas e consumir uma janela de manutenção que talvez nem exista mais no seu negócio. Por partição, a mesma operação vira algo administrável e as partições antigas, que não mudam, nem precisam ser tocadas.
2. Gerenciamento de ciclo de vida dos dados. Dados tem validade, o log de auditoria de cinco anos atrás não precisa morar na mesma prateleira que o dado de ontem pode ir pra storage mais barato ou ser expurgado por política de retenção. Sem particionamento, expurgar é um DELETE de milhões de linhas lento, gera um log de transação gigante e disputa recursos com a produção. Com particionamento por data, é desconectar a partição uma operação de metadado, quase instantânea. Esse é o assunto central do post 4, onde comparo o SWITCH do SQL Server com o DETACH PARTITION do PostgreSQL.
3. Performance por último, e com asterisco. É o motivo que todo mundo escuta primeiro e, justamente por isso, o mais mal aplicado. Quando o otimizador identifica que uma query só precisa de uma ou duas partições, ele ignora completamente as demais isso se chama partition pruning, e quando acontece, o ganho é real. O asterisco só acontece se o padrão de acesso da aplicação já filtra naturalmente pela coluna de partição. Se as queries varrem a tabela por outros critérios, particionar não acelera em nada só adiciona complexidade operacional. E existem casos em que o pruning falha silenciosamente mesmo com o filtro certo; o post 3 é inteiro sobre isso.
O teste rápido: sua tabela precisa disso?
Antes de particionar qualquer coisa, três perguntas:
A manutenção regular dessa tabela (rebuild, estatísticas, backup) já está sendo um problema? Existe rotina recorrente de arquivar ou expurgar dados antigos? As queries mais frequentes já filtram por uma coluna que poderia ser a chave de partição uma data, tipicamente?
Se a maioria das respostas for “não”, sua tabela provavelmente ainda não precisa de particionamento e isso é uma boa notícia, não uma limitação. Particionamento carrega custo operacional real (design da chave, rotina de criação de partições futuras, atenção redobrada em constraints e índices), e pagar esse custo sem colher os benefícios é o pior dos mundos. O post 5 fecha a série com esse framework de decisão em detalhe.
O que vem a seguir
Até aqui, tudo que eu disse vale igualmente para os dois bancos. A partir do próximo post, os caminhos se separam e de forma mais radical do que a maioria imagina.
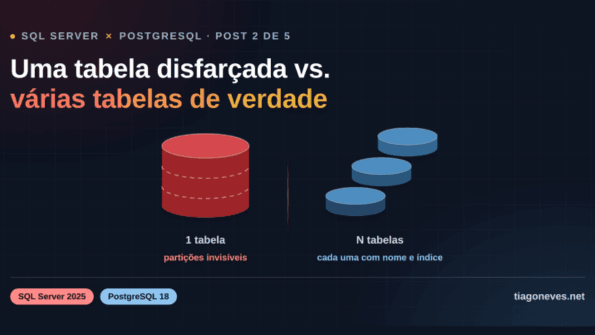
O SQL Server 2025 esconde o particionamento atrás de uma única tabela lógica quem consulta nem sabe que as “estantes de livros” existem. O PostgreSQL 18 faz o oposto cada partição é uma tabela de verdade, com nome, índices e vida própria. Parece detalhe de implementação, mas essa escolha filosófica muda regras de chave primária, comportamento de índices e até o que acontece no catálogo do banco e costuma surpreender inclusive quem já conhece os dois bancos.
É sobre isso o post 2: “Uma tabela disfarçada vs. várias tabelas de verdade”. Até lá.

O SQL deveria ter morrido várias vezes. Por que continua aqui?
A ideia que libertou os dados: como nasceu uma das maiores revoluções da computação.

Banco, busca, fila e vetores no Postgres: quando a simplicidade vira risco?
Swap no Linux: Como a gestão de memória evita quedas em servidores corporativos
 Alex Hinckel
O erro não é escolher lakehouse ou warehouse, é modelar dados sem contrato de consumo
 John Calistro
GraphRAG – Teoria, prática e o por que você deve aprender o quanto antes.
 Airton Lira Junior
Tutorial de CRUD com TypeScript, Prisma e SQL
 Luiz Fernando Duarte Junior