O SQL deveria ter morrido várias vezes. Por que continua aqui?

Este é o terceiro e último artigo da série A Revolução Silenciosa dos Dados. Ao longo da história da computação, poucas tecnologias foram declaradas ultrapassadas tantas vezes quanto os bancos de dados↳Banco de dados134 conteúdosSQL ou NoSQL: eis a questão!!Data · mar 2020Banco de dados: como organizar e dar segurança para milhões de dados de loteriasData · mai 20215 serviços gratuitos na cloud para bancos de dados PostgresData · fev 2025Ver tudo em Data → relacionais.
Internet, grandes serviços digitais, NoSQL, big data, cloud e, agora, inteligência artificial↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI →. A cada nova onda surge uma narrativa semelhante: aparecem novas necessidades, as tecnologias existentes revelam limitações e novas arquiteturas são apresentadas não apenas como alternativas, mas como substitutas inevitáveis das anteriores.
A realidade foi bem menos linear. Mais de cinquenta anos depois do artigo de Edgar F. Codd, bancos relacionais continuam sustentando sistemas corporativos, aplicações digitais e plataformas analíticas. O SQL atravessou mainframes, cliente-servidor, internet, software livre↳Open source71 conteúdosComo o Open Source Está Liberando o Poder da Automação para TodosDev (Back & Front) · out 2025Código aberto: programadores criam software da NASA sem saberDev (Back & Front) · abr 2021N8N: O que é a ferramenta open source que está revolucionando a automação em TI?Dev (Back & Front) · dez 2025Ver tudo em Dev (Back & Front) →, computação distribuída e nuvem. E tecnologias criadas fora do universo relacional acabaram, em muitos casos, incorporando interfaces SQL ou conceitos próximos aos do modelo relacional.
No início dos anos 2000, a expansão da internet trouxe desafios importantes. Aplicações passaram a atender milhões de usuários, os volumes de dados cresceram rapidamente e documentos, eventos, mensagens e outros dados semiestruturados ganharam relevância.
Ganharam espaço novas gerações de bancos chave-valor, orientados a documentos, famílias de colunas e grafos, reunidas posteriormente sob o amplo e heterogêneo movimento NoSQL. Eram tecnologias diferentes, buscando combinações distintas de escalabilidade, disponibilidade, flexibilidade, desempenho e consistência.
O erro foi transformar uma discussão sobre trade-offs arquiteturais em uma disputa entre tecnologia moderna e tecnologia ultrapassada. Modelo relacional, SQL e arquitetura física são conceitos diferentes. O modelo relacional descreve uma forma lógica, fundamentada matematicamente, de representar e manipular informações. SQL é uma linguagem inspirada nesse modelo, embora não seja uma implementação perfeita da teoria relacional. Já a arquitetura física determina como armazenamento, processamento, replicação e distribuição são implementados.
Nada no modelo relacional exige que os dados estejam em um único servidor. Da mesma forma, utilizar SQL não significa reproduzir a arquitetura de um banco dos anos 1980.
Essa distinção ajuda a explicar o que aconteceu depois. Bancos relacionais incorporaram suporte a JSON, particionamento, processamento paralelo, armazenamento colunar, replicação e distribuição. Ao mesmo tempo, plataformas originalmente não relacionais passaram a oferecer interfaces SQL. Não houve simplesmente substituição. Houve especialização, coexistência e convergência.
Uma das razões está no poder da abordagem declarativa. Nas consultas SQL, descrevemos predominantemente o resultado desejado, enquanto o sistema determina grande parte da estratégia física de execução. Índices, estratégias de junção, paralelismo e caminhos de acesso podem mudar sem exigir que o usuário controle cada detalhe.
Essa abstração continua extremamente poderosa. O Spanner é um exemplo interessante. Apresentado pelo Google em 2012 como um banco globalmente distribuído, evoluiu posteriormente em direção a uma interface relacional. O próprio título de um artigo publicado em 2017 é revelador: “Spanner: Becoming a SQL System”.
Isso não significa que o Spanner seja simplesmente um banco tradicional distribuído. Sua arquitetura possui características próprias. Mas demonstra que escala global, distribuição e SQL não são conceitos necessariamente incompatíveis.
A nuvem aprofundou essa separação entre interface lógica e infraestrutura física. Bancos passaram a ser consumidos como serviços gerenciados, enquanto armazenamento, replicação, disponibilidade e parte da operação ficaram progressivamente escondidos atrás da plataforma.
O mesmo ocorreu com analytics. Data warehouses modernos podem utilizar armazenamento colunar, processamento massivamente paralelo e arquiteturas distribuídas muito diferentes dos bancos transacionais tradicionais, mantendo SQL como uma de suas principais interfaces.
Em outubro de 2026, o ranking DB-Engines ainda colocava Oracle, MySQL, Microsoft SQL Server e PostgreSQL nas quatro primeiras posições. O indicador não mede diretamente participação de mercado, receita ou instalações, mas utiliza diferentes sinais públicos de popularidade. Portanto, não demonstra domínio comercial, mas oferece um indicador da persistente relevância dos sistemas relacionais no ecossistema tecnológico.
Isso não significa que bancos relacionais sejam adequados para todos os problemas. Documentos, grafos, séries temporais, mecanismos de busca e outras arquiteturas podem oferecer vantagens importantes em determinados contextos. Maturidade tecnológica não significa utilizar SQL para tudo. Significa compreender quando utilizá-lo e quando outra abordagem é mais adequada.
Agora surge uma nova transformação: a IA generativa. Modelos de linguagem já conseguem transformar solicitações em linguagem natural em consultas SQL, explicar estruturas de dados e auxiliar na construção de análises. Isso pode reduzir a necessidade de escrever SQL diretamente em determinadas atividades, especialmente para usuários de negócio. Mas não torna SQL nem os bancos subjacentes irrelevantes. Apenas acrescenta uma nova camada de abstração.
E existe aqui uma diferença fundamental em relação às abstrações anteriores. Um otimizador de consultas recebe uma operação cuja semântica já foi especificada e decide, predominantemente, como executá-la. Um LLM que recebe uma pergunta em linguagem natural precisa antes interpretar o que o usuário realmente pretende saber e transformar essa intenção em operações sobre os dados.
Isso introduz uma nova dimensão de incerteza. Um LLM pode gerar uma consulta SQL sintaticamente perfeita, executá-la sem erros, recuperar registros existentes e, ainda assim, produzir uma resposta empresarialmente errada.
Considere uma solicitação aparentemente simples como “mostre a receita líquida desta unidade de negócios”.
O significado de receita líquida depende de definições. Quais descontos devem ser considerados? Como tratar devoluções? Quais operações pertencem à unidade? Qual período deve ser utilizado? Existe uma definição corporativa oficial para o indicador?
A consulta pode estar tecnicamente correta e responder à pergunta errada. Esse problema já existia antes da IA. Mas sistemas generativos podem torná-lo menos perceptível porque apresentam os resultados em linguagem natural, acompanhados de explicações convincentes.
A facilidade da interface não garante a correção da interpretação. Continuamos precisando de modelos de dados adequados, definições semânticas consistentes, qualidade, linhagem, controles de acesso e governança. Para responder sobre saldos, contratos, estoques ou transações, um LLM também precisa consultar fontes suficientemente autoritativas.
Muitas delas continuam sendo bancos relacionais. Paradoxalmente, portanto, a IA pode aumentar, e não diminuir, a importância de dados estruturados, governados e confiáveis.
Algo semelhante ocorre com bancos vetoriais. Embeddings e busca por similaridade tornaram-se componentes importantes de muitas aplicações de IA, mas não substituem automaticamente bancos relacionais.
Encontrar documentos semanticamente relacionados é um problema diferente de recuperar transações que atendam a critérios exatos. Em muitas arquiteturas, as duas capacidades convivem. Bancos relacionais também passaram a incorporar recursos vetoriais, permitindo combinar diferentes formas de recuperação de informação dentro de uma mesma plataforma.
Mais uma vez, a evolução não ocorre necessariamente pela substituição completa de uma tecnologia por outra.
Existe aqui uma conexão particularmente interessante com 1970. Codd buscava reduzir a dependência de usuários e aplicações em relação aos detalhes físicos da organização dos dados. O modelo relacional forneceu uma abstração lógica. SQL acrescentou uma interface declarativa que permitiu expressar operações sem determinar todos os caminhos físicos de execução. A nuvem posteriormente abstraiu parte da própria infraestrutura operacional.
Agora, a IA generativa começa a abstrair até mesmo a formulação das consultas. Mas essa nova camada é diferente. Não estamos apenas escondendo detalhes técnicos de execução. Estamos delegando ao sistema parte da interpretação do significado daquilo que queremos saber.
E isso muda a natureza do problema. Quanto maior a distância entre o usuário e os mecanismos que produzem uma resposta, mais importantes se tornam confiabilidade, rastreabilidade, observabilidade↳Observabilidade11 conteúdosObservabilidade para APIs: os desafios e benefícios dessa abordagemDev (Back & Front) · jan 2025Falhas em Observabilidade afetam os Apps e a Segurança das OrganizaçõesDev (Back & Front) · nov 2023ADK Java 1.0: O Google quer que você pare de gambiarra Python no seu backendMarketing Tech · abr 2026Ver tudo em DevSecOps → e governança.
Uma resposta aparentemente simples pode esconder um LLM, mecanismos de recuperação, bancos vetoriais, consultas SQL, regras de negócio e diversos sistemas corporativos.
A abstração também redistribui responsabilidades. O modelo relacional reduziu a dependência em relação à organização física dos dados. SQL transferiu parte das decisões de execução para o sistema gerenciador e seus otimizadores. A nuvem transferiu parte da operação da infraestrutura para provedores. Agora, interfaces baseadas em IA começam a transferir parte da interpretação das solicitações para modelos probabilísticos. Cada camada facilita determinadas tarefas, mas também cria novas dependências.
Depois de mais de quatro décadas acompanhando a evolução da tecnologia, vejo nessa trajetória uma característica das inovações realmente duradouras. Elas raramente permanecem relevantes porque suas implementações originais sobrevivem intactas. Permanecem porque suas abstrações continuam úteis enquanto as tecnologias ao redor mudam.
O modelo relacional não permaneceu relevante porque os bancos atuais funcionam como os sistemas experimentais dos anos 1970. SQL tampouco permaneceu imutável. Ambos evoluíram, incorporaram capacidades e passaram a operar sobre arquiteturas que seus criadores dificilmente poderiam imaginar. Nenhuma tecnologia possui garantia de permanência. Novos modelos de dados, interfaces e arquiteturas continuarão surgindo.
Mas a história do SQL mostra que uma tecnologia pode deixar de ser novidade sem deixar de ser fundamental. Talvez essa seja a principal conclusão desta série.
A grande contribuição de Edgar F. Codd não foi simplesmente colocar informações em tabelas. Foi estabelecer uma abstração matemática que ajudou a separar a representação lógica dos dados dos detalhes de sua implementação física.
Em 1970, começamos a abstrair parte da organização física dos dados. Depois, SQL ajudou a abstrair parte da navegação e da execução. A nuvem abstraiu parte da infraestrutura. Agora, a IA começa a abstrair até mesmo a linguagem utilizada para solicitar informações.
Mas existe um paradoxo interessante: quanto mais simples fica a interface, mais sofisticada pode se tornar a infraestrutura invisível necessária para sustentá-la.
As interfaces mudam. As arquiteturas mudam. Continuamos, entretanto, precisando armazenar informações, relacioná-las, preservar sua integridade, compreender seu significado e recuperá-las de maneira confiável.
A história da computação não é apenas uma sucessão de tecnologias que substituem outras. É também a história de abstrações que sobrevivem porque continuam resolvendo problemas fundamentais.
E a trajetória do SQL deixa uma lição especialmente relevante na era da inteligência artificial: o progresso tecnológico frequentemente torna a complexidade menos visível. Mas torná-la invisível não significa eliminá-la e nem nos dispensa de compreendê-la.


O resumo que nunca existiu…

Análise de dados para todos: Como o Claude garante autonomia às equipes.
Dissecando as entranhas de um LLM: o que são logprobs e por que eles são tão importantes?
 Cezar Taurion
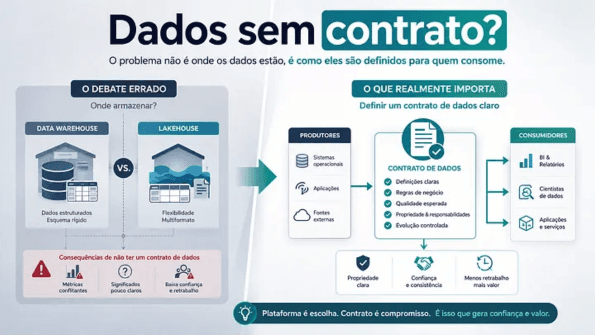
O erro não é escolher lakehouse ou warehouse, é modelar dados sem contrato de consumo
 John Calistro
SQL Server – Como consultar o histórico de execução de jobs do SQL Server Integration Services Catalog (SSISDB)
 Dirceu Moraes Resende Filho
Além da Transação: Uma Nova Visão para a Prevenção de Fraudes e Ataques Cibernéticos
 Thiago Labliuk