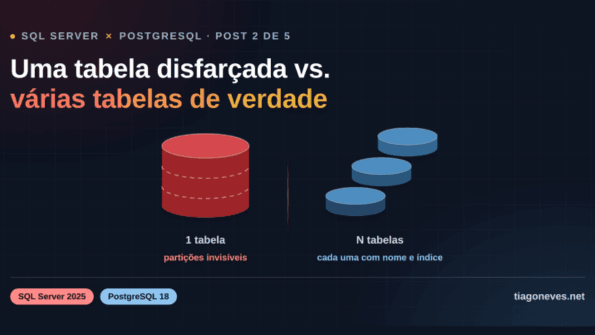
✅ 02 · Uma tabela disfarçada vs. várias tabelas de verdade 👈 você está aqui
No post anterior da série, a conversa foi conceitual e valia igualmente para os dois bancos: particionar é sobre organizar dados em blocos, não sobre acelerar query.
Agora os caminhos se separam. E de forma mais radical do que parece.
Ambiente: SQL Server 2025 e PostgreSQL 18. Os scripts do PostgreSQL abaixo foram executados de verdade as saídas e mensagens de erro são reais, não escritas de memória.
Antes: ficou faltando explicar o “partition pruning”
No post 1 eu usei esse termo de passagem e algumas pessoas me perguntaram o que era. Justo afinal foi falha minha não explicar no post, como ele vai aparecer o tempo todo daqui pra frente (e é o assunto inteiro do post 3), vamos resolver isso agora, na lógica.
Pruning é o banco decidir quais partições ele nem vai abrir.
Voltando à biblioteca do post 1: se você pede um livro publicado em 2026, o bibliotecário não precisa procurar nas seções de 2019, 2020 e 2021. Ele olha a etiqueta de cada seção e descarta as que não podem conter o que você pediu sem tirar um único livro da estante.
O banco faz exatamente isso, em três passos:
Quando você cria as partições, o banco guarda os limites de cada uma como metadado (a partição de janeiro vai de 01/01 a 31/01, e assim por diante) *caso o range de particionamento seja um campo do tipo data. Isso é informação barata, que ele consulta sem tocar nos dados.
Ao montar o plano da query, ele compara o filtro da cláusula WHERE com esses limites.
Toda partição cujo intervalo não pode conter o dado pedido é descartada. Não entra no plano, nem é lida
Repare que isso é diferente de um índice. O índice ajuda a achar linhas dentro de um conjunto de dados; o pruning decide quais conjuntos de dados sequer serão abertos. Ele acontece antes, e é por isso que o ganho pode ser grande.
Explicações realizadas, agora vamos ao assunto do post 2.
A pergunta que separa os dois mundos
Quando você particiona uma tabela, quantas tabelas passam a existir?
No SQL Server, a resposta é: uma. Você cria uma partition function (que define os limites) e um partition scheme (que mapeia esses limites para filegroups), e aplica isso na criação da tabela. Do ponto de vista de quem consulta e do catálogo continua existindo uma tabela o que muda é que agora ela passa a ser organizada em filegroups. As partições são uma característica interna dela.
No PostgreSQL, a resposta é totalmente diferente, uma tabela para cada partição. A tabela “pai” é como se fosse camada que não armazena nada, e cada partição é uma tabela real, que existe no catálogo, aparece num \dt e pode até ser consultada diretamente pelo nome.
Vamos ver isso acontecendo.
PostgreSQL: as partições são tabelas mesmo
CREATE TABLE vendas ( id bigint GENERATED ALWAYS AS IDENTITY, data_venda date NOT NULL, cliente_id int NOT NULL, valor numeric(12,2) NOT NULL) PARTITION BY RANGE (data_venda);CREATE TABLE vendas_2026_01 PARTITION OF vendas FOR VALUES FROM ('2026-01-01') TO ('2026-02-01');CREATE TABLE vendas_2026_02 PARTITION OF vendas FOR VALUES FROM ('2026-02-01') TO ('2026-03-01');CREATE TABLE vendas_2026_03 PARTITION OF vendas FOR VALUES FROM ('2026-03-01') TO ('2026-04-01');
Quando olhamos no pgAdmin, identificamos a tabela criada um pequeno “P” no nome da tabela.
SQL Server: a divisão fica por baixo do pano
-- 1) a função define ONDE cortarCREATE PARTITION FUNCTION pf_vendas_mensal (date)AS RANGE RIGHT FOR VALUES ('2026-01-01', '2026-02-01', '2026-03-01');-- 2) o esquema define ONDE cada pedaço vai morarCREATE PARTITION SCHEME ps_vendas_mensalAS PARTITION pf_vendas_mensal ALL TO ([PRIMARY]);-- 3) a tabela nasce apontando pro esquemaCREATE TABLE dbo.vendas ( id bigint IDENTITY(1,1) NOT NULL, data_venda date NOT NULL, cliente_id int NOT NULL, valor decimal(12,2) NOT NULL) ON ps_vendas_mensal (data_venda);
Verificando as partições:
SELECT p.partition_number, p.rows, fg.name AS filegroupFROM sys.partitions pJOIN sys.allocation_units au ON au.container_id = p.hobt_idJOIN sys.filegroups fg ON fg.data_space_id = au.data_space_idWHERE p.object_id = OBJECT_ID('dbo.vendas') AND p.index_id IN (0,1);
Você vê as partições mas como linhas de metadado de um único objeto. Não existe dbo.vendas_2026_01 e nunca vai existir.
Indo além do [PRIMARY]: cada partição no seu filegroup
Como podemos observer as partições foram todas criadas no filegroup “PRIMARY”.
Repare no ALL TO ([PRIMARY]) do exemplo acima todas as partições moram no mesmo lugar. Funciona, e é como muita gente começa, mas é justamente aí que o SQL Server tem um dos seus melhores argumentos e ele fica escondido atrás de uma palavra que assusta quem está começando: filegroup.
Filegroup, na lógica: é uma “prateleira” dentro do banco, formada por um ou mais arquivos em disco. Você escolhe em qual disco cada prateleira fica. E o partition scheme é quem diz em qual prateleira cada partição vai morar.
Juntando as duas coisas, dá pra fazer algo muito útil: colocar cada fatia de tempo dos seus dados no disco e no regime de cuidado que ela merece.
O caso: dado quente, dado morno, dado frio
Pensa numa tabela de VENDAS com vários anos de histórico. Na prática:
2026 (ano corrente) é lido e escrito o dia inteiro. Precisa de disco rápido e de backup todo dia.
2025 (ano fechado) ainda é consultado com frequência relatórios, comparativos, mas ninguém mais altera uma venda do ano passado.
2024 e anteriores quase não são lidos. Existem por exigência legal ou de auditoria.
Sem particionamento, os três tipos de dado recebem o mesmo tratamento o mesmo disco caro, o mesmo backup diário, o mesmo DBCC CHECKDB varrendo tudo. Você paga todo dia para proteger, de novo, dado que não muda há anos.
Com uma partição por ano, cada uma no seu filegroup, o desenho fica assim:
Filegroup
Dados
Disco
Estado
FG_2027
vazia, pronta pro próximo ano
rápido
leitura e escrita
FG_2026
ano corrente – quente
rápido (NVMe)
leitura e escrita
FG_2025
ano fechado – morno
rápido
somente leitura
FG_2024
frio
barato
somente leitura
FG_HIST
tudo antes de 2024 – frio
barato
somente leitura
CREATE DATABASE VendasDB;GOUSE VendasDB;GO-- 1) as "prateleiras": um filegroup por anoALTER DATABASE VendasDB ADD FILEGROUP FG_HIST;ALTER DATABASE VendasDB ADD FILEGROUP FG_2024;ALTER DATABASE VendasDB ADD FILEGROUP FG_2025;ALTER DATABASE VendasDB ADD FILEGROUP FG_2026;ALTER DATABASE VendasDB ADD FILEGROUP FG_2027;-- 2) cada prateleira ganha um arquivo, no disco adequadoALTER DATABASE VendasDB ADD FILE (NAME = 'Vendas_HIST', FILENAME = 'F:\SQLData\Vendas_HIST.ndf', SIZE = 1GB, FILEGROWTH = 512MB) TO FILEGROUP FG_HIST; -- disco baratoALTER DATABASE VendasDB ADD FILE (NAME = 'Vendas_2024', FILENAME = 'F:\SQLData\Vendas_2024.ndf', SIZE = 1GB, FILEGROWTH = 512MB) TO FILEGROUP FG_2024; -- disco baratoALTER DATABASE VendasDB ADD FILE (NAME = 'Vendas_2025', FILENAME = 'E:\SQLData\Vendas_2025.ndf', SIZE = 1GB, FILEGROWTH = 512MB) TO FILEGROUP FG_2025; -- disco rápidoALTER DATABASE VendasDB ADD FILE (NAME = 'Vendas_2026', FILENAME = 'E:\SQLData\Vendas_2026.ndf', SIZE = 1GB, FILEGROWTH = 512MB) TO FILEGROUP FG_2026; -- disco rápidoALTER DATABASE VendasDB ADD FILE (NAME = 'Vendas_2027', FILENAME = 'E:\SQLData\Vendas_2027.ndf', SIZE = 256MB, FILEGROWTH = 512MB) TO FILEGROUP FG_2027; -- disco rápidoGO-- 3) a função: 4 limites = 5 partições-- (<2024 | 2024 | 2025 | 2026 | >=2027)CREATE PARTITION FUNCTION pf_vendas_anual (date)AS RANGE RIGHT FOR VALUES ('2024-01-01', '2025-01-01', '2026-01-01', '2027-01-01');-- 4) o esquema: 5 partições, 5 filegroups, na mesma ordemCREATE PARTITION SCHEME ps_vendas_anualAS PARTITION pf_vendas_anualTO (FG_HIST, FG_2024, FG_2025, FG_2026, FG_2027);-- 5) a tabela — repare na PK com a coluna de partição (mais sobre isso abaixo)CREATE TABLE dbo.vendas ( id bigint IDENTITY(1,1) NOT NULL, data_venda date NOT NULL, cliente_id int NOT NULL, valor decimal(12,2) NOT NULL, CONSTRAINT pk_vendas PRIMARY KEY CLUSTERED (id, data_venda)) ON ps_vendas_anual (data_venda);GO
Três detalhes aqui que valem ouro pra quem está começando:
Com RANGE RIGHT, N limites geram N+1 partições. Quatro datas na função, cinco partições. O esquema precisa listar pelo menos essa quantidade de filegroups se faltar, o CREATE PARTITION SCHEME falha.
A ordem do TO (…) é a ordem das partições. O primeiro filegroup recebe a primeira partição (tudo antes de 2024), e assim por diante.
Deixei uma partição vazia no fim (FG_2027) de propósito. Isso vai fazer toda a diferença na manutenção já já.
Para verificar a distribuição dos dados:
SELECT p.partition_number AS particao,

fg.name AS filegroup,

prv.value AS a_partir_de,

p.rows AS linhas,

fg.is_read_only AS somente_leitura

FROM sys.partitions p

JOIN sys.indexes i

ON i.object_id = p.object_id AND i.index_id = p.index_id

JOIN sys.partition_schemes ps

ON ps.data_space_id = i.data_space_id

JOIN sys.destination_data_spaces dds

ON dds.partition_scheme_id = ps.data_space_id

AND dds.destination_id = p.partition_number

JOIN sys.filegroups fg

ON fg.data_space_id = dds.data_space_id

LEFT JOIN sys.partition_range_values prv

ON prv.function_id = ps.function_id

AND prv.boundary_id = p.partition_number - 1

WHERE p.object_id = OBJECT_ID('dbo.vendas')

AND p.index_id = 1

ORDER BY p.partition_number;
Onde o ganho aparece de verdade:
Fechar o ano: filegroup somente leitura. Virou o ano, 2025 não muda mais. Então você diz isso ao banco:
ALTER DATABASE VendasDB MODIFY FILEGROUP FG_2025 READ_ONLY;
A partir daí, qualquer tentativa de alterar uma venda de 2025 falha o que, convenhamos, é uma proteção a mais pra dado de ano fechado.
Backup do que muda, não de tudo. O dado frio precisa de um backup final depois de virar somente leitura. Nunca mais precisa de outro:
-- uma vez, logo depois de marcar como READ_ONLYBACKUP DATABASE VendasDB FILEGROUP = 'FG_2025' TO DISK = 'G:\Backup\VendasDB_FG_2025_final.bak';-- rotina diária: só o PRIMARY e os filegroups de leitura e escritaBACKUP DATABASE VendasDB READ_WRITE_FILEGROUPS TO DISK = 'G:\Backup\VendasDB_parcial.bak';
O READ_WRITE_FILEGROUPS é o chamado partial backup: ele pula os filegroups somente leitura. Numa base em que 80% do volume é histórico, o backup diário passa a copiar só os 20% que de fato mudam.
⚠️ Atenção: primeiro a linha de base, depois a rotina
O backup parcial não contém os dados antigos esse é justamente o ponto dele. Então ele só é seguro se existir, guardado, um backup que contenha esses dados. A ordem certa é:
Marque os filegroups antigos como READ_ONLY.
Depois disso, faça um backup full do banco (ou um backup de cada filegroup somente leitura). Essa é a sua linha de base.
Só então comece a rotina com READ_WRITE_FILEGROUPS.
A ordem do passo 1 e 2 importa: pro restore em etapas, a documentação exige que o filegroup somente leitura já estivesse somente leitura quando o backup foi feito e que continue assim. Um backup antigo, tirado quando o filegroup ainda aceitava escrita, não serve.
-- 1) linha de base: DEPOIS de marcar os filegroups antigos como READ_ONLYBACKUP DATABASE VendasDB TO DISK = 'G:\Backup\VendasDB_FULL_base.bak' WITH CHECKSUM;-- 2) rotina: backup parcial (é a base dos diferenciais seguintes)BACKUP DATABASE VendasDB READ_WRITE_FILEGROUPS TO DISK = 'G:\Backup\VendasDB_parcial.bak' WITH CHECKSUM;-- 3) entre um parcial e outro: diferencial parcialBACKUP DATABASE VendasDB READ_WRITE_FILEGROUPS TO DISK = 'G:\Backup\VendasDB_parcial_diff.bak' WITH DIFFERENTIAL, CHECKSUM;-- 4) no recovery model FULL, a cadeia de log continua valendoBACKUP LOG VendasDB TO DISK = 'G:\Backup\VendasDB_log.trn' WITH CHECKSUM;
Uma nota de terminologia, porque confunde muita gente: o SQL Server não tem backup “incremental” com esse nome. Quem faz esse papel são o diferencial (tudo que mudou desde a última base um full ou um parcial) e o backup de log. E todo diferencial depende da sua base: sem ela, ele não restaura nada.
Três cuidados que separam quem já perdeu backup de quem ainda não perdeu:
O backup “de uma vez só” precisa sair da rotação. Todo job de limpeza que apaga backups com mais de X dias vai, um dia, apagar a única cópia do seu histórico. Guarde a linha de base fora da política de retenção e com cópia fora do servidor.
Reabriu, refaz. Se um filegroup voltar a READ_WRITE pra corrigir um dado antigo, ao marcar READ_ONLY de novo, tire um novo backup dele. O anterior deixou de representar o que está no disco.
Backup que nunca foi restaurado é hipótese. Ensaie o restore em etapas num ambiente de teste, na ordem real, antes de precisar dele.
Restore em etapas no dia do desastre. Esse é o argumento que convence gestor. Com os dados separados por filegroup, o SQL Server permite o piecemeal restore: você restaura primeiro o PRIMARY, o FG_DADOS e o filegroup do ano corrente, e o banco volta a operar com o que importa hoje. O histórico vem depois, com calma. Em vez de “o sistema volta quando os 2 TB terminarem de restaurar”, é “a operação volta quando os 200 GB do ano corrente restaurarem”.
Verificação de integridade fatiada. Em vez de um DBCC CHECKDB que não cabe mais na janela, dá pra distribuir DBCC CHECKFILEGROUP ao longo da semana e o filegroup frio, que não muda, não precisa de atenção diária.
As letras miúdas (pra quem já é sênior)
READ_ONLY exige acesso exclusivo ao banco. A documentação é explícita: ninguém mais pode estar conectado. Na prática, isso é uma janela planejada, algo como SET SINGLE_USER WITH ROLLBACK IMMEDIATE, marcar o filegroup e SET MULTI_USER e o ROLLBACK IMMEDIATE derruba as sessões ativas. Não é comando de horário comercial.
O PRIMARY não pode ser somente leitura. Por isso, em bases particionadas, a boa prática é deixar o PRIMARY pequeno (só metadados) e os dados nos filegroups de usuário ele sempre entra no restore e no backup parcial, então quanto menor, melhor.
Restore em etapas online é recurso do Enterprise. Todas as edições fazem piecemeal restore offline (o banco sobe com o que já foi restaurado, e os filegroups restantes entram depois com o banco offline). A versão em que o histórico entra com o banco em uso é só Enterprise.
Partição vazia no fim não é detalhe. Pra criar o 2028, você cria o filegroup, marca como NEXT USED e divide a partição vazia:
  ALTER DATABASE VendasDB ADD FILEGROUP FG_2028;
  -- (+ ADD FILE para o FG_2028)
  ALTER PARTITION SCHEME ps_vendas_anual NEXT USED FG_2028;
  ALTER PARTITION FUNCTION pf_vendas_anual() SPLIT RANGE ('2028-01-01');
Sem o NEXT USED, o SPLIT falha. E depois de cada SPLIT o NEXT USED é consumido no ano seguinte, tem que marcar de novo. Mais importante dividir uma partição vazia é barato. Dividir uma partição com dados pode gerar até quatro vezes mais log e causar bloqueios severos, segundo a própria documentação. Por isso a partição vazia no fim já nasce no script.
A partição não “muda de disco” sozinha. O mapeamento partição → filegroup é fixado na criação. Se o seu plano é levar o 2025 pro disco barato quando ele esfriar, isso é mover arquivos de dados com janela e planejamento. Decida o destino de cada ano cedo, e trate a migração como um evento, não como rotina.
E as tabelas que não são particionadas?
Até aqui a conversa foi sobre VENDAS. Mas nenhum banco tem somente uma tabela. Clientes, produtos, parâmetros, usuários nada disso é particionado, e tudo isso também mora em algum filegroup.
Se ninguém disser nada, mora no filegroup padrão. E o padrão, de fábrica, é o PRIMARY. Isso cria dois problemas:
O PRIMARY incha. Toda a estratégia de manter o PRIMARY pequeno vai por água abaixo na primeira tabela criada sem ON <filegroup>.
O restore em etapas volta “pela metade”. A promessa era: restaura o ano corrente e a operação volta. Só que vendas de 2026 sem a tabela de clientes não servem pra nada. A primeira etapa do restore precisa trazer tudo de que a aplicação precisa pra funcionar hoje e isso inclui as tabelas de apoio.
Por isso o script já cria o FG_DADOS e o marca como DEFAULT. Tudo que não for particionado cai nele, fora do PRIMARY, e ele entra junto na primeira etapa do restore:
1ª etapa (a operação volta):
PRIMARY + FG_DADOS + FG_2026
Depois, com calma: FG_2025, FG_2024, FG_HIST
A mesma lógica vale pra um índice não alinhado (aquele da saída de emergência lá em cima): ele não segue o esquema de partição, então mora inteiro num filegroup só e precisa estar num que volte na primeira etapa.
Esse assunto desenhar os filegroups do banco inteiro, não só da tabela particionada dá um post só pra ele. E vai ganhar um: fica como bônus desta série.
E o PostgreSQL?
O paralelo mais próximo são os tablespaces: dá pra colocar cada partição num disco diferente, igualzinho.
CREATE TABLESPACE ts_frio LOCATION '/mnt/storage_barato/pg';CREATE TABLE vendas_2025_12 PARTITION OF vendas FOR VALUES FROM ('2025-12-01') TO ('2026-01-01') TABLESPACE ts_frio;
Mas a analogia para aí. Não existe tablespace somente leitura tentei, e a resposta foi direta: ERROR: unrecognized parameter "read_only". E o backup físico do PostgreSQL trabalha com o cluster inteiro, não existe backup nem restore por tablespace.
Então, no PostgreSQL, separar partições em discos resolve custo de storage e distribuição de I/O. No SQL Server, os filegroups resolvem isso e a estratégia de backup, restore e integridade. Aqui o modelo “tabela disfarçada” leva uma vantagem clara e é um bom exemplo de como a escolha de arquitetura se espalha pra muito além da query.
A regra que morde nos dois (pelo mesmo motivo)
Aqui está a pegadinha que derruba quem está migrando um design de um banco pro outro. Tentei criar uma chave primária só no id:
ALTER TABLE vendas ADD CONSTRAINT pk_vendas PRIMARY KEY (id);
E o PostgreSQL 18 respondeu:
ERROR: unique constraint on partitioned table must include all

partitioning columns

DETAIL: PRIMARY KEY constraint on table "vendas" lacks column

"data_venda" which is part of the partition key.
O SQL Server tem a mesma exigência, com outras palavras: em um índice clustered único, a coluna de particionamento precisa ser adicionada explicitamente à chave; num nonclustered único, a chave do índice precisa conter a coluna de particionamento.
E o motivo é o mesmo nos dois, o que ajuda a memorizar cada partição tem o seu próprio índice, e um índice só consegue garantir unicidade dentro do pedaço que ele enxerga. Se a garantia de unicidade não estiver embutida na própria estrutura de partições, nada impede o mesmo id de existir em janeiro e em fevereiro.
A correção é essa:
ALTER TABLE vendas ADD CONSTRAINT pk_vendas PRIMARY KEY (id, data_venda);
Simples de escrever e desconfortável de aceitar, porque significa que a sua PK “natural” deixou de ser natural. Toda foreign key que apontava pra essa tabela precisa carregar a data junto. Esse é o custo de projeto que raramente aparece nos tutoriais.
Onde o SQL Server te dá uma saída (e o Postgres não)
Existe uma diferença real de flexibilidade aqui, e ela é o argumento mais forte a favor do modelo do SQL Server.
Se você precisa de unicidade só no id, o SQL Server permite criar um índice não alinhado (nonaligned): um índice que não segue o esquema de particionamento da tabela. A unicidade global é preservada.
O PostgreSQL não tem equivalente. Não existe índice global; um índice declarado no pai é sempre “virtual”, materializado como um índice físico em cada partição. Se você precisa de unicidade global fora da chave de partição, a resposta é: não dá. Você resolve na aplicação, ou repensa o design.
Antes de comemorar a saída do SQL Server, o aviso: o índice não alinhado quebra o benefício operacional que motivou o particionamento. Sem alinhamento entre tabela e índices, o SWITCH de partição a operação quase instantânea de arquivar dados deixa de ser viável. É exatamente sobre isso o post 4. Guarde essa informação: você trocou agilidade operacional por uma constraint.
O preço escondido do modelo do Postgres
Agora o outro lado. Se cada partição é uma tabela de verdade, cada partição tem os próprios índices e tudo isso vira objeto no catálogo.
Fiz a conta com um cenário realista: 5 anos de dados particionados por mês (60 partições), chave primária composta e um único índice secundário.
CREATE INDEX ix_vendas_cliente ON vendas (cliente_id);
Resultado real:
particoes
indices_fisicos
total_objetos_catalogo
60
120
184
Um CREATE INDEX na tabela pai virou 60 índices físicos. Some a PK e são 120. Com a tabela pai, as partições e os índices “guarda-chuva”, 184 objetos no catálogo para o que o desenvolvedor enxerga como uma tabela.
Isso não é um bug, é o design. Mas tem consequência prática, e a documentação do PostgreSQL é honesta sobre ela: o planner lida bem com até alguns milhares de partições desde que consiga descartar quase todas; o tempo de planejamento e o consumo de memória crescem conforme sobram partições depois do pruning. Pior: cada sessão que toca essas partições carrega os metadados delas na memória local com muitas sessões e muitas partições, isso acumula no servidor.
A recomendação da própria documentação vale como regra de bolso: nunca assuma que mais partições é melhor que menos, nem o contrário.
No SQL Server, o mesmo cenário são 2 índices e 1 tabela. O limite lá é outro: 15.000 partições por tabela com o aviso da Microsoft de que passar de centenas de partições exige testar o impacto de performance antes.
Um detalhe do PostgreSQL 18
O autovacuum não processa a tabela particionada em si ele trabalha nas partições, uma a uma. Só que as estatísticas do nível do pai, usadas em alguns planos, não são atualizadas por esse caminho.
O PostgreSQL 18 trouxe a sintaxe que resolve isso de forma cirúrgica:
ANALYZE ONLY vendas; -- só a tabela particionada, sem varrer as filhasVACUUM ONLY vendas;
Em versões anteriores, o ONLY não existe (ERROR: syntax error at or near "ONLY") e um ANALYZE vendas percorria todas as partições caro numa tabela grande. Se você está subindo pro 18, essa é uma daquelas mudanças pequenas que melhoram a rotina de manutenção.
Resumindo a diferença
SQL Server 2025
PostgreSQL 18
O que é uma partição
Metadado de uma tabela única
Uma tabela real no catálogo
Índices
Um índice, particionado junto
Um índice físico por partição
Índice global (fora da chave)
Sim índice não alinhado
Não existe
PK/UNIQUE
Precisa conter a coluna de partição
Precisa conter a coluna de partição
Custo de escala
15.000 partições (com ressalvas)
Catálogo e memória por sessão
Partição em outro disco
Filegroup com somente leitura, backup e restore por filegroup
Tablespace só localização física
A frase que resume: o SQL Server esconde a complexidade e cobra em rigidez; o PostgreSQL expõe a complexidade e cobra em quantidade de objetos.
Nenhum dos dois está errado. São escolhas diferentes sobre onde colocar o custo e saber onde ele foi colocado é o que evita a surpresa em produção.
O que vem a seguir
Já sabemos como cada banco monta a estrutura. A pergunta seguinte é a que todo mundo realmente quer responder: quando o banco consegue ignorar partições inteiras numa query e por que às vezes ele simplesmente não consegue, mesmo com o filtro certo na cláusula WHERE?
É o post 3: “Partition pruning: o otimizador decidindo o que ignorar”.
Fontes técnicas usadas
PostgreSQL 18 – Documentação, 5.12. Table Partitioning (regra de unique/PK, índices “virtuais”, limites de planner e memória)
Microsoft Learn – ALTER DATABASE File and Filegroup Options (READ_ONLY exige acesso exclusivo; PRIMARY não pode ser read-only)
Microsoft Learn – Partial Backups e Piecemeal Restores (READ_WRITE_FILEGROUPS; restore online só no Enterprise)
Microsoft Learn – CREATE PARTITION SCHEME / ALTER PARTITION FUNCTION (N+1 filegroups, NEXT USED, custo de split em partição com dados)
Microsoft Learn – Partitioned Tables and Indexes (limite de 15.000 partições, índices alinhados x não alinhados, exigência da coluna de particionamento em índices únicos)
MTAC, Local Group Leader SQL SERVER - ES e palestrante em diversos eventos de plataforma de dados no Brasil. Atualmente trabalha como consultor SQL Server na Fabrício Lima Soluções em Banco de Dados, atendendo clientes de todo o Brasil. Trabalha com SQL Server desde de 2009.









 Alex Hinckel
 John Calistro
 Airton Lira Junior
 Luiz Fernando Duarte Junior