Preços da API Claude: por que cache e tokenizer pesam mais que o modelo escolhido na margem
A documentação oficial de preços da API Claude, com Haiku 4.5, Sonnet 5.5, Opus 5.5 e Fable 5.1, revela que cache, tokenizer e modo rápido pesam na margem tanto quanto a escolha do modelo.
O que a tabela de preços diz, em números
A documentação oficial de preços da API Claude lista hoje quatro famílias de modelos de produção com uma hierarquia de preço bem definida: Claude Haiku 4.5, Claude Sonnet 5.5, Claude Opus 5.5 e Claude Fable 5.1. A diferença entre a ponta mais barata e a mais cara é de 10 vezes, tanto em tokens de entrada quanto de saída.
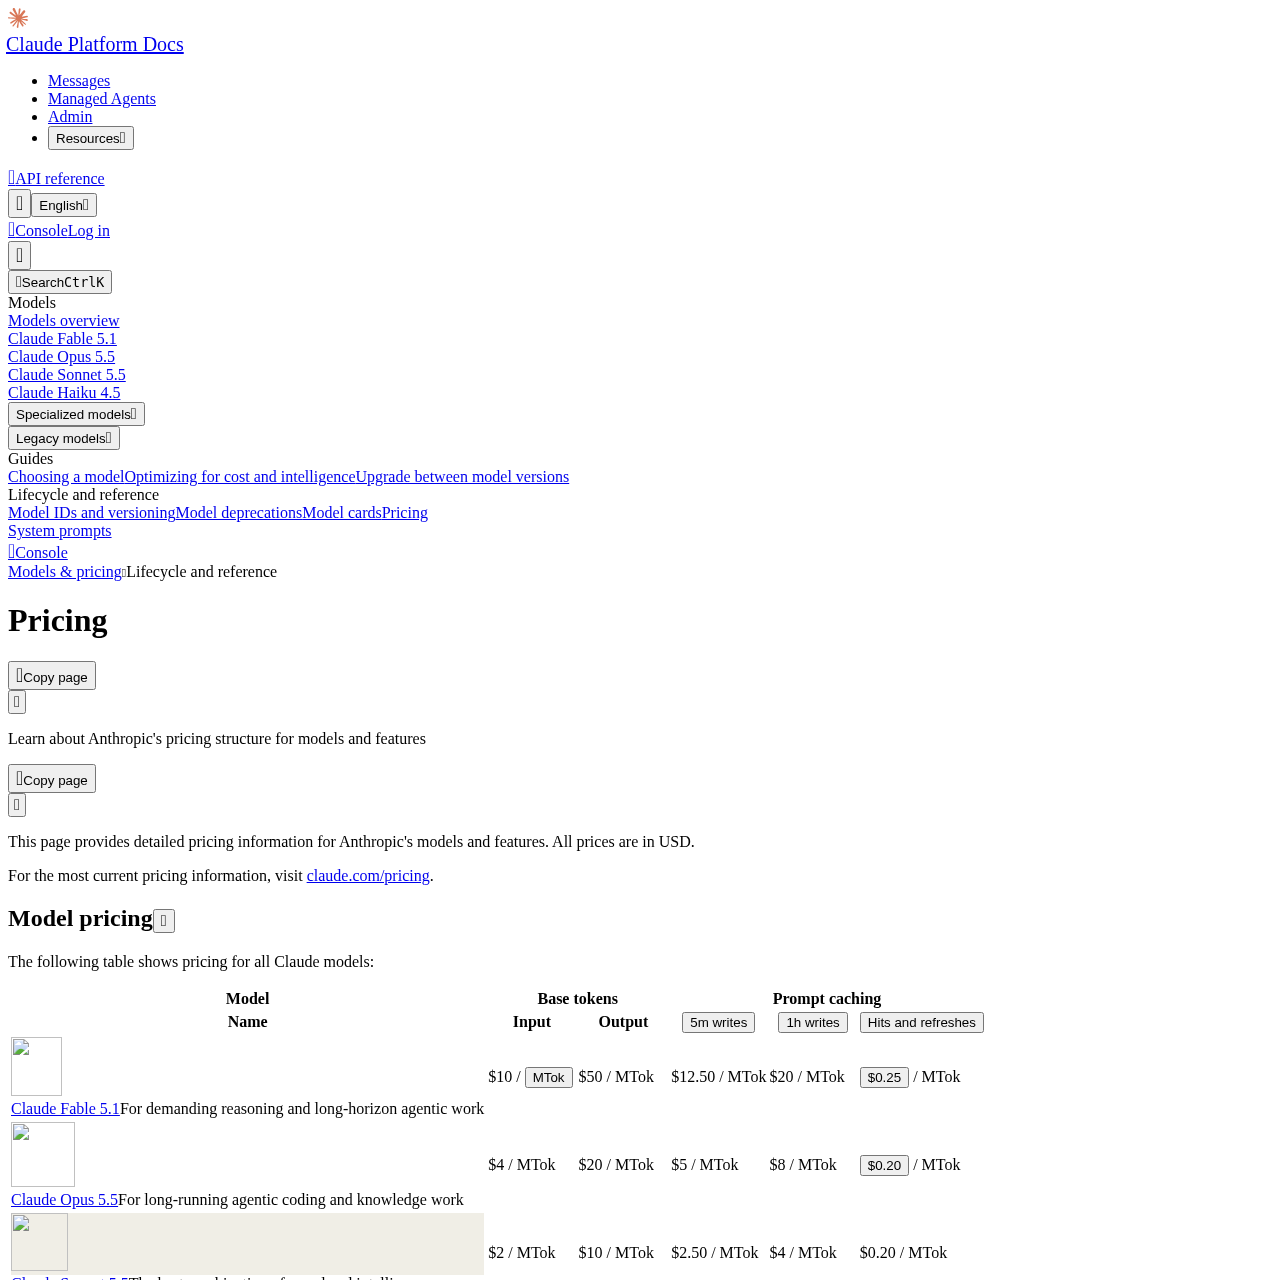
| Modelo | Input | Output | Cache hit | Perfil de uso |
|---|---|---|---|---|
| Claude Haiku 4.5 | $1/MTok | $5/MTok | $0,10/MTok | Volume alto, tarefas simples |
| Claude Sonnet 5.5 | $2/MTok | $10/MTok | $0,20/MTok | Produção geral, equilíbrio custo/qualidade |
| Claude Opus 5.5 | $4/MTok | $20/MTok | $0,20/MTok | Codificação agentic, tarefas longas |
| Claude Fable 5.1 | $10/MTok | $50/MTok | $0,25/MTok | Raciocínio de ponta, horizonte longo |
À primeira vista, essa tabela é um convite óbvio ao multi-model routing: por que pagar $10 por milhão de tokens de entrada no Fable 5.1 se o Haiku 4.5 resolve a mesma tarefa por $1? Mas a conta completa, com prompt caching, Batch API e fast mode, mostra que o preço de tabela nominal é só a casca da decisão de margem.
O cache estreita a distância entre o modelo caro e o barato
A Anthropic cobra diferente por escrita e leitura de cache: um write de 5 minutos custa 1,25x o preço base de input, um write de 1 hora custa 2x, e um hit (leitura) custa uma fração do input padrão. Até aqui, nada surpreendente. O detalhe está no multiplicador do hit: 0,1x para a maioria dos modelos, mas 0,05x para o Opus 5.5 e 0,025x para o Fable 5.1.
Fazendo a conta em dólares absolutos por milhão de tokens em cache hit, o resultado é quase plano entre os quatro modelos: $0,10 no Haiku 4.5, $0,20 no Sonnet 5.5, $0,20 no Opus 5.5 e $0,25 no Fable 5.1. Ou seja, o spread de 10x do preço nominal de input cai para 2,5x quando o conteúdo já está em cache.
Em resumo: para um produto com contexto majoritariamente estático (system prompt longo, base de documentos reaproveitada, histórico de conversa com cache automático), rodar no Fable 5.1 custa pouco mais do que rodar no Haiku 4.5, porque a maior parte dos tokens é lida do cache, não processada do zero. Isso muda a lógica de multi-model routing: a pergunta deixa de ser
Este artigo foi escrito por Eduardo Nogueira, colunista de negócios e estratégia tech. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
OpenAI abre o Apps SDK para apps no ChatGPT, mas ainda não define como o desenvolvedor vai ganhar dinheiro
Desde outubro de 2025 a OpenAI deixa qualquer desenvolvedor construir um app nativo dentro do ChatGPT via Apps SDK. Para quem decide onde investir o próximo ciclo de produto, o pulo do gato não é a distribuição prometida: é o que ainda falta combinar sobre monetização.