Microsoft e Nvidia apresentam laptop de IA em momento de memória cara
Microsoft e Nvidia apresentaram nesta quarta, dia 7, um novo laptop voltado a recursos de inteligência artificial. O evento aconteceu às 14h.
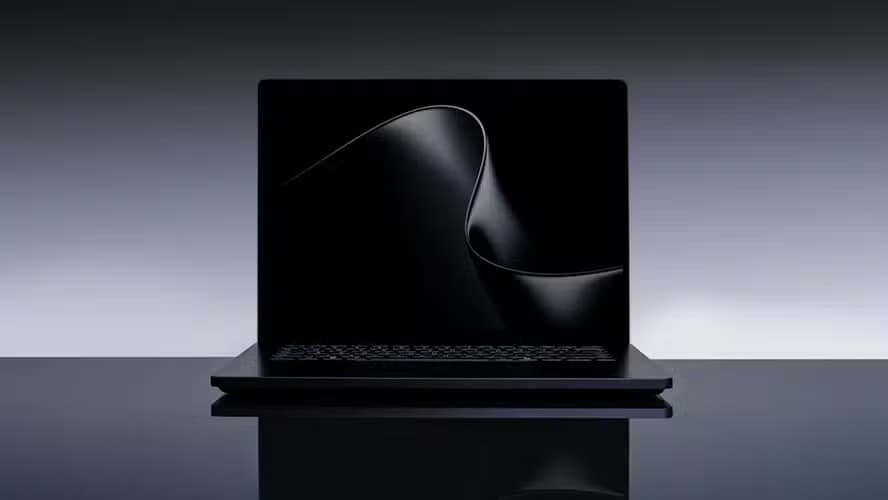
Microsoft e Nvidia apresentaram nesta quarta, dia 7, um novo laptop voltado a recursos de inteligência artificial↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI →. O evento aconteceu às 14h, no horário de Brasília. O aparelho vem equipado com chips da fabricante de GPUs.
O momento escolhido chama atenção. O anúncio chega enquanto serviços de IA agêntica ganham tração e os custos de memória disparam.
Por que esse lançamento importa para a Nvidia
Aqui está o ponto estratégico da notícia. O mercado de PCs figura entre os poucos segmentos intensivos em chips onde a empresa evita posição dominante.
Em data center, a história é outra. Lá, a companhia ocupa posição de liderança folgada.
No notebook, porém, o cenário muda. Intel, AMD e Qualcomm vêm disputando esse espaço com plataformas próprias.
Portanto, entrar nessa categoria representa abertura de frente nova. Além disso, o movimento aproveita a demanda crescente por processamento local de IA.
O contexto de preço que pesa sobre o produto
A alta no custo de memória merece atenção. Esse componente define boa parte do preço final de qualquer máquina voltada a IA.
O motivo é direto. Além disso, modelos locais precisam caber na memória para rodar sem troca constante com o armazenamento.
Consequentemente, aparelhos dessa categoria pedem configurações generosas. No entanto, esse requisito encarece o produto justamente no pior momento do ciclo de componentes.
Microsoft aposta no PC como peça da estratégia de IA
A lógica por trás disso acompanha um movimento mais amplo. Inferência local resolve três problemas conhecidos.
Primeiro, a privacidade. Além disso, o dado sensível permanece na máquina.
Segundo, a latência. Resposta sem ida e volta de rede melhora qualquer fluxo interativo.
Terceiro, o custo recorrente. Processamento local dispensa pagamento por token em cargas previsíveis.
Repare também no timing. A ascensão de agentes que operam o computador do usuário reforça a demanda por capacidade na própria máquina.
O que devs devem observar nesse tipo de aparelho
Primeiro, a quantidade de memória unificada. Esse número determina o tamanho máximo de modelo que roda sem gambiarra.
Segundo, a pilha de software. Suporte a CUDA, drivers maduros e bibliotecas prontas definem o tempo até o primeiro resultado.
Terceiro, o comportamento térmico. Notebook sustenta carga alta por menos tempo que desktop.
Além disso, verifique o consumo em bateria. Inferência local drena energia rápido.
Por fim, meça com o seu caso de uso. Benchmark sintético conta pouco quando o seu modelo quantizado roda de outro jeito.
O que acompanhar agora com a Microsoft e NVIDIA
Fique atento às especificações completas e ao preço anunciado. No entanto, esses dois dados definem quem consegue participar.
Acompanhe também os primeiros testes independentes de tokens por segundo. Enquanto isso, vale comparar o custo total com aluguel de GPU em nuvem para o mesmo volume de trabalho.
Acompanhe nosso perfil no Instagram!
Devs Android precisam se verificar no Brasil e conta chega às lojas
Devs que distribuem aplicativos Android no Brasil passaram a enfrentar verificação obrigatória. O Google confirmou a mudança nesta semana.
OpenAI liga a marca d’água na API e deixa a decisão com o dev
Gemini corta modelos do plano grátis e o AI Plus perde o Pro
OpenAI marca textos do ChatGPT e troca de sinônimos derruba detecção
 Redação iMasters
DGX Spark perde metade da memória e fica mais caro que o original
Redação iMastersDynatrace compra Arize porque serviço deixou de significar resposta certa
Redação iMastersAtlassian troca motor de métricas em 100 mil hosts sem tocar no código
Redação iMasters