Cloudflare Workers ganha padrão gateway e feature workers para evitar monólito na borda
Um relato técnico publicado no InfoQ descreve como dividir a lógica de edge em workers especializados ligados por service bindings, sem pagar hop de rede, para que um deploy não vire incidente para todos os tenants.

O monólito que nasce na borda
Todo projeto de edge computing começa do mesmo jeito: um Cloudflare Worker, um fetch handler, uma rota. Fácil de entender, fácil de implantar. O problema, segundo o relato de Chintan Tank publicado no InfoQ em 23 de setembro de 2026 (revisado por Renato Losio), é que esse worker não fica pequeno por muito tempo quando está na frente de um SaaS com centenas de milhares de contas de tenants. Ele vai acumulando responsabilidades: otimização de imagem, páginas de failover, roteamento, reescrita de headers e cookies, lookup de configuração por tenant. Cada uma dessas responsabilidades pertence, na prática, a um time diferente, mas todas moram no mesmo arquivo.
O efeito colateral, para quem constrói SaaS multi-tenant, é pior do que um monólito de aplicação comum. Um worker não é um serviço de backend↳Back-end49 conteúdosIntegração front-end com backend: 7 decisões que evitam caos entre APIs, BFF e GraphQLDev (Back & Front) · abr 2026Como criar uma FAKE API REST para testes — JSONPlaceholderDev (Back & Front) · set 2025Construindo um aplicativo de bate-papo de IA simples com Spring AI e AngularDev (Back & Front) · jul 2025Ver tudo em Dev (Back & Front) → com réplicas atrás de um load balancer: ele é o próprio caminho da requisição. Uma exceção não tratada, uma regex ruim ou um loop pesado numa feature não degrada só aquela feature, degrada todas as features e todos os tenants ao mesmo tempo. Deploy também vira problema: com um worker só existe um único deploy, então a correção de um header de uma linha espera atrás de um experimento pela metade, porque os dois saem juntos.
Gateway e feature workers: dividir sem pagar o preço da rede
A saída óbvia para um monólito é dividir, mas dividir historicamente custa uma chamada de rede a mais por serviço extraído (DNS, handshake TLS, round trip). Na borda, onde o objetivo é economizar milissegundos, esse custo costuma inviabilizar a divisão. No Cloudflare Workers isso não vale, por causa dos service bindings: uma chamada de worker para worker que o Cloudflare despacha na mesma isolate, na mesma máquina. A chamada tem a cara de um fetch() mas o custo de uma chamada de função local.
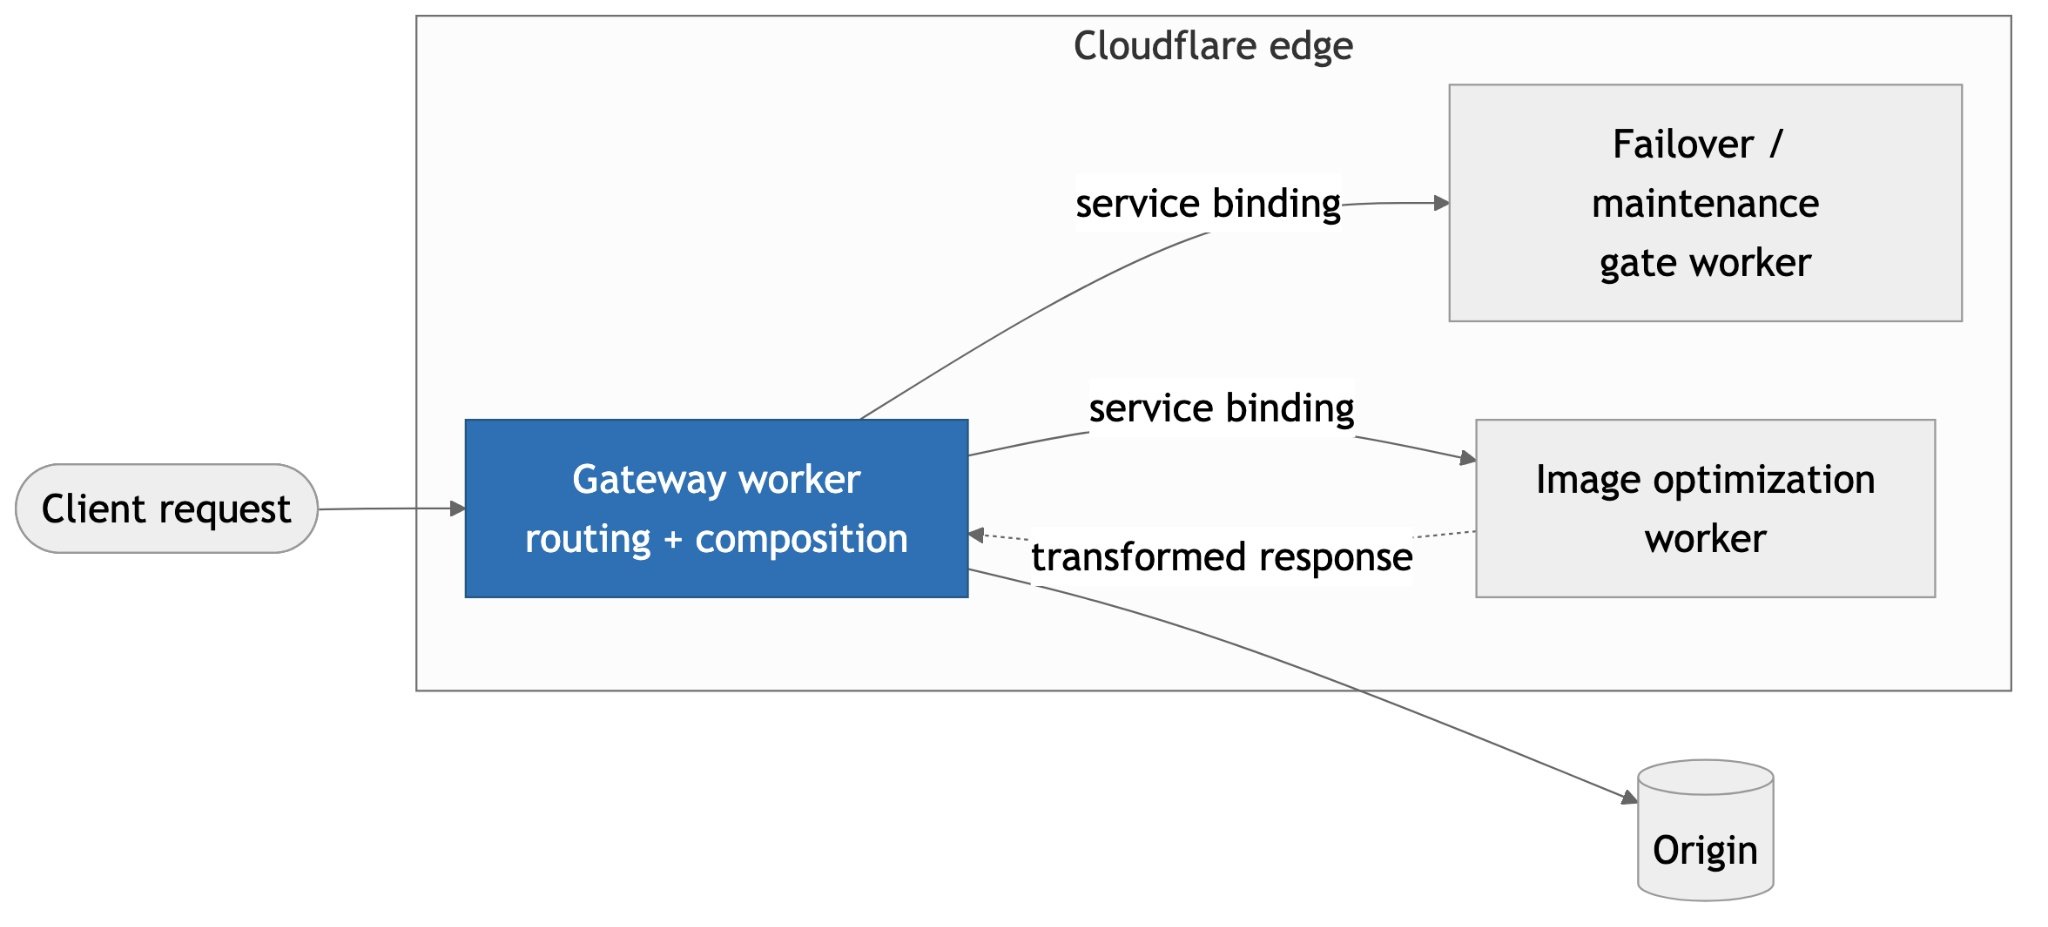
Essa propriedade é o que sustenta o padrão descrito no artigo: um gateway worker fino na frente de vários feature workers de propósito único. O gateway só faz duas coisas: decide quais features se aplicam à requisição (e em que ordem) e cuida de preocupações transversais como preparo de requisição, higiene de header e observabilidade↳Observabilidade11 conteúdosObservabilidade para APIs: os desafios e benefícios dessa abordagemDev (Back & Front) · jan 2025Falhas em Observabilidade afetam os Apps e a Segurança das OrganizaçõesDev (Back & Front) · nov 2023ADK Java 1.0: O Google quer que você pare de gambiarra Python no seu backendMarketing Tech · abr 2026Ver tudo em DevSecOps →. Ele nunca conhece o miolo de cada feature. O contrato é dividido em duas partes: um predicado barato do tipo shouldApply(), que o gateway roda inline sem custo de rede, e o worker em si, despachado via service binding só quando o predicado diz que o trabalho é necessário. No código:
export default {
  async fetch(request: Request, env: Env, ctx: ExecutionContext): Promise<Response> {
    if ((await shouldServeFailover(request, env)).serve) return env.FAILOVER.fetch(request);
    const originRequest = prepareOriginRequest(request, env);
    const response = (await shouldOptimize(originRequest, env)).optimize
      ? await env.IMAGE_OPTIMIZER.fetch(originRequest)
      : await fetchFromOriginOrCache(originRequest, ctx);
    return shouldServeFailoverForResponse(request, response).serve
      ? env.FAILOVER.fetch(request)
      : sanitize(response);
  },
};
Cada feature worker carrega suas próprias dependências e seu próprio orçamento de CPU, sem inflar o bundle do gateway, o que importa porque Workers rodam sob teto fixo de CPU por requisição e tamanho de script. E se uma feature falhar ou der timeout, o gateway serve a resposta original da origem em vez de uma página de erro: a resiliência mora nas duas camadas, e nenhuma delas derruba a requisição inteira sozinha.
O preço da independência: monorepo e rastreamento fragmentado
Separar workers não é de graça, o preço é coordenação. O time descrito no artigo colocou gateway e todos os feature workers num único monorepo, com fronteiras de pacote garantindo que cada worker continue sendo um alvo de build e deploy independente, e a fachada externa de cada feature sendo a única superfície que o gateway pode importar. É o meio-termo entre o isolamento de serviços separados e a coerência de um único código-fonte: sem isso, o contrato compartilhado deriva e um ajuste na interface do gateway vira migração multi-repositório.
A divisão também estilhaça a observabilidade. Um worker monolítico vê a requisição inteira; uma cadeia de workers separados por service binding, cada um vê só a própria fatia. O relato descreve o uso de um header especial que carrega diagnóstico na própria resposta para acompanhar uma requisição em voo sem depender de logging centralizado, mas ele funciona no gateway e não atravessa o binding: diagnóstico gerado dentro do feature worker de imagem, por exemplo, simplesmente não volta. Rastrear uma requisição ponta a ponta é trabalho que o monólito dava de graça e que a arquitetura modular exige reconstruir.
Cloudflare não é Akamai, e portar não é copiar
O artigo é enfático num ponto que interessa direto a quem decide stack: o padrão gateway e feature workers é uma arquitetura de Cloudflare, e não porta automaticamente para qualquer CDN com compute serverless. O autor implementou a mesma feature de otimização de imagem em Akamai e Cloudflare e documentou a diferença.
No Cloudflare, a unidade de computação é o worker: um único fetch handler que possui a requisição do início ao fim, pode chamar outros workers via binding, buscar a origem e reescrever a resposta. Na Akamai, a unidade de configuração é a property, um motor de regras que casa atributos da requisição e aplica comportamentos; o EdgeWorker é convidado dentro desse pipeline, invocado em eventos de ciclo de vida nomeados, sem possuir a requisição. Na prática, o EdgeWorker de opt-out da Akamai não chama o Image Manager (o produto gerenciado de otimização de imagem da Akamai) e não transforma nada: ele só escreve uma variável de decisão que uma regra da property lê depois.
// Akamai EdgeWorker: escreve decisão, não executa a transformação
export async function onClientRequest(request) {
  const key = deriveSiteKey(request);
  const optedOut = await lookupOptOut(request, key);
  request.setVariable("PMUSER_SKIP_TRANSFORM", optedOut ? "true" : "false");
}
A diferença desce até a camada de dados. Workers KV, o key-value store do Cloudflare, é global: uma escrita é legível em qualquer lugar. Já o EdgeKV da Akamai, no momento em que o time construiu essa versão, era provisionado por região, sem namespace único cobrindo tudo, o que obrigou o worker a mapear o continente de origem da requisição para uma store regional antes até de fazer a leitura. O artigo registra que a Akamai depois lançou um namespace global, o que mostra que paridade entre plataformas não é um estado que se alcança e mantém: ela se decompõe nos dois sentidos conforme o vendor evolui o produto.
Esse detalhe importa além da curiosidade técnica. Se o requisito de negócio for alcance global, uma store automaticamente global é a peça mais simples e o roteamento regional vira imposto. Mas inverta o requisito, uma regra de residência de dados que mantém dado de uma região dentro daquela região, e as peças trocam de lugar: o namespace por região da Akamai vira a funcionalidade, e o Workers KV global do Cloudflare passa a exigir buscar outro primitivo em vez de uma configuração pronta. Para quem constrói SaaS no Brasil sob exigências de LGPD↳LGPD14 conteúdosComo utilizar a LGPD com o objetivo de conformidade e inovação?Gestão Dev & TI · out 2021LGPD coloca pressão inédita nos responsáveis pela tecnologia das empresasData · ago 2021Proteção de dados: LGPD é sancionada e começa a valerData · set 2020Ver tudo em Gestão Dev & TI → que envolvam retenção ou localização de dado, essa é uma pergunta que a escolha de plataforma de edge não responde sozinha: precisa ser desenhada caso a caso.
Otimização de imagem como estudo de caso de build versus buy
O artigo usa otimização de imagem para ilustrar a decisão de construir versus comprar que toda feature de borda enfrenta. Na Akamai, a otimização é um serviço gerenciado (Image Manager): configura-se uma política e ela negocia cada requisição sem código. No Cloudflare, é um primitivo de nível mais baixo: o worker especifica a transformação por requisição. O Cloudflare tem um produto gerenciado equivalente, o Polish, mas ele opera pelo cache, casando URLs por extensão de arquivo e pulando qualquer coisa que não seja publicamente cacheável, o que não serviu para um tráfego de imagem que não é uniformemente extensionado nem uniformemente público.
A escolha por código em vez de toggle gerou três decisões que o worker aplica em ordem: primeiro, segurança (nunca otimizar uma imagem que carregue qualquer sinal de autenticação, porque otimizar significa cachear numa borda compartilhada, e uma imagem privada cacheada por URL vaza para a próxima requisição sem passar pela origem que checaria autorização); segundo, negociação de formato pelo header Accept (o artigo cita benchmarks independentes que colocam o AVIF com cerca de metade do tamanho de um JPEG equivalente e o WebP cerca de um terço menor, mas servir AVIF para um cliente que não decodifica é pior que não otimizar); terceiro, dimensionamento por classe de dispositivo lido a partir de sinais da requisição.
O que muda para quem constrói SaaS no Brasil
Para times brasileiros que já usam Cloudflare Workers em produção, ou avaliam migrar lógica de borda para lá, o recorte prático do artigo é este: o padrão gateway mais feature workers só compensa a partir de uma escala onde um worker único virou gargalo de deploy e de blast radius, não antes. Empresas pequenas ou single-tenant não sentem essa dor e podem manter um worker simples sem problema. A conversa muda quando o produto passa a atender múltiplos tenants isolados com times de feature diferentes disputando o mesmo arquivo.
Dois pontos merecem atenção de quem for replicar isso. Primeiro, service bindings são a peça que faz a divisão valer a pena sem hop de rede: sem esse recurso específico do Cloudflare, o mesmo desenho em outra plataforma de edge pode custar latência real, e o artigo mostra isso ao comparar direto com Akamai, onde não existe equivalente de binding entre EdgeWorker e o Image Manager. Segundo, testar código de borda pede a mesma disciplina de aplicação convencional: suíte de unidade por feature worker, teste de integração no gateway, monitoramento sintético em produção, porque sem isso a independência de deploy que a arquitetura promete vira independência de quebrar o vizinho sem aviso.
Fica em aberto, no próprio relato, o custo de observabilidade: a arquitetura modular resolve deployment e blast radius, mas fragmenta o rastreamento de uma requisição que atravessa múltiplos workers, e o artigo não descreve uma solução definitiva para isso, só o paliativo do header de diagnóstico que não atravessa bindings.
Fonte: InfoQ
Este artigo foi escrito por Redação iMasters. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.

Google abre o código do AX, orquestrador de agentes de IA inspirado no Kubernetes
O AX trata agentes autônomos como atores com estado, não como microsserviços ou jobs em lote, e usa CRDs no estilo Kubernetes para suspender e retomar tarefas em menos de um segundo.