Black Forest Labs lança Flux 3 Image Klein, modelo de imagem open weights de 5,6B parâmetros
A Black Forest Labs liberou os pesos do Flux 3 Image Klein, modelo de geração e edição de imagem que roda em GPU de consumo com 8 GB de VRAM. Para quem paga API em dólar, a conta muda.

A Black Forest Labs (BFL) lançou o Flux 3 Image Klein, modelo de geração e edição de imagem com 5,6 bilhões de parâmetros disponibilizado como open weights. É o segundo lançamento aberto da família Flux 3, depois do Flux 3 Action, modelo de 7B voltado a controle de robôs. Segundo a BFL, mais lançamentos da família vêm por aí.
O Klein faz texto para imagem, edição de imagem e geração multi-referência com até 10 imagens de referência simultâneas. Ele herda recursos do modelo completo Flux 3 Image: geração nativa em 4K, edição pixel-perfect e bounding boxes que controlam onde um elemento é posicionado ou limitam a edição a uma área específica da imagem.
Um modelo menor que aprendeu com vídeo e áudio
O Flux 3 Image Klein foi treinado a partir do aprendizado compartilhado entre imagem, vídeo e áudio que sustenta toda a família Flux 3. Imagens contribuem com detalhe espacial, vídeo adiciona movimento e dinâmica física, e áudio fornece contexto de eventos e interações. Para a BFL, essa combinação ajuda o modelo a gerar imagens mais coerentes com o mundo real, mesmo sendo o menor modelo aberto da comparação que a empresa divulgou.
Os números que a BFL divulgou
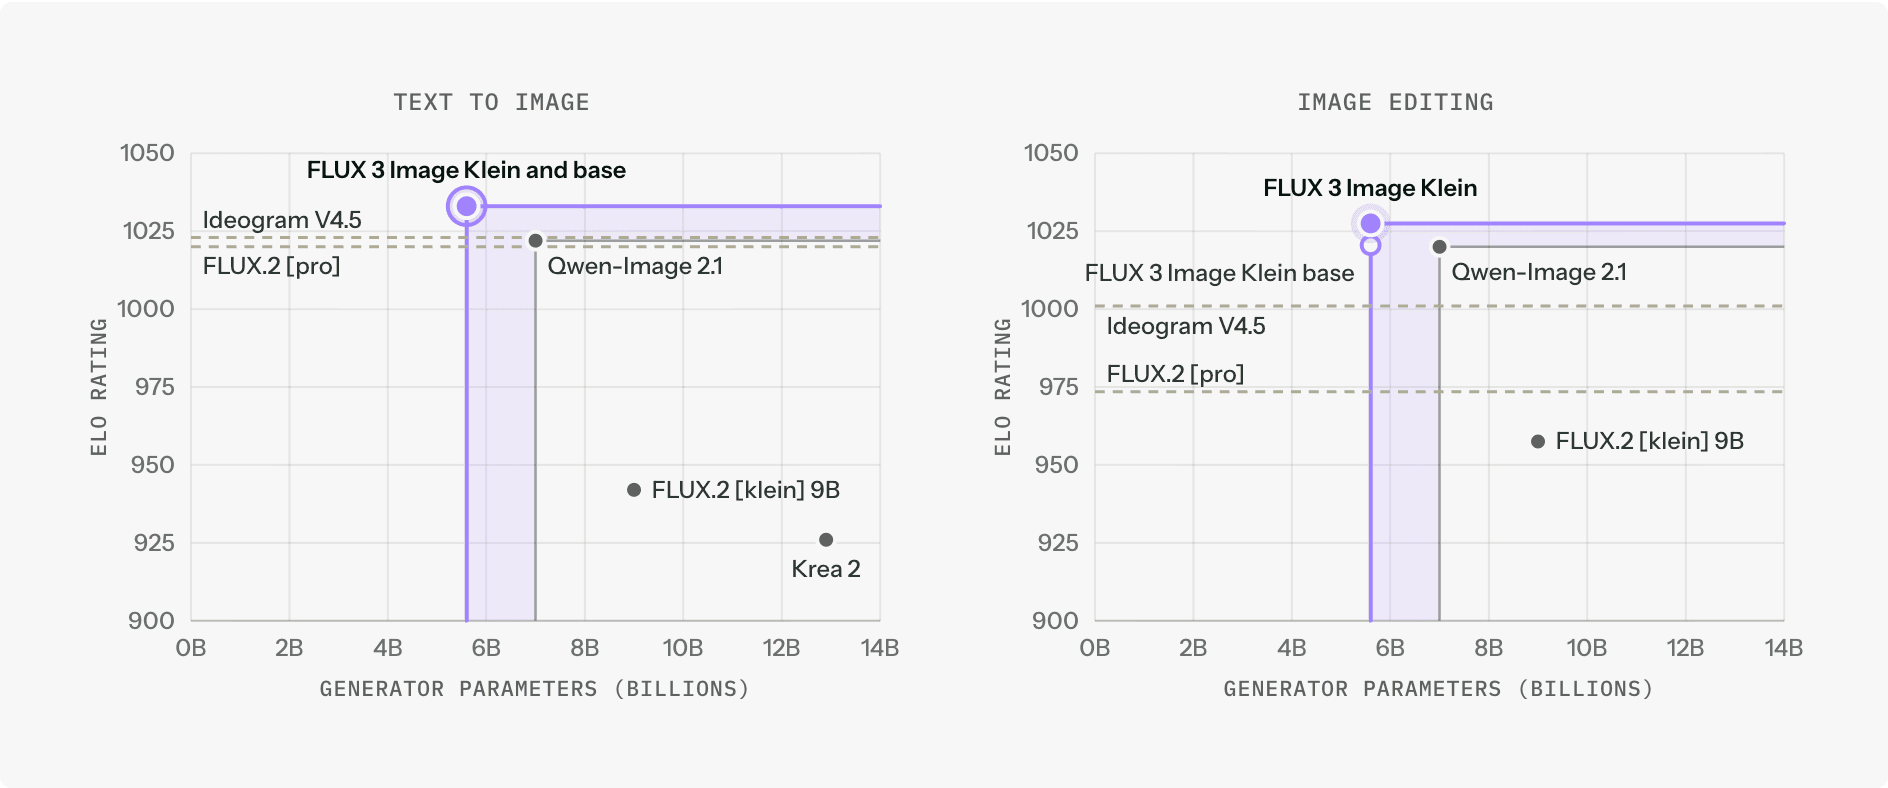
Em avaliações internas, a BFL afirma que o Flux 3 Image Klein fica em primeiro lugar em texto para imagem, geração multi-referência e edição de imagem, à frente de modelos abertos maiores e também de modelos fechados como Ideogram V4.5 e Flux.2 [pro]. Vale o contexto: são números medidos pela própria empresa, sem benchmark independente publicado até agora.
| Modelo | Parâmetros | Observação da BFL |
|---|---|---|
| Flux 3 Image Klein | 5,6B | 1º lugar nos testes internos |
| Flux.2 [klein] | 9B | antecessor; Klein ganha 91 Elo em texto-imagem e 70 em edição, com 38% menos parâmetros |
| Qwen-Image 2.1 | 7B | open weights, citado como referência |
| Krea 2 | 12,9B | open weights, o maior do grupo comparado |
Rodando em GPU de 8 GB
O ponto que mais importa pra quem programa é o requisito de hardware. Os pesos do gerador ocupam 11,2 GB em BF16 e 5,6 GB em FP8. Com a versão INT8, o modelo roda em GPUs GeForce RTX com apenas 8 GB de VRAM, via ComfyUI ou Hugging Face Diffusers, estendendo o que o Flux.2 [klein] já havia começado a fazer para hardware ainda mais modesto.
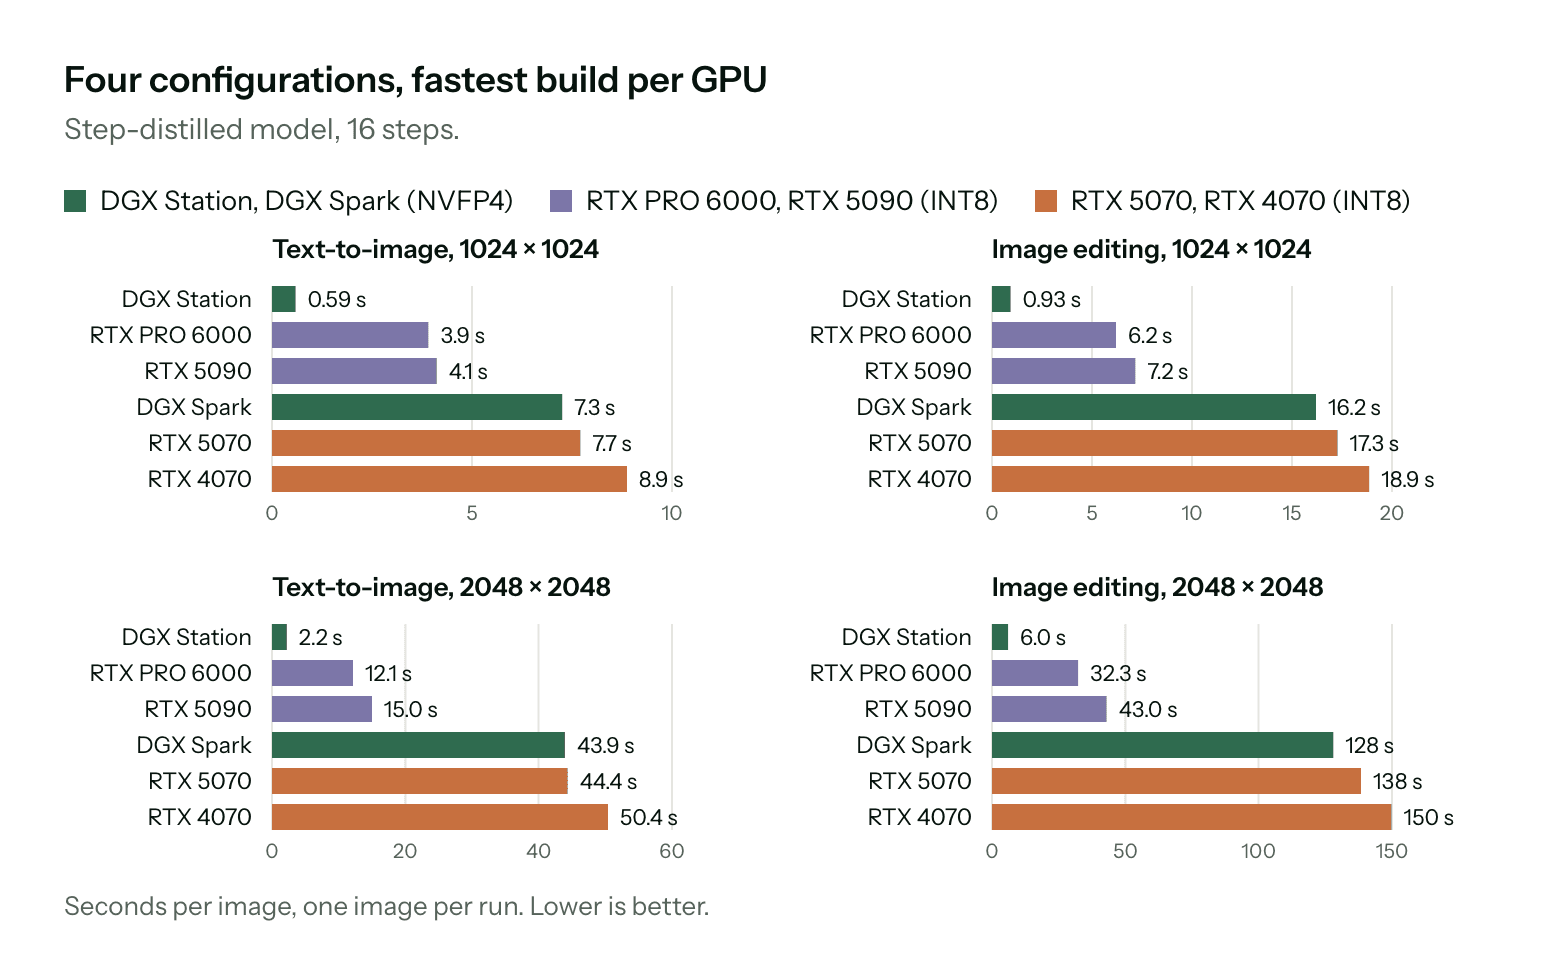
Em números de velocidade divulgados pela NVIDIA, o modelo distillado combinado com a build INT8 gera uma imagem de 1 MP em cerca de 4 segundos numa RTX 5090 e em menos de 9 segundos numa RTX 4070, ambos via ComfyUI, com 16 passos de inferência. No topo da escala, numa GPU NVIDIA GB300 e usando NVFP4, a mesma geração leva menos de 0,6 segundo; servir uma LoRA adiciona cerca de 5% ao tempo de geração.
API paga e preço em dólar
Além dos pesos abertos, a BFL também disponibiliza o modelo como serviço, identificado como flux-3-image-klein na API própria. A versão hospedada inclui prompt upsampling e pixel restoration, recurso que preserva exatamente as regiões não editadas de uma imagem durante uma edição. O preço começa em US$ 0,009 por imagem gerada em resolução 1K, cobrado em dólar, como de costume em APIs desse tipo.
O que muda pra quem desenvolve no Brasil
Aqui está o ângulo que separa este lançamento de só mais um modelo de imagem: a licença. O Flux Kommunity License permite uso comercial gratuito para indivíduos e empresas com faturamento anual abaixo de US$ 5 milhões, além de uso de pesquisa e não comercial sem restrição de porte. Organizações maiores precisam negociar licenciamento self-hosted ou usar a API paga da BFL.
Na prática, isso significa que a maioria das startups e squads de produto no Brasil se qualifica para baixar os pesos e rodar o modelo de graça, dentro da própria infraestrutura. Isso tem três efeitos concretos:
- Fim da cobrança por chamada de API em dólar, trocada pelo custo fixo de uma GPU (a partir de uma RTX com 8 GB de VRAM para a build INT8);
- Imagens de clientes processadas localmente, sem sair da empresa, o que facilita conversas sobre LGPD↳LGPD14 conteúdosComo utilizar a LGPD com o objetivo de conformidade e inovação?Gestão Dev & TI · out 2021LGPD coloca pressão inédita nos responsáveis pela tecnologia das empresasData · ago 2021Proteção de dados: LGPD é sancionada e começa a valerData · set 2020Ver tudo em Gestão Dev & TI → com times jurídico e de segurança;
- Possibilidade de fine-tuning com LoRA sobre o checkpoint base, treinando o modelo com o estilo visual da própria marca sem depender de um fornecedor externo.
Integração: o que já tem suporte
O checkpoint base foi pensado para fine-tuning: Diffusers e o AI↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI → Toolkit da Ostris suportam treino de LoRA desde o primeiro dia, e o NeMo AutoModel da NVIDIA traz receitas prontas que funcionam direto a partir dos checkpoints liberados. Há suporte dia-um em ComfyUI, Hugging Face Diffusers, TensorRT-LLM, SGLang Diffusion e vLLM-Omni, o que cobre tanto quem monta pipeline visual em interface gráfica quanto quem prefere servir o modelo via código.
Segurança, com números que a BFL não abre
A empresa diz implementar filtros no dataset de pré-treino para limitar exposição a conteúdo prejudicial, além de fine-tuning direcionado no pós-treino para suprimir comportamentos nocivos. Antes do lançamento, os checkpoints passaram por red team interno e avaliação do parceiro externo Cinder, que segundo a BFL encontrou "substancialmente menos vulnerabilidades" do que outros pesos abertos populares. A empresa não divulgou os números por trás dessa comparação nem o relatório completo da Cinder.
O que ainda fica em aberto
Todos os benchmarks de qualidade e velocidade vêm de avaliações feitas pela própria BFL ou por testes encomendados à NVIDIA; não há, até agora, comparação independente publicada. A empresa também não detalha a composição do dataset de treino. Para quem avalia trocar uma API paga por um pipeline local, o caminho razoável é testar o modelo com prompts do próprio produto antes de decidir pela migração, comparando qualidade e tempo de geração na GPU disponível contra o custo atual em dólar.
Fonte: Hacker News
Este artigo foi escrito por Redação iMasters. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Meta lança o Muse Spark, modelo open-weight de 816 bilhões de parâmetros para código e agentes
A gigante de tecnologia liberou os pesos do Muse Spark, um modelo com 816 bilhões de parâmetros voltado a programação e tarefas agênticas, que já pode ser baixado, adaptado e rodado localmente.