O Ollama já suporta chamada de função estruturada há algum tempo, mas a leva de modelos lançada entre 14 e 24 de outubro de 2026 tornou essa função muito mais usável para construir agentes locais de verdade.
Ollama reforça tool calling com novos modelos: como montar um agente 100% local
O Ollama já suporta chamada de função estruturada há algum tempo, mas a leva de modelos lançada entre 14 e 24 de outubro de 2026 tornou essa função muito mais usável para construir agentes locais de verdade.
Nota da redação: este artigo descreve o funcionamento do campo 'tools' e da resposta 'tool_calls' no endpoint /api/chat do Ollama com base em conhecimento geral sobre a ferramenta. A fonte usada na apuração (página de Releases do GitHub) não documenta esse comportamento específico da API, e não tivemos acesso à documentação oficial da API para confirmar os detalhes exatos. O restante dos fatos do artigo, incluindo datas de lançamento e especificações dos modelos, foi conferido nas release notes oficiais.
O Ollama já suporta chamada de função estruturada há algum tempo, mas a leva de modelos lançada entre 14 e 24 de outubro de 2026 tornou essa função muito mais usável para construir agentes locais de verdade.
Tool calling no Ollama não é exatamente novidade
A chamada de função estruturada não é novidade no Ollama: o endpoint /api/chat aceita um campo tools com o schema JSON das funções disponíveis, e o modelo responde com tool_calls quando decide acionar alguma delas. O que mudou nas últimas semanas, segundo as release notes do projeto no GitHub, não foi essa API em si, mas a quantidade de modelos lançados especificamente para usá-la bem.
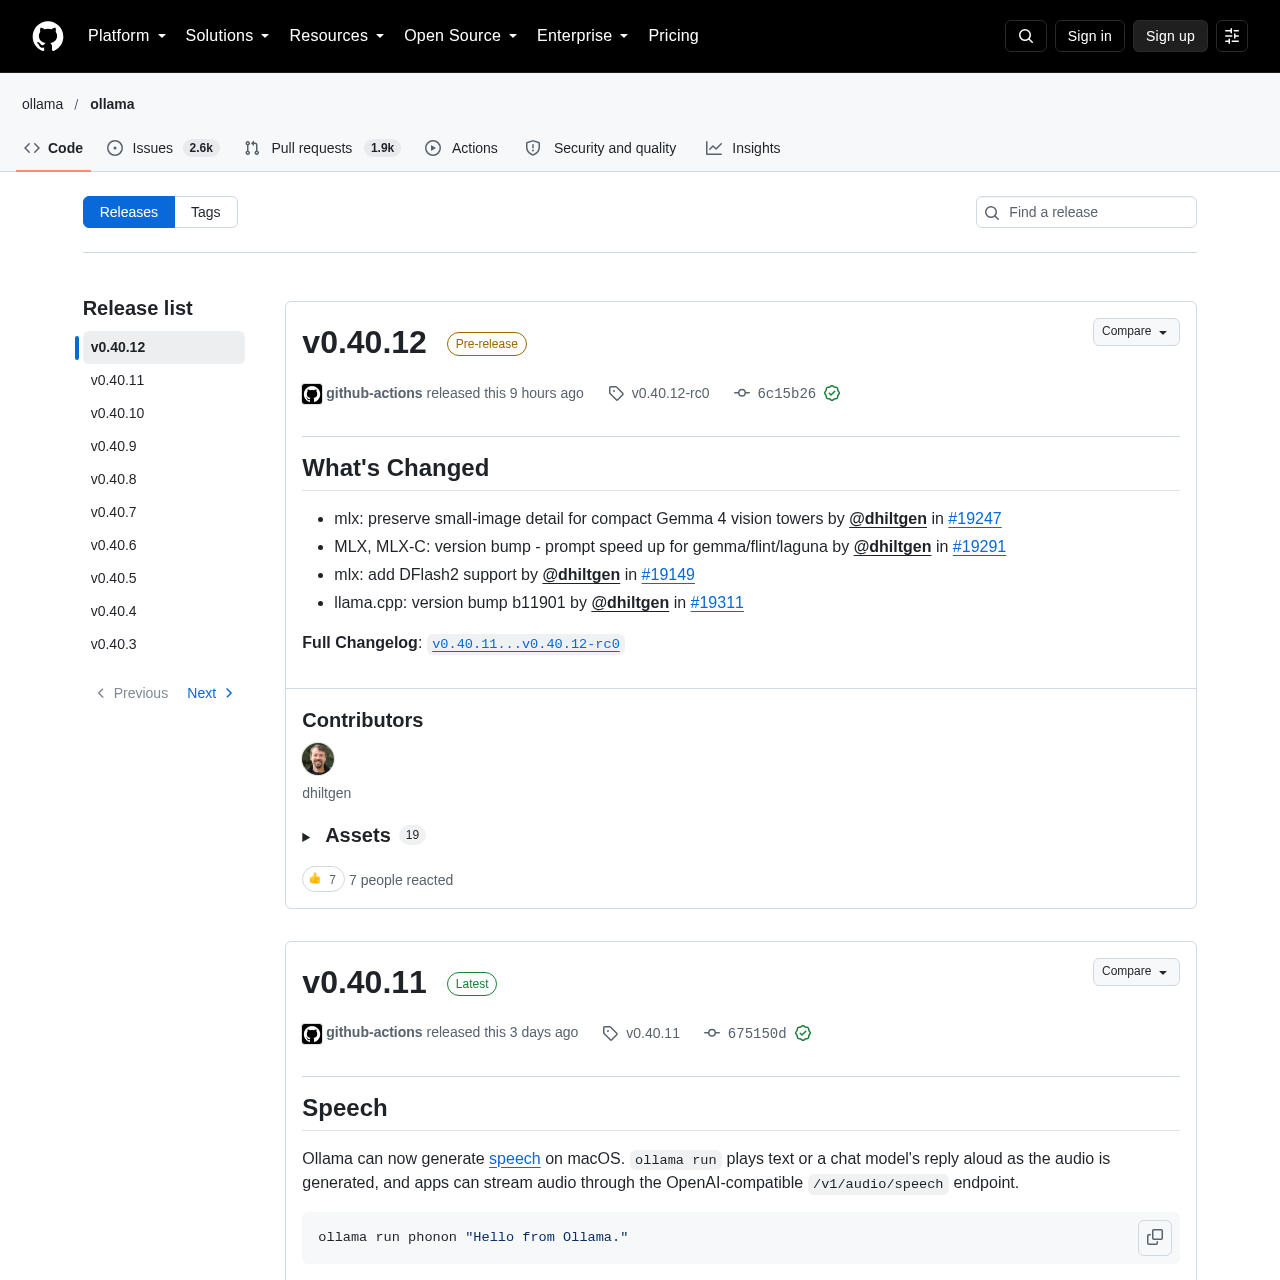
Entre 14 e 24 de outubro de 2026, o Ollama publicou quatro lançamentos relevantes para quem quer montar um agente: Nemotron 3.5 Super, Nemotron 3.5 Bolt, Nemotron 3.5 Bolt E4B e o Recursive Flint. Três deles citam tool calling ou tool use explicitamente na descrição oficial: só o Bolt, descrito como uma destilação do Super para tarefas agênticas do dia a dia, não usa esses termos na nota de lançamento, embora herde a mesma capacidade do modelo original. É esse pacote que dá sustentação real ao ângulo de 'agente local', não uma mudança na API.
Os modelos que chegaram para turbinar agentes locais
A NVIDIA lançou o Nemotron 3.5 Super em 14 de outubro (v0.40.5): um modelo de visão e linguagem com backbone híbrido Mamba-2/Transformer em mixture-of-experts, 120B parâmetros totais e 12B ativos por token, contexto de até 1M tokens e suporte a tool calling com modo de raciocínio liga/desliga. No mesmo lançamento veio o Nemotron 3.5 Bolt, uma versão destilada de 74B parâmetros (9B ativos) dimensionada para caber numa GPU NVIDIA de 24 GB, com decodificação especulativa via um drafter incluído.
Nove dias depois, em 23 de outubro (v0.40.10), chegou o Nemotron 3.5 Bolt E4B, um modelo menor baseado em Gemma 4, com janela de 128K tokens, voltado a conversas rápidas, leitura de imagem e tool use em hardware de consumo. E em 21 de outubro (v0.40.8) o Ollama trouxe o Recursive Flint: um modelo de 40B parâmetros em mixture-of-experts (cerca de 2,5B ativos por token), licenciado em Apache 2.0, desenhado para o trabalho que agentes de código fazem num repositório inteiro (entender código desconhecido, rastrear bugs, implementar features, escrever testes), com uso de ferramentas em múltiplos turnos e contexto de 262K tokens.
| Modelo | Parâmetros | Contexto | Hardware alvo | Tool calling |
|---|---|---|---|---|
| Nemotron 3.5 Super | 120B (12B ativos) | até 1M tokens | GPU de datacenter | Sim, com modo raciocínio |
| Nemotron 3.5 Bolt | 74B (9B ativos) | não informado | GPU de 24 GB | Sim (herdado do Super) |
| Nemotron 3.5 Bolt E4B | base Gemma 4 | 128K tokens | GPU de consumo | Sim |
| Recursive Flint | 40B MoE (~2,5B ativos) | 262K tokens | macOS, Linux↳Linux34 conteúdosKali Linux em um Servidor VPS: como, quando e por que usar?DevSecOps · dez 2024Construindo um Windows Service ou Linux Daemon com Worker Service & .NET Core – Parte 2Dev (Back & Front) · jul 2020Criando uma WebApi utilizando .NET, Linux e VSCodeDev (Back & Front) · ago 2019Ver tudo em DevSecOps → e Windows (desde v0.40.9, 22/10) | Multi-turno |
Vale notar que, segundo a própria Recursive, o Flint marcou 54,9% no Terminal-Bench 2.1 e 74,2% no SWE-bench Verified em suas avaliações de lançamento. São números autodeclarados pelo fabricante do modelo, publicados nas release notes do Ollama, não medições independentes.
Montando um agente simples com tool calling
O padrão de uso não muda entre esses modelos: você declara as ferramentas como JSON schema e deixa o modelo decidir quando chamar cada uma. Um agente mínimo com a biblioteca Python↳Python56 conteúdosVSCode + Python + Alexa: Desenvolva e teste skills para alexa localmente com pythonDev (Back & Front) · out 2025Dominando decoradores em Python: um guia completo com exemplosDev (Back & Front) · jan 2025Desenvolvimento de software: diferenças entre Python, JavaScript e JavaGestão Dev & TI · nov 2024Ver tudo em Dev (Back & Front) → ollama fica assim:
import ollama

def get_weather(city: str) -> str:
 return f"27 graus em {city}, com poucas nuvens"

tools = [{
 "type": "function",
 "function": {
 "name": "get_weather",
 "description": "Retorna a temperatura atual de uma cidade",
 "parameters": {
 "type": "object",
 "properties": {
 "city": {"type": "string", "description": "Nome da cidade"}
 },
 "required": ["city"]
 }
 }
}]

response = ollama.chat(
 model="nemotron-3.5-bolt:e4b",
 messages=[{"role": "user", "content": "Qual a temperatura em São Paulo agora?"}],
 tools=tools,
)

if response.message.tool_calls:
 for call in response.message.tool_calls:
 if call.function.name == "get_weather":
 print(get_weather(**call.function.arguments))
Esse roteiro é o que eu seguiria num teste rápido: modelo pequeno o bastante para rodar numa GPU de consumo, uma função só, resposta curta. Para um agente real, o loop precisa executar a função, devolver o resultado como mensagem de papel tool e mandar de volta ao modelo até ele parar de pedir ferramentas, o mesmo padrão usado em qualquer API compatível com function calling.
Decision models: um atalho para rotear sem gastar um LLM inteiro
Nem toda etapa de um agente precisa de um modelo generativo completo. O Ollama também vem empacotando os chamados decision models: modelos pequenos (de 2B a 27B parâmetros) treinados só para classificar, responder sim ou não, ou pontuar opções com probabilidade. A família d3, trazida do vLLM Semantic Router e publicada em 24 de outubro (v0.40.11), aceita texto, estado estruturado ou imagem como entrada.
O uso é direto no terminal, com a flag --ask:
ollama run d3 "A customer says their card was charged twice." --ask "Is this a billing issue?"O mesmo padrão existe desde 12 de outubro (v0.40.4) com outros decision models, como no exemplo ollama run nimble --ask "Is a refund being requested?" < ticket.txt. Num agente de verdade, esse tipo de modelo funciona como roteador: decide qual ferramenta ou qual sub-agente acionar antes de gastar uma chamada cara num modelo generativo de 40B ou 120B parâmetros.
Onde a latência e a precisão pesam contra o local
A conta de hardware é o primeiro limite. Rodar o Nemotron 3.5 Super (120B parâmetros, 12B ativos) exige GPU de datacenter; mesmo a versão Bolt, pensada para caber em 24 GB, deixa pouca margem para rodar outro processo pesado ao mesmo tempo. Contextos grandes, como o 1M de tokens do Super ou os 262K do Flint, custam prefill: quanto mais histórico de ferramentas o agente acumula, mais lenta fica cada resposta.
Na minha leitura, a segunda limitação é de confiabilidade na formatação da chamada. Modelos locais menores (o Bolt E4B, por exemplo) tendem a errar mais na extração de argumentos de uma função complexa do que um modelo de fronteira treinado especificamente para tool use em escala, como os que rodam atrás de APIs de nuvem. Isso não está medido nas release notes do Ollama, é inferência baseada no padrão conhecido de modelos menores versus modelos de fronteira; antes de confiar um agente em produção a isso, vale medir a taxa de chamadas malformadas no seu próprio caso de uso.
A comparação com nuvem também passa por rede: uma API de nuvem soma latência de ida e volta a cada chamada de ferramenta, mas não depende da GPU local nem da fila de carregamento de modelo. Local, a latência de rede desaparece, mas o tempo de inferência vira gargalo em hardware modesto, especialmente ao trocar entre modelo generativo e decision model várias vezes num mesmo fluxo.
Quando vale a pena ficar 100% local
Em resumo: local compensa quando o dado não pode sair da máquina (código proprietário, dados de cliente) e quando o agente faz poucos saltos de ferramenta por turno, caso em que um decision model mais um modelo de 9B a 40B ativos dá conta.
Não compensa quando o agente precisa orquestrar várias ferramentas em sequência com alta taxa de acerto, ou quando não há GPU disponível para sustentar um modelo de 24 GB ou mais rodando o tempo todo. O Recursive Flint, que passou a rodar também em Linux e Windows além de macOS a partir de 22 de outubro (v0.40.9), amplia quem pode testar o cenário de agente de código completo hoje.
A melhoria recente de interoperabilidade ajuda a migrar entre os dois mundos sem reescrever tudo: desde 22 de outubro (v0.40.9), o Ollama relata falhas corretamente em streaming via endpoints compatíveis com OpenAI Responses e Anthropic Messages, em vez de simplesmente encerrar a saída pela metade. Isso facilita testar o mesmo código de agente trocando só a baseURL, do Ollama local para uma API de nuvem e vice-versa.
Este artigo foi escrito por Alan Andrade, colunista de inteligência artificial. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Claude Opus 5.5 monta pipeline de imagem em tempo real no navegador, sem libs externas
Simon Willison usou um único prompt para o Claude Opus 5.5 gerar um artifact que pinta fotos com detecção de bordas de Sobel, rodando inteiro no navegador sem bibliotecas.