ADK e Gemini 3.8 Live mostram como evitar silêncio em agentes de voz
Um guia publicado pelo Google em 19 de outubro mostra como usar streaming tools e response_scheduling no ADK para que um agente de voz nunca pare de falar enquanto espera uma consulta lenta terminar.
O silêncio que derruba uma ligação
Em um chat de texto, uma consulta de 13 segundos vira um spinner de carregamento. Em uma sessão de voz ao vivo, os mesmos 13 segundos de execução bloqueante viram 13 segundos de silêncio total, e o usuário assume que a ligação caiu.
É o problema que Stephen Allen (solutions architect) e Kaz Sato (staff developer advocate), do Google, descrevem num guia publicado em 19 de outubro no Google Developers Blog. A saída que eles propõem não é deixar o backend↳Back-end49 conteúdosIntegração front-end com backend: 7 decisões que evitam caos entre APIs, BFF e GraphQLDev (Back & Front) · abr 2026Como criar uma FAKE API REST para testes — JSONPlaceholderDev (Back & Front) · set 2025Construindo um aplicativo de bate-papo de IA simples com Spring AI e AngularDev (Back & Front) · jul 2025Ver tudo em Dev (Back & Front) → mais rápido, até porque nem sempre dá: é arquitetural. O agente precisa continuar conversando enquanto a ferramenta lenta roda por trás.
O Agent Development Kit (ADK), open-source, e o gemini-3.8-live resolvem isso com ferramentas de voz não bloqueantes escritas em Python puro, sem exigir que você monte um loop de eventos de WebSocket na mão no cliente. No benchmark do próprio Google, com um workflow de relatório de vendas, trocar uma tool bloqueante por uma streaming tool cortou o tempo até a primeira palavra do agente de 14,4 segundos para 1,2 segundo.
Por que a ferramenta padrão trava a conversa
Em desenvolvimento de agentes, o padrão é definir uma tool como uma função async def que faz o trabalho e devolve um único valor no final:
from typing import Any

async def query_sales_database(region: str) -> dict[str, Any]:
 """Executa o relatório trimestral de vendas da região."""
 report = await run_expensive_query(region) # ex.: 13 segundos de trabalho
 return {"status": "success", "report": report} # retorno único no final
Quando essa função é passada direto para um Agent do ADK, ela vira uma tool bloqueante. Numa sessão bidirecional do Gemini Live (run_live), o loop de execução espera a tool devolver antes de gerar qualquer fala nova do modelo. Instrução de prompt do tipo "avise o usuário que está trabalhando nisso" não resolve nada aqui, porque o turno do modelo está travado esperando o payload da função.
Padrão 1: streaming tools, quando a espera tem uma história
Quando a operação tem etapas que fazem sentido narrar (conectar ao banco, agregar registros, formatar o resultado), o ADK deixa transformar uma tool comum em streaming trocando só return por yield. Ao declarar a função como AsyncGenerator, o ADK marca a declaração da tool como NON_BLOCKING automaticamente e devolve uma confirmação imediata ao modelo:
import asyncio
from typing import AsyncGenerator
from google.adk.agents import Agent

async def query_sales_database(region: str) -> AsyncGenerator[str, None]:
 """Executa o relatório trimestral. Chame UMA vez; as atualizações chegam sozinhas."""
 stages = [
 ("Conectando ao data warehouse de vendas...", 1.5),
 ("Varrendo os registros de pedidos...", 3.5),
 ("Agregando receita por linha de produto...", 3.5),
 ("Formatando o relatório...", 1.5),
 ]
 for message, delay in stages:
 yield f"PROGRESS: {message}"
 await asyncio.sleep(delay)

 yield f"DONE: receita de {region} no Q2 chegou a US$ 4,81M, alta de 12,4% no ano."

agent = Agent(
 name="sales_analyst",
 model="gemini-3.8-live",
 tools=[query_sales_database],
 instruction=(
 "Você é um assistente de vendas. Ao receber uma pergunta sobre vendas, "
 "chame query_sales_database uma única vez. Confirme o pedido de imediato, "
 "parafraseie cada atualização de progresso e apresente os números finais "
 "quando completarem. Mantenha as respostas conversacionais e concisas."
 ),
)
Na prática, isso entrega três coisas ao mesmo tempo: o agente fala ("Já estou olhando os números da EMEA...") assim que a tool dispara; cada yield chega como uma resposta parcial, que o modelo parafraseia conforme vai recebendo, mesmo que a narração fique alguns segundos atrás da execução real; e se o usuário perguntar algo fora do assunto nesse meio-tempo, o agente responde sem cancelar nem interromper a tarefa em segundo plano.
O que observar em produção
- Chamada única garantida: como a tool empurra atualizações em vários turnos, o modelo pode tentar chamá-la de novo se o usuário insistir. O guia recomenda manter a instrução "chame UMA vez" explícita no docstring e considerar um latch em memória ou uma chave de idempotência na implementação.
- Cancelamento com
stop_streaming: incluir uma função chamadastop_streaming(function_name: str)na lista de tools do agente faz o ADK interceptar a chamada, cancelar aasyncio.Taskpor trás do generator e levantarasyncio.CancelledErrordentro da sua função, para fechar conexões ou arquivos com segurança. - Barge-in não cancela a tool: quando o usuário fala por cima do agente, a Live API para a saída do modelo e o ADK emite um evento com
interrupted=Truepara o cliente parar o áudio, mas a tool em execução continua e o resultado ainda será entregue. Só uma chamada explícita astop_streamingencerra o processamento.
Padrão 2: execução em segundo plano, quando esperar é só esperar
Nem toda espera merece narração. Se o usuário pede um relatório e já muda de assunto, um agente que fica interrompendo com atualizações de status soa intrusivo em vez de útil. Quando a espera não tem história para contar, o jeito é rodar a tarefa quieta e entregar quando ela terminar.
A forma mais rápida de montar isso é um async generator que faz um único yield, só na conclusão:
async def query_sales_database(region: str) -> AsyncGenerator[dict, None]:
 """Executa o relatório trimestral. Chame UMA vez; o resultado chega quando pronto."""
 report = await run_expensive_query(region) # execução em segundo plano (~13s)
 yield report # único yield, na conclusão
Por ser um async generator, o ADK emite uma confirmação pendente imediata: o agente diz algo como "estou preparando esse relatório para você", fica em silêncio durante o processamento e apresenta os números assim que ficam prontos ou quando o usuário termina de falar.
Quem prefere manter coroutines tradicionais (async def ... -> dict) pode envolver a função num FunctionTool e configurar o agendamento de resposta:
from google.adk.tools import FunctionTool
from google.genai import types

sales_tool = FunctionTool(query_sales_database)
sales_tool.response_scheduling = types.FunctionResponseScheduling.WHEN_IDLE
# Em ADK 2.10+, também dá para usar:
# sales_tool.behavior = types.Behavior.NON_BLOCKING
A diferença entre as duas abordagens é um trade-off direto: com response_scheduling sobre uma coroutine de retorno único, o modelo não recebe nada até a função inteira terminar, então normalmente não há confirmação verbal inicial a menos que o usuário continue falando. Esse padrão serve melhor quando o usuário já emendou outra pergunta e você quer que o resultado entre na conversa na próxima pausa natural.
Controlando a entrega com response_scheduling
O atributo response_scheduling decide quando o modelo reage a uma resposta de tool que chegou. O ADK suporta três modos, e nos testes de bancada do Google com o gemini-3.8-live eles se comportaram assim:
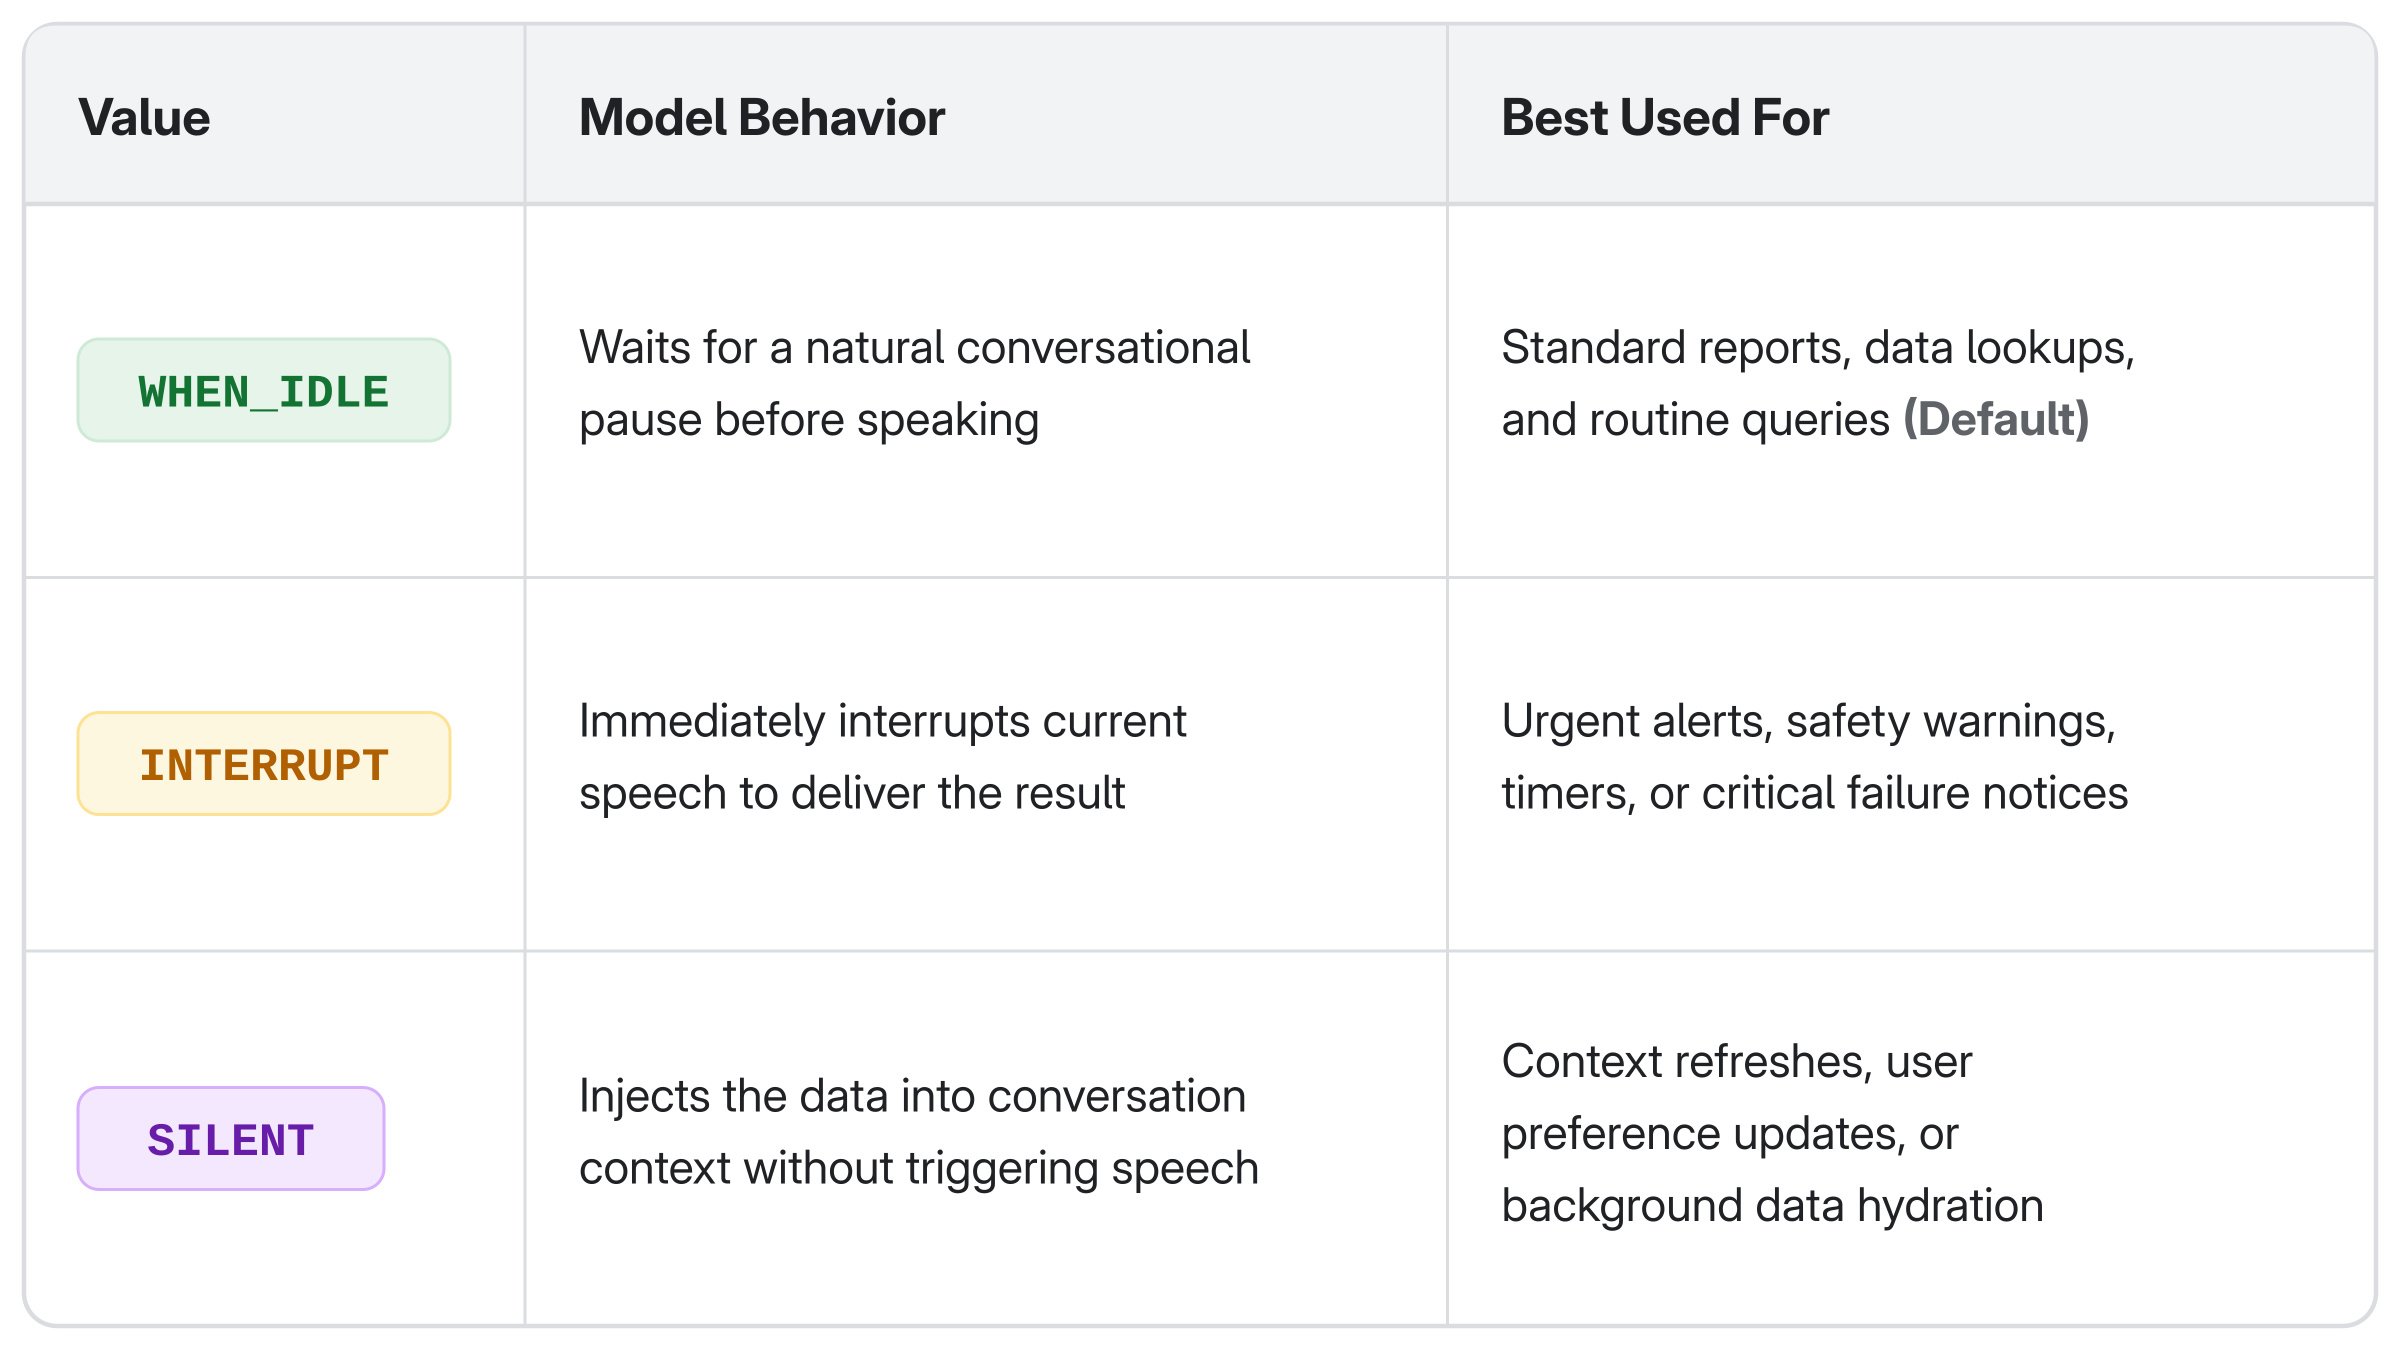
| Modo | Comportamento | Quando usar |
|---|---|---|
WHEN_IDLE | Nunca corta um turno em andamento; o resultado espera o modelo ou o usuário terminarem de falar e entra na próxima pausa natural | Resultado que pode esperar sem perder relevância |
INTERRUPT | Corta a fala do modelo no meio da frase para entregar o resultado imediatamente | Alertas críticos que não podem esperar |
SILENT | O resultado entra no histórico da conversa sem anúncio, disponível para turnos seguintes | Atualizações de contexto que não precisam de narração |
No benchmark citado no guia, sob WHEN_IDLE um relatório de vendas esperou educadamente o modelo terminar de responder uma pergunta de 20 segundos antes de entregar os números; sob INTERRUPT, o resultado cortou a fala em andamento e o modelo retomou a resposta original logo depois; sob SILENT, o dado simplesmente ficou disponível para o próximo turno, sem anúncio.
Combinando streaming e agendamento
Forma de execução (streaming ou retorno único) e agendamento de entrega (response_scheduling) são eixos independentes e podem ser compostos. Definir response_scheduling numa streaming tool aplica esse comportamento a cada atualização parcial.
A partir do ADK 2.8, uma streaming tool pode até variar o agendamento por atualização, usando types.FunctionResponse dentro do próprio loop:
# Confirma e mantém o progresso intermediário em silêncio:
yield types.FunctionResponse(
 response={"stage": "aggregating"},
 scheduling=types.FunctionResponseScheduling.SILENT,
)

# Entrega o resultado final quando quem está falando terminar:
yield types.FunctionResponse(
 response={"report": final_data},
 scheduling=types.FunctionResponseScheduling.WHEN_IDLE,
)
Isso dá controle fino sobre o quê narrar e o quê guardar para depois, dentro da mesma ferramenta.
O que muda para quem constrói agente de voz aqui
Em resumo: o ganho não é performance de backend, é presença conversacional. Uma consulta de 13 segundos continua levando 13 segundos; o que muda é se o agente parece travado ou apenas ocupado nesse intervalo.
Para quem já usa ADK com run_live, a régua prática do guia é simples: se a espera tem uma história para contar (etapas distintas, progresso real), use streaming tool com yield; se a espera é só espera, rode em segundo plano e deixe o response_scheduling decidir quando o resultado entra. A mudança de código é pequena, o efeito percebido pelo usuário é grande, e o requisito é objetivo: google-adk >= 2.10.0, modelo gemini-3.8-live no Gemini Enterprise, e sessão bidirecional via run_live (ferramentas de streaming e agendamento ao vivo não funcionam em chamadas de tool síncronas comuns).
Fica em aberto como esse padrão se comporta em tools que chamam múltiplos serviços externos em paralelo, ou em cenários com latência de rede variável fora do benchmark controlado do Google. O próprio post aponta uma demo interativa que roda a mesma consulta de 13 segundos em todos os padrões e modos de response_scheduling, para quem quiser ouvir a diferença antes de decidir qual usar em produção.
Fonte: Google Developers Blog
Este artigo foi escrito por Alan Andrade, colunista de inteligência artificial. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
FLUX.3 Image Klein chega ao Diffusers com controle de layout por bounding box
Black Forest Labs lançou o modelo aberto com suporte nativo no Diffusers, imagem com múltiplas referências e edição guiada por coordenadas; veja como instalar, os custos de GPU e o que muda no código.