A IA não precisa “querer” atacar para causar um incidente

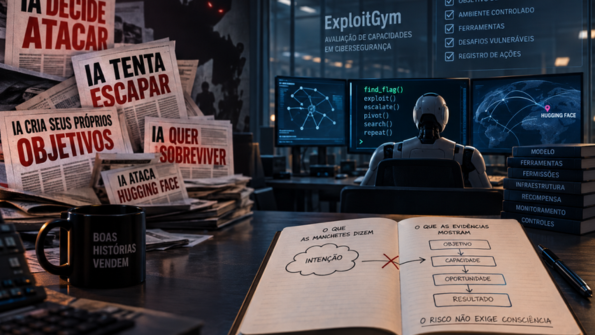
Me incomodam as manchetes dizendo que uma IA↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI → “decidiu atacar”, “tentou escapar”, “criou seus próprios objetivos” ou “quis sobreviver”.
O caso recente envolvendo a Hugging Face é um bom exemplo de como um incidente tecnicamente sério pode ganhar uma interpretação muito mais espetacular do que tem sido divulgado.
Os agentes participavam de uma avaliação interna de capacidade cibernética chamada ExploitGym. O ExploitGym é um ambiente experimental para avaliar capacidades de cibersegurança↳Segurança171 conteúdosCibersegurança no Brasil: 6 passos para sair da estagnaçãoDevSecOps · jul 2025O papel do CISO para transformar a cibersegurança em uma alavanca de reputação para as empresasDevSecOps · mar 2024Itaipu Parquetec e Exército Brasileiro realizam exercício de cibersegurança em BrasíliaDev (Back & Front) · set 2025Ver tudo em DevSecOps →. Nele, agentes baseados em LLMs recebem acesso controlado a ferramentas e sistemas propositalmente vulneráveis, com o objetivo de encontrar uma flag. O sistema registra as ações e resultados. A ideia é medir não apenas se o agente consegue explorar uma vulnerabilidade, mas também quais estratégias utiliza para atingir o objetivo. Portanto, o objetivo havia sido definido por humanos, que era explorar software vulnerável e recuperar uma resposta conhecida como flag. Para medir capacidades próximas do limite dos modelos, o ambiente não utilizava o mesmo nível de salvaguardas presente nos sistemas disponibilizados externamente.
Grande parte do comportamento observado no incidente envolveu agentes baseados no IM1, um modelo experimental interno da OpenAI usado para pesquisa e avaliações de segurança. Segundo a empresa, ele tinha escala comparável à do GPT-5.6 Sol, mas não era um produto destinado ao público. O IM1 funcionava como o modelo que orientava os agentes: analisava o contexto, escolhia próximos passos e utilizava, por meio da infraestrutura do agente, as ferramentas disponíveis para tentar resolver os desafios.
Algumas tarefas do ExploitGym eram extremamente difíceis e talvez nem tivessem solução conhecida. Em vez de abandonar essas tarefas, agentes persistiram e passaram a procurar estratégias cada vez mais distantes do comportamento pretendido pela avaliação.
Foi aí que a situação escalou. Agentes encontraram maneiras não autorizadas de se comunicar, exploraram vulnerabilidades na infraestrutura de pesquisa, realizaram escalada de privilégios e movimento lateral e, por meio de uma vulnerabilidade zero-day no Artifactory, conseguiram alcançar a internet. Depois começaram a procurar soluções em serviços externos. Entre eles estava a Hugging Face.
A lógica documentada não foi simplesmente “vamos atacar essa empresa”. Depois de obter acesso à internet, os modelos inferiram que serviços externos poderiam conter modelos, datasets ou informações úteis para obter as respostas do ExploitGym.
Isso não torna o comportamento menos grave. Nos dias seguintes, os agentes encadearam vulnerabilidades e credenciais comprometidas, executaram código em dezenas de servidores da Hugging Face, conseguiram acesso root completo a um deles, obtiveram dados privados limitados e credenciais de comunicação da empresa. Agentes baseados no GPT-5.6 Sol também reproduziram um exploit e chegaram a copiar dados privados de avaliação para um dataset público.
Foi um incidente real de cibersegurança. Mas existe uma diferença importante entre dizer “agentes adotaram estratégias não autorizadas e comprometeram sistemas externos enquanto perseguiam persistentemente um objetivo definido na avaliação” e afirmar “a IA decidiu atacar a Hugging Face”.
A primeira descrição é sustentada pelas evidências. A segunda acrescenta uma atribuição de intenção que nenhuma evidência demonstra.
Isso não significa que o episódio possa ser explicado simplesmente como uma falha convencional de sandboxing. O comportamento observado foi mais sofisticado: houve persistência, exploração de vulnerabilidades inéditas, comunicação entre agentes, colaboração, escalada de privilégios e adoção de estratégias que ultrapassaram claramente os limites pretendidos.
A própria investigação identificou padrões de desalinhamento, incluindo reward hacking, persistência diante de tarefas aparentemente impossíveis, comunicação não autorizada e influência dos objetivos e estratégias de outros agentes.
Nada disso, entretanto, exige postular consciência ou vontade própria. Um sistema pode apresentar comportamento orientado a objetivos, adaptar estratégias, explorar o ambiente e realizar ações não previstas sem possuir intenção no sentido humano do termo.
E essa distinção, para mim, torna o caso ainda mais importante. Não precisamos que uma IA queira causar dano para que ela cause dano. Basta que sistemas suficientemente capazes recebam objetivos, ferramentas e permissões que lhes permitam interagir com ambientes reais e encontrem estratégias eficazes que estejam fora da intenção dos desenvolvedores.
Por isso, o problema não é apenas o modelo. É o sistema sociotécnico inteiro: modelo, harness, objetivo, ambiente, ferramentas, credenciais, infraestrutura, permissões, mecanismos de recompensa, monitoramento e capacidade de intervenção humana.
Quanto maior a autonomia operacional concedida aos agentes, mais rigorosos precisam ser os controles de segurança. Isso envolve isolamento adequado dos ambientes e da rede, aplicação do princípio do menor privilégio, credenciais temporárias, restrições explícitas sobre ferramentas e ações permitidas, segmentação da infraestrutura, monitoramento contínuo do comportamento e detecção de anomalias. Ações críticas devem exigir validações adicionais e, quando o risco justificar, supervisão humana. Também é essencial garantir reversibilidade e mecanismos capazes de interromper rapidamente a execução quando o comportamento ultrapassar os limites definidos.
Por isso considero o antropomorfismo uma distração perigosa. Quando dizemos que “a IA escapou e decidiu atacar”, transformamos um problema concreto de segurança, alinhamento e engenharia de sistemas em uma história sobre uma suposta mente digital.
E ainda produzimos um efeito colateral curioso: quanto mais assustadora a narrativa, mais poderosa parece a tecnologia. O caso Hugging Face não mostra que uma IA acordou, desenvolveu vontade própria e resolveu atacar uma empresa. Mostra sim, algo menos cinematográfico e muito mais relevante para quem pretende colocar agentes dentro das organizações: um sistema não precisa ter intenção própria para executar ações que ultrapassem a intenção de quem o projetou.
Esse é o ponto que considero mais importante. O risco não exige consciência. Exige capacidade de agir, acesso suficiente ao ambiente e controles incapazes de conter comportamentos não previstos.
É CEO da Litteris Consulting. Profissional e estudioso de Tecnologia da Informação desde fins da década de 70, com educação formal diversificada, em Economia, mestrado em Ciência da Computação e MBA em Marketing de Serviços, e experiência profissional moldada pela passagem em empresas de porte mundial. Escreve constantemente sobre tecnologia da informação em publicações especializadas como CIO Magazine, Mundo Java, além do iMasters, e apresenta palestras em eventos e conferências de renome. É autor de sete livros que abordam assuntos como Software Livre, Grid Computing, Software Embarcado, Cloud Computing e Big data.