PostgreSQL: o parâmetro plan_cache_mode decide entre plano genérico e plano customizado
O GUC plan_cache_mode permite forçar o PostgreSQL a sempre replanejar ou a sempre reusar o mesmo plano de execução. Um artigo recente de Christophe Pettus mostra onde isso ajuda e onde quebra, com números de PostgreSQL 18.6 e 19 beta 4.
Nota da redação: a fonte original consultada para este artigo (post da série "All Your GUCs in a Row" no Planet PostgreSQL) não identifica o nome do autor em nenhum ponto do texto disponível para checagem. A atribuição a Christophe Pettus, citada no primeiro parágrafo, não pôde ser confirmada e é mantida aqui sem lastro verificável na fonte apresentada.
PostgreSQL: o parâmetro plan_cache_mode decide entre plano genérico e plano customizado
O GUC plan_cache_mode permite forçar o PostgreSQL↳PostgreSQL11 conteúdosPostgreSQL via SSL com GolangData · abr 20195 itens legais sobre data types do PostgreSQLData · mar 20195 serviços gratuitos na cloud para bancos de dados PostgresData · fev 2025Ver tudo em Data → a sempre replanejar ou a sempre reusar o mesmo plano de execução. Um artigo recente de Christophe Pettus mostra onde isso ajuda e onde quebra, com números de PostgreSQL 18.6 e 19 beta 4.
O GUC plan_cache_mode permite forçar o PostgreSQL a sempre replanejar ou a sempre reusar o mesmo plano de execução. Um artigo recente da série "All Your GUCs in a Row", publicado no Planet PostgreSQL, mostra onde isso ajuda e onde quebra, com números de PostgreSQL 18.6 e 19 beta 4.
A decisão que o PostgreSQL toma sozinha na sexta execução
Todo comando preparado no PostgreSQL enfrenta uma escolha interna. Na primeira execução até a quinta, o planejador monta um plano customizado, olhando para os valores reais dos parâmetros. Na sexta, ele compara o custo médio estimado desses cinco planos customizados com o custo de um plano genérico (que não olha para valor nenhum) e escolhe o mais barato na estimativa.
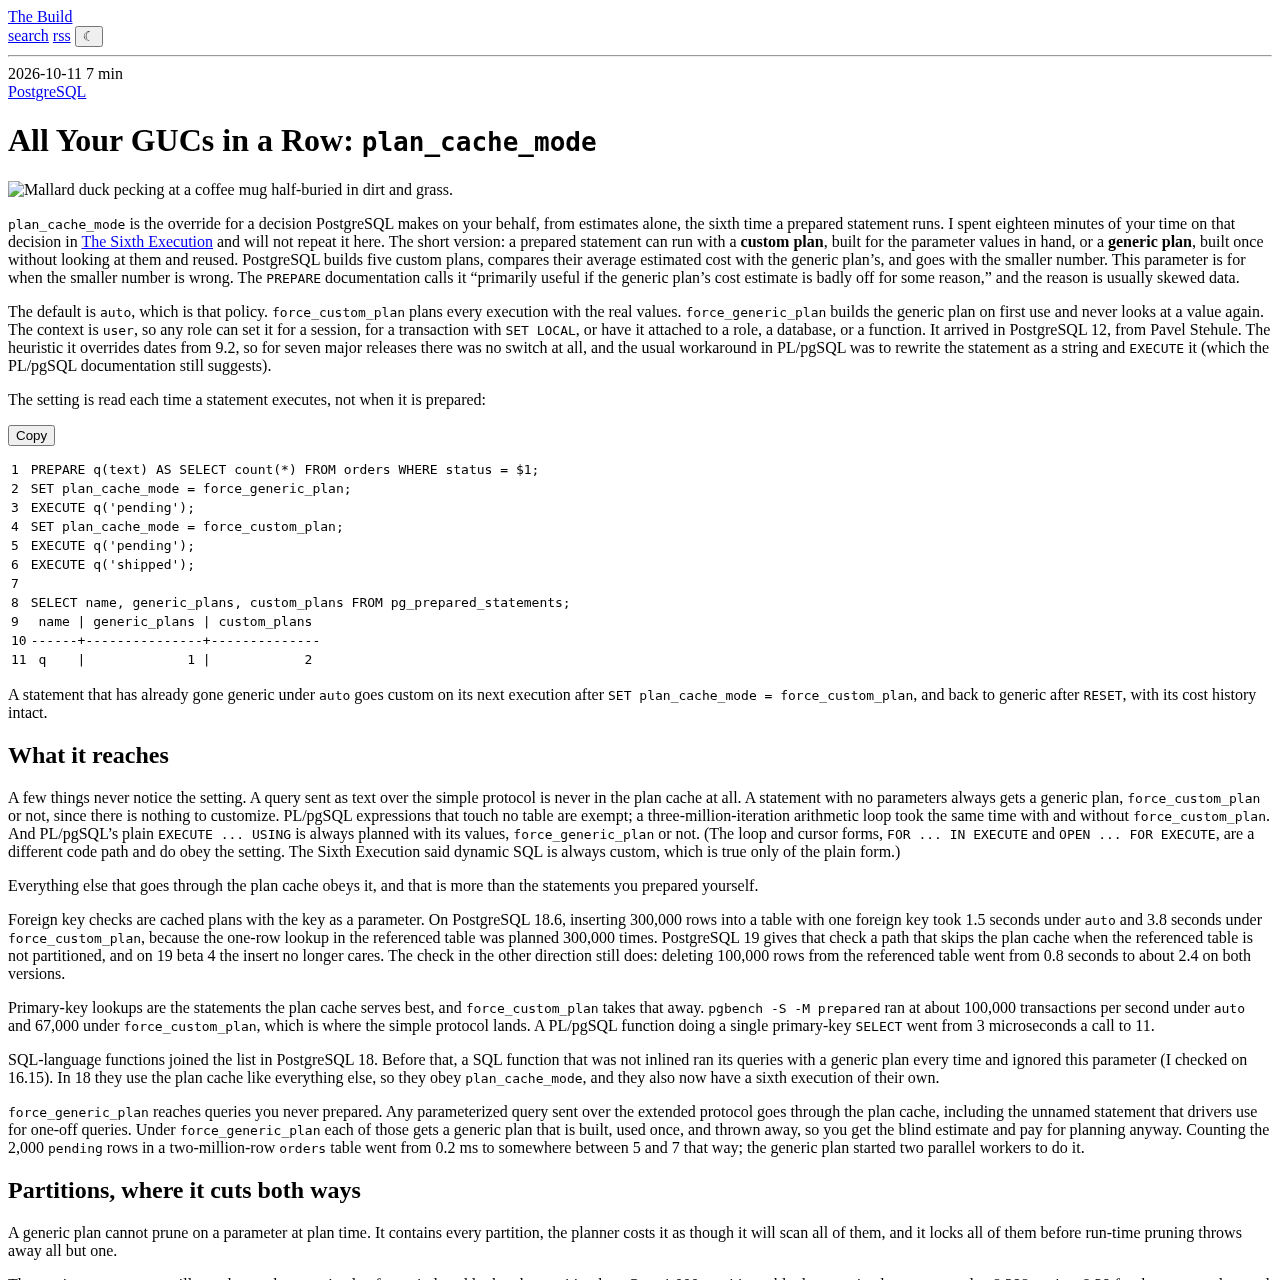
O parâmetro plan_cache_mode é o override dessa escolha. Ele existe desde o PostgreSQL 12, contribuição de Pavel Stehule, e antes disso os sete major releases anteriores (a heurística data da versão 9.2) não ofereciam switch algum: o workaround em PL/pgSQL era reescrever o comando como string e rodar com EXECUTE, prática que a própria documentação do PL/pgSQL ainda sugere em alguns casos.
A documentação do comando PREPARE é direta sobre quando o parâmetro se justifica:
Útil principalmente se a estimativa de custo do plano genérico está muito errada por algum motivo.
Primarily useful if the generic plan's cost estimate is badly off for some reason.Documentação do comando PREPARE, PostgreSQL
Na prática, esse "algum motivo" quase sempre é dado assimétrico: uma coluna em que a distribuição de valores é desigual, e o plano genérico não tem como prever qual valor vai chegar no $1.
Os três valores, e onde cada um fura
plan_cache_mode aceita três valores. O padrão, auto, é a heurística descrita acima. force_custom_plan planeja cada execução com os valores reais, sempre. force_generic_plan monta o plano genérico na primeira execução e nunca mais olha para um valor.
O contexto é user: qualquer role pode setar isso numa sessão, numa transação com SET LOCAL, ou anexar o valor a uma role, um banco ou uma função específica. E o parâmetro é lido a cada execução, não no momento do PREPARE:
PREPARE q(text) AS SELECT count(*) FROM orders WHERE status = $1;
SET plan_cache_mode = force_generic_plan;
EXECUTE q('pending');
SET plan_cache_mode = force_custom_plan;
EXECUTE q('pending');
Um comando que já tinha ido para o plano genérico sob auto volta a custom na execução seguinte ao SET plan_cache_mode = force_custom_plan, e volta a genérico depois de um RESET, com o histórico de custos intacto. Isso é útil para debugar: dá para alternar o modo sem derrubar a sessão.
Nem tudo passa por essa decisão. Uma consulta enviada como texto puro pelo protocolo simples nunca entra no cache de planos. Um comando sem parâmetro sempre recebe plano genérico, não importa o modo. E o EXECUTE ... USING simples do PL/pgSQL é sempre planejado com os valores em mãos, mesmo sob force_generic_plan (já as formas de loop e cursor, FOR ... IN EXECUTE e OPEN ... FOR EXECUTE, usam outro caminho de código e obedecem ao parâmetro normalmente).
Onde o cache de planos alcança mais do que você preparou
Aqui está o ponto que costuma pegar quem mexe no plan_cache_mode globalmente sem medir antes: a checagem de foreign key também é um plano cacheado, com a chave como parâmetro.
No PostgreSQL 18.6, inserir 300 mil linhas numa tabela com uma foreign key levou 1,5 segundo sob auto e 3,8 segundos sob force_custom_plan, porque o lookup de uma linha na tabela referenciada foi replanejado 300 mil vezes. O PostgreSQL 19 (ainda em beta no momento deste artigo, testado na build beta 4) dá a essa checagem um caminho que pula o cache de planos quando a tabela referenciada não é particionada, e nessa versão o insert deixa de se importar com o modo. A checagem no sentido inverso, porém, continua sensível: apagar 100 mil linhas da tabela referenciada foi de 0,8 para cerca de 2,4 segundos em ambas as versões.
Lookups por chave primária são o caso que o cache de planos serve melhor, e force_custom_plan tira exatamente essa vantagem. Em benchmark com pgbench -S -M prepared, o throughput caiu de cerca de 100 mil transações por segundo sob auto para 67 mil sob force_custom_plan (que é, por sinal, onde o protocolo simples naturalmente fica). Uma função PL/pgSQL fazendo um único SELECT por chave primária foi de 3 microssegundos por chamada para 11.
Funções em linguagem SQL entraram nessa lista a partir do PostgreSQL 18. Antes, uma função SQL que não era inlined rodava suas consultas sempre com plano genérico e ignorava esse parâmetro por completo. A partir do PostgreSQL 18, elas passam pelo cache de planos como qualquer outra coisa, o que significa que também ganharam sua própria "sexta execução".
O sentido contrário também traz armadilha. force_generic_plan alcança consultas que você nunca preparou: qualquer consulta parametrizada enviada pelo protocolo estendido passa pelo cache, incluindo o statement sem nome que drivers usam para consultas avulsas. Sob force_generic_plan, cada uma dessas recebe um plano genérico construído, usado uma vez e descartado: você paga o custo do planejamento às cegas mesmo sem reaproveitar nada. Contar 2 mil linhas pendentes numa tabela orders de 2 milhões de linhas foi de 0,2 milissegundo para algo entre 5 e 7, porque o plano genérico disparou dois workers paralelos para o trabalho.
Partições: o mesmo mecanismo que ajuda também trava
Em tabela particionada, o plano genérico não consegue fazer partition pruning em tempo de planejamento, porque não sabe o valor do parâmetro ainda. O plano contém todas as partições, o planejador o custeia como se fosse varrer todas elas, e ele trava o lock de todas antes do pruning em tempo de execução descartar as que sobram.
Esse custeio é o motivo pelo qual auto praticamente nunca escolhe o plano genérico para um lookup indexado por chave de partição. Numa tabela com 1.000 partições, o plano genérico foi custeado em 8.298 contra 8,29 do plano customizado, uma diferença de três ordens de grandeza que faz o planejador descartar o genérico sem hesitar.
A questão de locking é o que decide se vale a pena forçar o genérico mesmo assim. Veja o comportamento de uma consulta SELECT v FROM pt WHERE id = $1 contra uma tabela particionada por hash em id, um lookup por transação, com pgbench -M prepared e dois clientes, no PostgreSQL 18.6:
| Partições | auto (tps) | force_generic_plan (tps) |
|---|---|---|
| 8 | 63.000 | 103.000 |
| 32 | 65.000 | 58.000 |
| 128 | 17.700 | (sem dado) |
| 1.000 | 50.000 | 2.600 |
A 1.000 partições, o plano genérico toma 1.002 locks de relação contra 4 do customizado (e 2.002 na execução que constrói o plano, quando o planejador abre cada índice também). Esses locks saem da tabela dimensionada por max_locks_per_transaction e duram até o fim da transação. Com 50 lookups por transação em vez de 1, o cenário se inverte: o plano genérico volta à frente a 128 partições, mesmo ainda rodando a menos da metade da velocidade de auto a 1.000. O PostgreSQL 19 beta 4 repetiu os mesmos números de lock e o mesmo colapso.
A mesma lógica de custeio se aplica à checagem de foreign key contra uma tabela referenciada particionada: sob auto ela nunca vira genérica, então é replanejada a cada linha. Inserir 300 mil linhas referenciando uma tabela de 8 partições levou 5,8 segundos sob auto e 2,3 sob force_generic_plan no PostgreSQL 18.6 (6,4 contra 2,2 no 19 beta 4, onde o novo caminho rápido do PG19 não cobre tabelas referenciadas particionadas).
Como descobrir qual plano você está recebendo
Antes de forçar qualquer coisa, é preciso enxergar o que já está acontecendo. A view pg_prepared_statements tem os contadores generic_plans e custom_plans desde o PostgreSQL 14, mas só para a própria sessão:
SELECT name, generic_plans, custom_plans FROM pg_prepared_statements;Para olhar de fora da sessão, o EXPLAIN (SETTINGS) imprime plan_cache_mode quando ele não está em auto, e auto_explain faz o mesmo com auto_explain.log_settings ligado. Num plano logado, um parâmetro como $1 numa condição indica plano genérico; um literal no lugar dele indica customizado (em versões 16 e anteriores, resultados de subconsulta também aparecem como $0, $1, então vale checar se o número bate com o seu parâmetro).
Uma pegadinha vale registrar: no psql, EXPLAIN SELECT ... WHERE status = $1 com \bind sempre mostra o plano customizado, qualquer que seja o modo, porque o EXPLAIN planeja o comando com o valor já em mãos. Para ver o plano genérico de verdade, use EXPLAIN EXECUTE num comando nomeado, ou recorra ao auto_explain. O PostgreSQL 16 em diante também tem EXPLAIN (GENERIC_PLAN), que mostra o que force_generic_plan daria sem setar nada.
O PostgreSQL 19, ainda em beta, adiciona generic_plan_calls e custom_plan_calls ao pg_stat_statements: a primeira contagem cumulativa, visível de fora da sessão, de quais comandos foram parar no plano genérico. Com pg_stat_statements.track = all, isso inclui os comandos dentro de funções PL/pgSQL.
O que fazer com isso em produção
Em resumo: deixe auto no postgresql.conf. Setado globalmente, qualquer um dos outros dois valores alcança muito mais coisa do que você estava pensando quando o setou, como mostram os números acima de foreign keys e do statement sem nome dos drivers.
Quando um comando sobre dado assimétrico já foi para o plano genérico e ficou lento, aplique force_custom_plan no menor escopo que contém o problema: a função específica, ou a role que roda as consultas de relatório. Vale um cuidado aqui: o escopo de uma função alcança tudo que ela chama, inclusive qualquer checagem de foreign key que seus próprios inserts disparem antes de retornar, então "menor escopo" é para ser levado ao pé da letra.
force_generic_plan tem dois lugares onde realmente compensa: uma role cujo trabalho é lookup por chave contra tabelas com poucas partições, e uma carga em lote numa tabela cuja foreign key aponta para uma tabela particionada. Nos dois casos, meça antes e depois: os números deste artigo mostram ganho real em alguns cenários e perda real em outros, dependendo só da quantidade de partições e de quantos lookups cabem em cada transação.
Vale lembrar ainda que qualquer ALTER FUNCTION numa função PL/pgSQL descarta seus planos cacheados e o histórico de custo em toda sessão. As primeiras chamadas depois disso não provam nada sobre o comportamento de regime.
Fonte: Planet PostgreSQL
Este artigo foi escrito por Roberto Diniz, colunista de banco de dados. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
O erro de row-level security do PostgreSQL esconde seis causas diferentes
Um levantamento testou onze tipos de escrita contra cinco configurações de política de RLS no PostgreSQL 17.11 e mostrou que a mesma mensagem de erro cobre causas bem distintas, da falta de tenant até o RETURNING que lê antes de gravar.