DELETE no PostgreSQL não encolhe a tabela: só o VACUUM reaproveita o espaço
Um teste com 2 milhões de linhas mostra, em números, por que o DELETE mantém o tamanho físico da tabela e o que de fato devolve espaço ao disco.
O experimento: 2 milhões de linhas, uma métrica simples
Um post publicado no Planet PostgreSQL↳PostgreSQL11 conteúdosPostgreSQL via SSL com GolangData · abr 20195 itens legais sobre data types do PostgreSQLData · mar 20195 serviços gratuitos na cloud para bancos de dados PostgresData · fev 2025Ver tudo em Data →, em 13 de outubro de 2026, traz uma medição direta de algo que todo DBA repete de ouvido: tabela que perde linhas não perde espaço em disco. Em vez de deixar a afirmação solta, o autor mediu com pg_table_size numa tabela de 2 milhões de linhas, em PostgreSQL 18.6 com configuração padrão e autovacuum ligado.
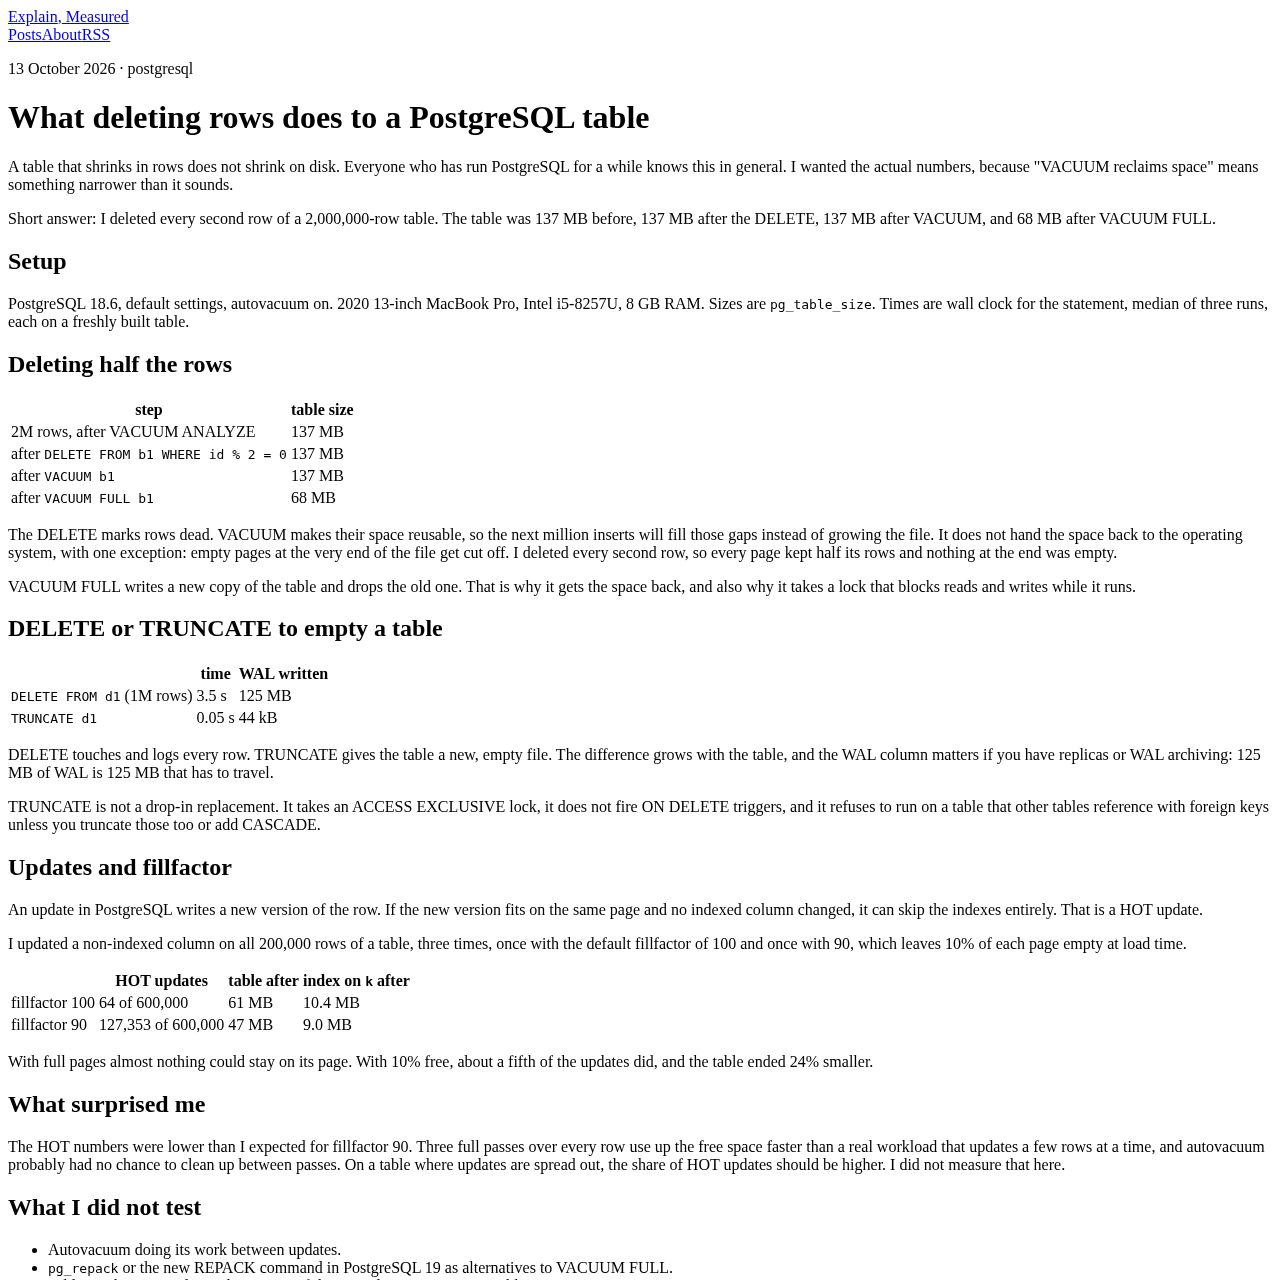
O resultado: a tabela ocupava 137 MB antes de qualquer alteração. Depois de um DELETE FROM b1 WHERE id % 2 = 0 (metade das linhas apagadas), continuava com 137 MB. Depois de um VACUUM b1, ainda 137 MB. Só depois de VACUUM FULL b1 ela caiu para 68 MB. Quatro etapas, um único ponto de inflexão.
MVCC por baixo: por que o DELETE não devolve espaço
O motivo está no controle de concorrência multiversão (MVCC) que o PostgreSQL usa para isolar transações. Um DELETE não apaga a linha fisicamente: marca a versão da linha como morta, mas mantém os bytes no lugar até que nenhuma transação em andamento ainda possa precisar enxergá-los.
É aí que entra o VACUUM: ele varre as páginas, identifica as versões mortas e libera esse espaço para reuso dentro do próprio arquivo da tabela. Não devolve nada ao sistema operacional. A exceção é o fim do arquivo: se sobrarem páginas inteiramente vazias na cauda, o VACUUM corta o arquivo ali. Como o teste apagou uma linha a cada duas, toda página manteve metade do conteúdo e nenhuma ficou vazia no fim, então não houve corte algum.
VACUUM FULL: a única forma de recuperar o espaço, com um preço
VACUUM FULL funciona de um jeito completamente diferente: ele escreve uma cópia nova da tabela, só com as linhas vivas, e descarta o arquivo antigo. É por isso que o tamanho cai de verdade (os 68 MB do teste) e também por isso que ele custa uma trava ACCESS EXCLUSIVE durante toda a operação, bloqueando leitura e escrita na tabela.
| Etapa | Tamanho da tabela |
|---|---|
| 2M linhas, após VACUUM ANALYZE | 137 MB |
| Após DELETE de metade das linhas | 137 MB |
| Após VACUUM | 137 MB |
| Após VACUUM FULL | 68 MB |
Na prática, isso significa que rodar VACUUM FULL numa tabela de produção sem planejamento é trocar espaço em disco por uma janela de indisponibilidade. A fonte cita, entre os itens não testados, o pg_repack externo e o novo comando REPACK do PostgreSQL 19 como alternativas possíveis ao VACUUM FULL, mas não detalha como cada um se comporta em termos de lock, e o autor deixa claro que não testou nenhum dos dois neste experimento.
DELETE x TRUNCATE: diferença de ordem de grandeza, não de detalhe
Para esvaziar uma tabela inteira, a fonte comparou DELETE sem filtro contra TRUNCATE numa tabela de 1 milhão de linhas. A diferença não é sutil:
| Comando | Tempo | WAL gerado |
|---|---|---|
| DELETE FROM d1 (1M linhas) | 3,5 s | 125 MB |
| TRUNCATE d1 | 0,05 s | 44 kB |
DELETE toca e registra no WAL cada linha individualmente. TRUNCATE simplesmente atribui à tabela um arquivo novo e vazio, sem percorrer linha por linha. A coluna de WAL importa especialmente para quem mantém réplicas ou arquivamento de WAL: 125 MB de log é volume real trafegando pela rede e ocupando armazenamento de arquivo, contra 44 kB.
Mas TRUNCATE não é um substituto drop-in para DELETE sem filtro. Três restrições que o artigo destaca merecem ir para qualquer checklist de revisão de schema:
- Toma uma trava
ACCESS EXCLUSIVE, mais restritiva que a de umDELETEcomum; - Não dispara triggers
ON DELETE, o que quebra qualquer lógica de auditoria ou cascata implementada em trigger; - Recusa rodar numa tabela referenciada por chave estrangeira de outra, a menos que se trunque as duas juntas ou se use
CASCADE.
Fillfactor e HOT updates: o detalhe que evita reescrever índices
A segunda parte do teste mede algo menos falado: o efeito do fillfactor sobre updates. Quando um UPDATE grava uma nova versão da linha, o PostgreSQL pode evitar tocar nos índices se a nova versão couber na mesma página e nenhuma coluna indexada tiver mudado. Isso é um HOT update (heap-only tuple).
O autor atualizou uma coluna não indexada em 200 mil linhas, três vezes seguidas, comparando fillfactor padrão (100, sem espaço livre reservado) com fillfactor 90 (10% de espaço livre reservado em cada página no momento da carga):
| Configuração | HOT updates | Tabela após | Índice após |
|---|---|---|---|
| fillfactor 100 | 64 de 600.000 | 61 MB | 10,4 MB |
| fillfactor 90 | 127.353 de 600.000 | 47 MB | 9,0 MB |
Com páginas cheias, quase nenhuma atualização conseguiu ficar na mesma página: só 64 em 600 mil passagens. Com 10% de espaço livre reservado, cerca de um quinto conseguiu, e a tabela terminou 24% menor. O próprio autor admite que a proporção de HOT updates ficou abaixo do esperado, porque três passagens completas sobre todas as linhas consomem o espaço livre muito mais rápido do que um workload real, onde updates se espalham no tempo e o autovacuum tem chance de atuar entre eles. Ele não mediu esse cenário mais realista.
O que fica em aberto e o que isso muda na prática
O próprio autor lista o que não testou: o comportamento do autovacuum rodando entre updates (em vez de três passagens seguidas), pg_repack ou o REPACK do PostgreSQL 19 como alternativas ao VACUUM FULL, e tabelas com dados TOAST, onde parte do conteúdo mora numa tabela separada e segue regras próprias de inchaço.
Em resumo, para quem administra Postgres em produção, os números sustentam três decisões concretas. Primeiro, não espere que o tamanho de uma tabela caia sozinho depois de uma limpeza de dados: ele só cai com VACUUM FULL, REPACK ou recriação da tabela, e todos têm custo de lock ou de ferramenta externa. Segundo, para esvaziar uma tabela inteira sem preservar auditoria por trigger nem referência de chave estrangeira, TRUNCATE evita gerar WAL desproporcional, mas exige checar triggers e FKs antes.
Terceiro, em tabelas com updates frequentes em colunas não indexadas, vale medir se reduzir o fillfactor aumenta a taxa de HOT updates o suficiente para compensar o espaço reservado a mais na carga inicial, algo que depende do padrão real de escrita, não de uma regra fixa. O código usado no teste, run2.py e results2.json, está disponível no post original para quem quiser reproduzir os números com a própria carga de dados.
Fonte 1: Planet PostgreSQL (https://postgr.es/p/9xV)
What deleting rows does to a PostgreSQL table | Explain, Measured
13 October 2026 · postgresql
What deleting rows does to a PostgreSQL table
A table that shrinks in rows does not shrink on disk. Everyone who has run PostgreSQL for a while knows this in general. I wanted the actual numbers, because "VACUUM reclaims space" means something narrower than it sounds.
Short answer: I deleted every second row of a 2,000,000-row table. The table was 137 MB before, 137 MB after the DELETE, 137 MB after VACUUM, and 68 MB after VACUUM FULL.
Setup
PostgreSQL 18.6, default settings, autovacuum on. 2020 13-inch MacBook Pro, Intel i5-8257U, 8 GB RAM. Sizes are pg_table_size . Times are wall clock for the statement, median of three runs, each on a freshly built table.
Deleting half the rows
step table size
2M rows, after VACUUM ANALYZE 137 MB
after DELETE FROM b1 WHERE id % 2 = 0 137 MB
after VACUUM b1 137 MB
after VACUUM FULL b1 68 MB
The DELETE marks rows dead. VACUUM makes their space reusable, so the next million inserts will fill those gaps instead of growing the file. It does not hand the space back to the operating system, with one exception: empty pages at the very end of the file get cut off. I deleted every second row, so every page kept half its rows and nothing at the end was empty.
VACUUM FULL writes a new copy of the table and drops the old one. That is why it gets the space back, and also why it takes a lock that blocks reads and writes while it runs.
DELETE or TRUNCATE to empty a table
time WAL written
DELETE FROM d1 (1M rows) 3.5 s 125 MB
TRUNCATE d1 0.05 s 44 kB
DELETE touches and logs every row. TRUNCATE gives the table a new, empty file. The difference grows with the table, and the WAL column matters if you have replicas or WAL archiving: 125 MB of WAL is 125 MB that has to travel.
TRUNCATE is not a drop-in replacement. It takes an ACCESS EXCLUSIVE lock, it does not fire ON DELETE triggers, and it refuses to run on a table that other tables reference with foreign keys unless you truncate those too or add CASCADE.
Updates and fillfactor
An update in PostgreSQL writes a new version of the row. If the new version fits on the same page and no indexed column changed, it can skip the indexes entirely. That is a HOT update.
I updated a non-indexed column on all 200,000 rows of a table, three times, once with the default fillfactor of 100 and once with 90, which leaves 10% of each page empty at load time.
HOT updates table after index on k after
fillfactor 100 64 of 600,000 61 MB 10.4 MB
fillfactor 90 127,353 of 600,000 47 MB 9.0 MB
With full pages almost nothing could stay on its page. With 10% free, about a fifth of the updates did, and the table ended 24% smaller.
What surprised me
The HOT numbers were lower than I expected for fillfactor 90. Three full passes over every row use up the free space faster than a real workload that updates a few rows at a time, and autovacuum probably had no chance to clean up between passes. On a table where updates are spread out, the share of HOT updates should be higher. I did not measure that here.
What I did not test
Autovacuum doing its work between updates. pg_repack or the new REPACK command in PostgreSQL 19 as alternatives to VACUUM FULL. Tables with TOAST data, where some of the space lives in a separate table. Other hardware. Compare the ratios, not the seconds.
Reproduce it
run2.py and results2.json . Sections 5, 6 and 11 of the script.
Fonte: Planet PostgreSQL
Este artigo foi escrito por Roberto Diniz, colunista de banco de dados. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Teste com 179 índices recomendados no Postgres mostra que 18% pioraram a consulta
Um experimento com o Join Order Benchmark testou, na prática, 179 índices que o planejador do PostgreSQL havia aprovado como ganho certo. Quase um em cada cinco piorou a consulta real.