Modelo de mundo quantizado roda cinco jogos inteiros dentro de um Raspberry Pi Pico 2 W

- Leitura
- 6 min
- Tabelas
- 1
- Código
- 2
- Fontes
- 1
O projeto tinyworldformer treina duas redes neurais minúsculas que geram e jogam Breakout, Pong, Flappy Bird, Doom-lite e Pac-Man lite direto no RP2350, sem nuvem e sem GPU.
Um projeto publicado no GitHub por um desenvolvedor identificado como SheepSeb mostra até onde um modelo de IA↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI → consegue encolher sem perder utilidade prática. O tinyworldformer gera e joga cinco jogos clássicos, Breakout, Pong, Flappy Bird, uma versão simplificada de Doom (chamada Doom-lite) e outra de Pac-Man, inteiramente dentro de um Raspberry Pi Pico 2 W. Sem conexão com a internet, sem GPU, sem servidor remoto.
O Pico 2 W é o microcontrolador de baixo custo da Raspberry Pi Foundation baseado no chip RP2350: tem uma FPU embutida, 4 MB de flash e 520 KB de SRAM (512 KiB no mapa de memória principal). Rodar um modelo de linguagem genérico ali dentro seria inviável, mas o projeto não tenta isso. Ele treina um "modelo de mundo" (world model) pequeno o bastante para prever, quadro a quadro, como um jogo específico se comporta.
Duas redes, cada uma com seu trabalho
O sistema divide a tarefa em duas redes separadas, que nunca veem o jogo real:
- O modelo de mundo: um transformer em loop (looped transformer) quantizado em int8, com 26 mil a 131 mil parâmetros dependendo do jogo. Recebe o quadro atual mais a ação escolhida e prevê o próximo quadro e a recompensa, a um custo de 2 a 8 milhões de multiply-adds por quadro.
- O ator: um MLP de duas camadas ocultas, em float32, com 9 a 16 mil parâmetros. Olha apenas para o quadro que o modelo de mundo "sonhou" e decide qual botão apertar.
As duas redes rodam no núcleo 1 do RP2350, que é dual-core, enquanto o núcleo 0 cuida de USB e do display. O ator pré-treinado pode ser trocado por um agente que aprende do zero direto na placa.
Por que um transformer em loop
A escolha de arquitetura vem de um interesse específico do autor em reaproveitar pesos entre passadas, em vez de empilhar camadas diferentes, o que barateia drasticamente o uso de memória.
Fiquei interessado em transformers em loop, nos quais um único bloco é aplicado várias vezes com os mesmos pesos, em vez de empilhar camadas diferentes.
SheepSeb, autor do projeto tinyworldformerI got interested in looped transformers, where one transformer block is applied several times with the same weights instead of stacking different layers.
Na prática, o mesmo bloco de atenção mais MLP roda de 1 a 4 vezes sobre o mesmo quadro, somando a entrada de volta antes de cada passada. No Pico, para manter uma taxa de quadros jogável, o projeto usa duas passadas. Cada passada extra remove erros do quadro gerado: em um exemplo de Doom-lite, o modelo desenha um inimigo errado na primeira passada e cada passada seguinte apaga parte dele, até zerar o erro na quarta.
A decodificação do quadro segue três regras: células de fundo (paredes, blocos, pontos) recebem o token mais provável de forma independente; elementos únicos (a bola, o jogador, cada fantasma) são escolhidos uma única vez entre todos os pares possíveis de célula e token, garantindo que nunca existam duas bolas ao mesmo tempo; e sprites maiores, como Pac-Man e os fantasmas, têm só uma célula com estado real, as demais são carimbadas a partir dela.
Quão exato é o jogo gerado
O repositório mede a fração de quadros, entre dados de teste nunca vistos no treino, em que todas as células previstas batem exatamente com o jogo real:
| Jogo | Quadros exatos |
|---|---|
| Flappy Bird | 100% |
| Breakout | 99,99% |
| Pong | 99,45% |
| Pac-Man lite | 86,4% |
| Doom-lite | 83,6% |
O número de Doom-lite parece pior do que é: sua visão em primeira pessoa tem 768 células, e um único pixel de parede errado já derruba o quadro inteiro da contagem, mesmo que o estado do jogo continue correto. Além da acurácia em dados gravados, o projeto roda um agente dentro do próprio sonho e compara o estado lido de volta do quadro gerado com o que as regras reais produziriam: em 5.000 passos simulados por jogo, a maior parte dos erros fica concentrada em poucas células por quadro, não em estados de jogo quebrados.
Cabendo em kilobytes de flash
Todo peso do modelo de mundo é int8, com uma escala por linha de saída; as ativações também são int8, com uma escala por tensor e por índice de loop. As multiplicações somam int8 por int8 em int32 usando a instrução SMLAD do RP2350, duas por ciclo. Os pesos int8 por si só vão de cerca de 20 KB, no Breakout, a pouco mais de 70 KB no modelo maior, Pac-Man lite, segundo a tabela de memória do repositório.
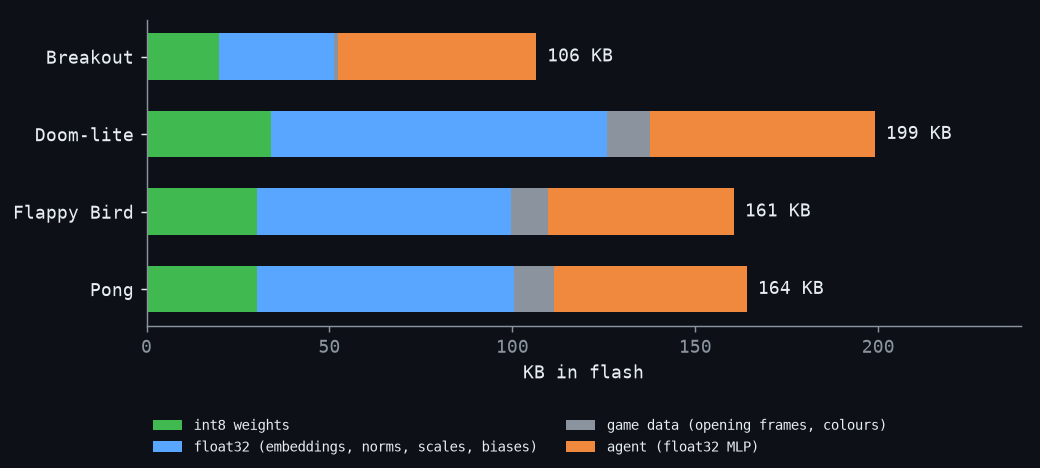
Somando firmware, drivers de display, buffers de execução e o agente, o pacote completo cabe folgado no hardware: Breakout usa 361 KB de flash e 299 KB de SRAM; Pac-Man, o jogo mais pesado, usa 600 KB de flash e 460 KB de SRAM, dentro do limite de 4 MB de flash e 512 KB de SRAM do Pico 2 W. Os próprios pesos int8 são escritos como arrays estáticos em Rust↳Rust7 conteúdosDesmistificando Rust: a linguagem segura e rápida que você precisa conhecerDev (Back & Front) · out 2024Como criar seu primeiro Programa em Rust com Solana PlaygroundDev (Back & Front) · mai 2026Rust no ranking: a segurança de memória perdeu a guerra corporativa?Marketing Tech · abr 2026Ver tudo em Dev (Back & Front) →, com cada float convertido para seus bits exatos, e um teste (cargo test) garante que o cálculo em Rust reproduz o código Python bit a bit.
Aprendendo dentro do próprio sonho
O agente padrão usa Stream AC(λ), um algoritmo de aprendizado por reforço de Elsayed, Vasan e Mahmood (2024) que atualiza a cada transição, sem replay buffer, sem lotes e sem rede-alvo. É leve o suficiente para rodar on-device: pressionar l pela USB, ou segurar o botão B por 1 segundo no Display Pack opcional, alterna entre o ator pré-treinado e um agente aprendendo do zero direto na placa.
O repositório reforça um ponto conhecido da literatura de world models (o trabalho de Ha & Schmidhuber é citado diretamente): um agente treinado só dentro do sonho aprende a explorar falhas do modelo gerador e tira pontuações bem acima do limite real do jogo, enquanto no jogo de verdade o desempenho despenca. Cada rodada de coletar dados reais e reajustar o modelo de mundo fecha uma dessas brechas.
O que isso muda pra quem programa fora da nuvem
Para quem desenvolve embarcado, IoT ou só quer testar inferência sem depender de GPU alugada, o tinyworldformer é um exemplo completo e reproduzível de pipeline de ponta a ponta: treino com quantization-aware training, exportação para Rust no_std sobre o framework Embassy, e firmware que roda em um chip de poucos dólares. O mesmo motor int8, sem nenhuma importação externa e sem wasm-bindgen, também compila para WebAssembly e roda em uma página estática no navegador.
Antes de flashear qualquer coisa, dá para rodar as versões reais dos jogos direto no terminal:
uv run python -m tinyworldformer.games.play --game pacmanE gravar um modelo e um agente específicos na placa é um único comando:
./flash.sh --env doomlite --agent doom_agent_roam_p0.3Fica em aberto um dado que o próprio autor admite não ter medido ainda: a taxa de quadros real no hardware físico. No desktop, o mesmo código Rust gera um quadro em 0,7 ms (Flappy Bird) a 1,5 ms (Breakout); no Pico, quando um humano joga, a velocidade é deliberadamente reduzida para algo jogável, entre 66 e 150 ms por quadro, mas o desempenho do agente sozinho, no limite do chip, ainda não tem número publicado.
Fonte: Hacker News
Este artigo foi escrito por Redação iMasters. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Anthropic lança ferramentas para medir o retorno do gasto com IA corporativa
Novo pacote de relatórios da Anthropic mostra a managers quanto cada time gasta em tokens, o que produziu e onde o fluxo de trabalho travou. O lançamento vem junto com dados que mostram a receita da empresa crescendo 900% nos mesmos clientes.