Google dobra memória e banda no TPU 8i Max para rodar agentes
- Leitura
- 3 min
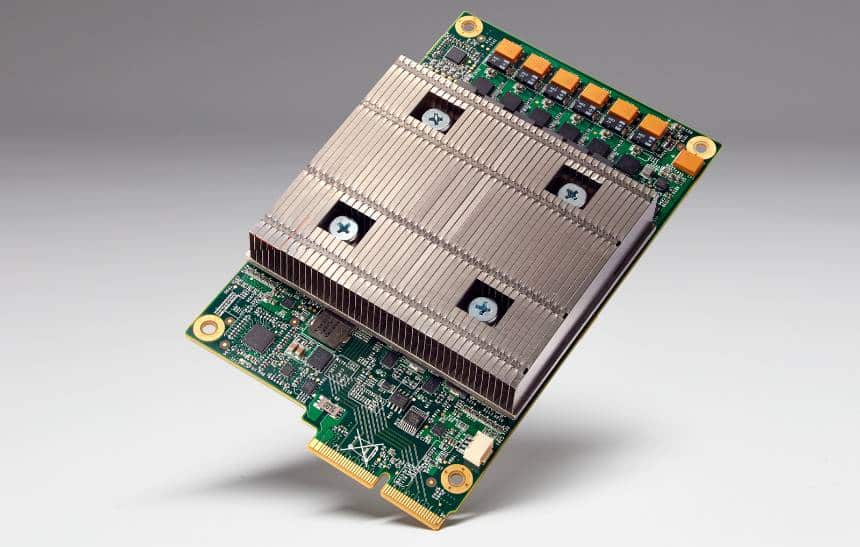
Google lançou os TPU 8tx e 8i Max para cargas de agentes de IA. Veja a criptografia em hardware, o ganho de memória e o que muda arquitetura de inferência.
Google anunciou nesta segunda-feira, 9 de novembro, dois novos chips de IA↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI →. São eles o TPU 8i Max e o TPU 8tx.
Ambos se juntam às outras duas configurações de 8ª geração lançadas neste ano.
O foco declarado aparece nos agentes autônomos. Contudo, esses sistemas vêm ganhando espaço rápido no setor produtivo.
Amin Vahdat, diretor de tecnologia e vice presidente sênior de IA e Infraestrutura, explicou a motivação. Segundo ele, a computação migrou da escala humana para a escala de agentes.
Além disso, ele citou outra demanda. Clientes altamente regulamentados pedem recursos de criptografia especializados para cargas específicas.
O TPU 8tx leva segurança para a camada de hardware Google
Esse é o diferencial central do chip.
A proteção acontece no próprio silício. Dados sensíveis e pesos de modelos ficam protegidos e isolados mesmo durante uso ativo.
O ganho de desempenho também aparece. Além disso, a latência caiu pela metade na comparação com a versão 8t, anunciada em abril.
A lista de capacidades cobre bastante coisa.
Entretanto, o chip executa e customiza modelos simultaneamente em um único sistema. Dessa forma, ele combina computação em nível de treinamento e rede de inferência rápida.
Ele também permite ajuste fino com dados privados. Os hosts usam CPU AMD personalizada, com o mesmo silício do antecessor.
Outras funções incluem destilação de modelos grandes em versões menores. Treinar agentes por aprendizado por reforço entra na mesma lista.
O detalhe mais relevante, contudo, está no fluxo. Contudo, nada disso exige migrar dados sigilosos entre clusters separados.
Portanto, o público alvo fica claro. Empresas e governos que treinam modelos proprietários encontram ali um caminho mais controlado.
Google ataca o gargalo de memória com o 8i Max
O segundo chip resolve outro problema.
Executar dezenas de agentes ao mesmo tempo costuma esbarrar em memória.
A resposta veio em números dobrados. O chip entrega o dobro de poder computacional, de SRAM e de largura de banda HBM frente ao TPU 8i.
Consequentemente, grandes cargas de trabalho ganham fluidez.
Existe ainda um ganho de densidade. Além disso, o modelo acomoda o dobro de silício na mesma estrutura.
Isso muda a conta do data center. A operação consegue implantar bem mais computação por metro quadrado e por watt.
Como a tecnologia é usada hoje
A empresa aplica esses chips em frentes distintas.
A primeira envolve treinamento dos próprios modelos para cargas de agentes. Esses modelos depois chegam aos clientes da nuvem.
A segunda opção fica com o cliente. Usuários da infraestrutura podem implantar os chips nos próprios data centers.
A adoção já tem escala. São quase 100 clientes utilizando a tecnologia, entre laboratórios de ponta, universidades, varejistas e empresas de negociação.
O que isso muda para quem constrói com agentes
Primeiro, janela de contexto virou requisito de hardware. Raciocinar sobre contexto massivo cobra memória e banda.
Segundo, isolamento em silício abre portas em setor regulado. Saúde, finanças e governo tratam movimentação de dado como barreira real.
Terceiro, evitar migração entre clusters simplifica a arquitetura. Menos cópia de dado significa menos superfície de risco.
Por fim, observe a conta por watt. Custo de inferência em escala de agente depende diretamente dessa métrica.
Acompanhe nosso perfil no Instagram!