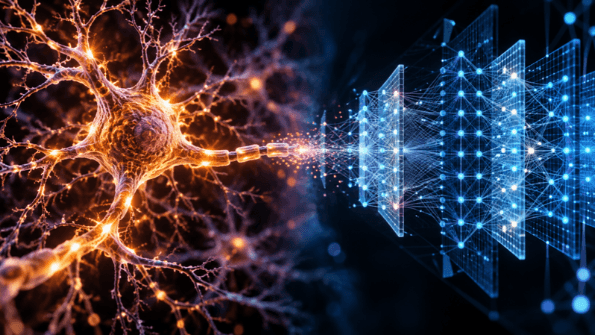
Recentemente, me perguntaram: “Qual é a diferença entre um neurônio digital e um neurônio biológico?”
A pergunta parece simples, mas abre uma discussão importante sobre como os grandes modelos de linguagem↳LLMs48 conteúdosConsiderações básicas de hardware para modelos de linguagem em código aberto: Memória, Desempenho e ViabilidadeMarketing Tech · out 2025Modelos de linguagem sob ataque: o lado obscuro da IA generativaDevSecOps · mai 2025Criando um LLM – modelo de linguagem de grande escala – do zero com TransformersAI · abr 2024Ver tudo em AI → realmente funcionam e sobre nossa tendência de utilizar conceitos da biologia para explicar sistemas computacionais.
Comecemos pelo neurônio biológico. Ele é uma célula viva, com membrana, dendritos, axônio e mecanismos eletroquímicos complexos. Recebe sinais de outras células, integra essas informações e, em muitos casos, produz impulsos elétricos chamados potenciais de ação. A comunicação ocorre predominantemente por sinapses químicas, envolvendo neurotransmissores, mas também existem sinapses elétricas.
Seu funcionamento está longe de ser um simples mecanismo de ligar e desligar. Envolve processos elétricos, químicos, espaciais e temporais, além de diferentes formas de plasticidade que modificam a eficácia das conexões e o comportamento dos circuitos neuronais.
Agora vejamos o chamado neurônio artificial. Em sua formulação clássica, ele é uma função matemática. Recebe valores numéricos, multiplica-os por pesos, soma os resultados, acrescenta um viés e aplica uma função de ativação. Não existe uma pequena célula artificial dentro do computador realizando esse processamento. O neurônio é uma abstração matemática implementada por operações executadas em hardware.
Os pesos, frequentemente comparados às sinapses biológicas, também são valores numéricos. A analogia tem utilidade histórica e didática, mas não significa que um peso reproduza os mecanismos físicos e bioquímicos de uma sinapse.
Isso não torna essas operações imateriais. Os pesos precisam ser representados fisicamente em memória, e os cálculos são realizados por circuitos eletrônicos. Entretanto, nos computadores digitais convencionais, não existe necessariamente um componente eletrônico individual e permanente correspondente a cada neurônio artificial.
Quando dizemos que um neurônio artificial “dispara”, também estamos utilizando uma analogia. Nas redes neurais convencionais, normalmente nos referimos à produção de um valor de ativação, e não a um impulso eletroquímico semelhante ao de um neurônio biológico.
Mas existe uma terceira distinção que considero ainda mais importante: um neurônio artificial não é a mesma coisa que um LLM. O neurônio artificial é uma abstração computacional. Um LLM é um modelo de grande escala, implementado por uma arquitetura de rede neural, predominantemente baseada em Transformers nos sistemas atuais.
E aqui encontramos um equívoco frequente. Quando afirmamos que determinado LLM possui 100 bilhões de parâmetros, isso não significa que ele tenha 100 bilhões de neurônios artificiais.
Parâmetros são valores numéricos aprendidos durante o treinamento, principalmente pesos de matrizes, mas também outros coeficientes, dependendo da arquitetura. Uma unidade computacional pode envolver numerosos pesos, e uma matriz pode conter milhões de parâmetros sem que isso corresponda a milhões de neurônios individuais. A contagem de parâmetros, portanto, não é uma contagem de neurônios. Tampouco representa, isoladamente, uma medida universal de inteligência ou capacidade.
Para compreender melhor essa diferença, vale observar o que acontece quando interagimos com um LLM. Primeiro, nosso texto é dividido em tokens. Cada token recebe um identificador numérico, utilizado para recuperar um vetor de uma matriz de embeddings aprendida durante o treinamento. Esse vetor representa o token em um espaço matemático de múltiplas dimensões.
O modelo também precisa considerar a posição dos tokens na sequência. Isso pode ocorrer de diferentes maneiras, dependendo da arquitetura. Alguns modelos utilizam embeddings posicionais; outros empregam mecanismos como RoPE, que introduzem informação posicional nas operações de atenção.
Essas representações passam por sucessivas camadas do Transformer, nas quais encontramos dois mecanismos particularmente importantes. O primeiro é a atenção, ou self-attention. Nesse mecanismo, o modelo calcula como informações de diferentes posições da sequência devem contribuir para atualizar as representações processadas. Para isso, utiliza projeções matemáticas conhecidas como queries, keys e values.
Nos LLMs autoregressivos, a atenção normalmente utiliza uma máscara causal, que impede que uma posição acesse tokens futuros da sequência durante o processamento. A atenção não é um neurônio individual. É um mecanismo computacional de combinação de informações entre posições da sequência. E, apesar do nome, não corresponde diretamente à experiência psicológica humana de prestar atenção.
O segundo mecanismo é a rede feedforward, frequentemente chamada de MLP. É nessa parte que encontramos unidades computacionais mais próximas do conceito tradicional de neurônio artificial. Essas redes realizam transformações matemáticas sobre as representações recebidas, utilizando matrizes de pesos e funções de ativação.
Em muitos LLMs modernos, essas operações incluem mecanismos de gating, como o SwiGLU, que tornam o processamento mais elaborado do que o neurônio artificial clássico apresentado nos cursos introdutórios. As operações de atenção e MLP, juntamente com normalização e conexões residuais, constituem os principais componentes dos blocos Transformer. Esses blocos são repetidos ao longo da arquitetura, transformando progressivamente as representações numéricas dos tokens.
Ao final, o modelo produz valores chamados logits, associados aos possíveis próximos tokens. Esses valores podem ser convertidos em probabilidades por uma função como softmax. Um procedimento de decodificação, que pode ser determinístico ou envolver amostragem, determina o próximo token.
O processo se repete até que a geração seja encerrada. Tudo isso envolve operações numéricas realizadas em hardware, frequentemente com grande paralelismo em GPUs ou aceleradores especializados.
Portanto, um LLM não deve ser entendido como um cérebro digital formado por bilhões de pequenas células artificiais conversando entre si. É uma arquitetura computacional que combina operações matriciais, transformações não lineares, mecanismos de atenção e parâmetros aprendidos durante o treinamento.
Essa distinção não significa que o cérebro não possa ser estudado matematicamente. Pelo contrário, a neurociência computacional utiliza modelos matemáticos para investigar o funcionamento neuronal. O ponto é que uma descrição matemática inspirada em determinado fenômeno biológico não implica sua reprodução integral.
Também precisamos distinguir treinamento de inferência. Durante o treinamento, os parâmetros do modelo são ajustados por algoritmos de otimização, geralmente utilizando gradientes calculados por retropropagação, para reduzir uma função de perda.
Durante a inferência convencional, esses parâmetros permanecem fixos. O que muda são as ativações internas produzidas pelo contexto recebido. Em sistemas que utilizam KV-cache, representações intermediárias também podem ser armazenadas temporariamente para tornar a geração mais eficiente.
Isso não equivale a modificar permanentemente os conhecimentos codificados nos parâmetros do modelo. Sistemas com memória externa, recuperação de informações ou mecanismos específicos de adaptação acrescentam outras possibilidades, mas precisam ser analisados separadamente.
Existem, naturalmente, arquiteturas que procuram reproduzir mais diretamente determinadas características dos neurônios biológicos. As chamadas spiking neural networks, por exemplo, utilizam eventos discretos e dinâmicas temporais inspiradas em aspectos dos disparos neuronais. Também existem pesquisas em computação neuromórfica, com circuitos e arquiteturas projetados para explorar princípios de processamento neuronal.
Mas essas abordagens não descrevem o funcionamento convencional dos grandes modelos de linguagem baseados em Transformers. Essa explicação nos leva a uma questão que considero ainda mais interessante: nossa linguagem sobre inteligência artificial pode estar criando uma imagem equivocada da própria tecnologia.
Falamos que modelos aprendem, prestam atenção, lembram, entendem, raciocinam e até pensam. Essas expressões podem ter significados técnicos ou funcionais legítimos. Redes neurais aprendem no sentido de que seus parâmetros são ajustados a partir de dados. Mecanismos de atenção modulam a combinação de informações. E modelos conseguem resolver problemas que, quando executados por seres humanos, envolvem raciocínio.
O problema aparece quando confundimos essas descrições funcionais com os mecanismos biológicos e psicológicos que deram origem aos termos. A atenção de um Transformer não é equivalente à atenção humana. As informações codificadas nos parâmetros de um modelo não constituem, por si só, memória autobiográfica. E a capacidade de produzir uma explicação coerente não demonstra consciência ou acesso introspectivo confiável aos processos que geraram aquela resposta.
É importante também evitar o erro oposto. O fato de um LLM funcionar por operações matemáticas não significa que suas capacidades sejam triviais, nem autoriza concluir que ele seja incapaz de realizar qualquer forma de raciocínio computacional. A questão relevante é identificar quais capacidades são demonstradas empiricamente, em quais condições aparecem, quais mecanismos contribuem para elas e onde estão suas limitações.
Da mesma forma, descrever os mecanismos matemáticos de um LLM não resolve definitivamente a questão filosófica e científica da consciência artificial.
Ainda não existe uma teoria universalmente aceita nem critérios empíricos conclusivos para identificar experiência subjetiva em sistemas artificiais. Não há evidência científica estabelecida de que os LLMs atuais possuam experiências subjetivas comparáveis às humanas. Mas ausência de evidência conclusiva não constitui, isoladamente, uma demonstração de impossibilidade.
É justamente por isso que considero fundamental separar três conceitos: analogia, equivalência funcional e equivalência de mecanismos.
Uma analogia aproxima conceitos para facilitar a compreensão. Uma equivalência funcional indica que sistemas diferentes podem apresentar comportamentos semelhantes em determinadas condições. Já uma equivalência de mecanismos exigiria demonstrar correspondências mais profundas entre os processos responsáveis por esses comportamentos. Essas três coisas não são intercambiáveis.
Uma rede neural artificial não é uma reprodução digital do cérebro humano. Sua origem histórica foi parcialmente inspirada em representações simplificadas de neurônios e conexões biológicas. Mas as arquiteturas contemporâneas também resultam de décadas de desenvolvimento matemático, engenharia computacional e experimentação empírica, frequentemente sem qualquer compromisso com a fidelidade biológica.
A inspiração histórica é real. A equivalência biológica, não. Isso não diminui a importância dos LLMs. Pelo contrário. É extraordinário que arquiteturas matemáticas treinadas em grande escala consigam desenvolver capacidades tão impressionantes de processamento de linguagem, generalização, programação, resolução de problemas e utilização de ferramentas.
Mas não precisamos atribuir características humanas aos modelos para reconhecer aquilo que conseguem fazer.
Depois de décadas acompanhando a evolução da IA, continuo achando fascinante observar como conceitos emprestados da biologia e da psicologia acabam adquirindo significados próprios na computação.
O risco aparece quando esquecemos que estamos utilizando analogias. Chamar uma operação matemática de neurônio não a transforma em uma célula. Chamar um mecanismo computacional de atenção não o transforma em atenção humana. E chamar determinado comportamento de raciocínio não demonstra que o processo que o produziu seja equivalente ao nosso.
Semelhança de comportamento não implica identidade de mecanismos. Compreender essas diferenças não é apenas uma curiosidade técnica. É fundamental para avaliarmos com rigor as capacidades, limitações e riscos da inteligência artificial.
A IA já é suficientemente impressionante pelo que realmente faz. Não precisamos transformá-la metaforicamente em um cérebro humano para reconhecer isso.

Particionar não é otimizar. É organizar
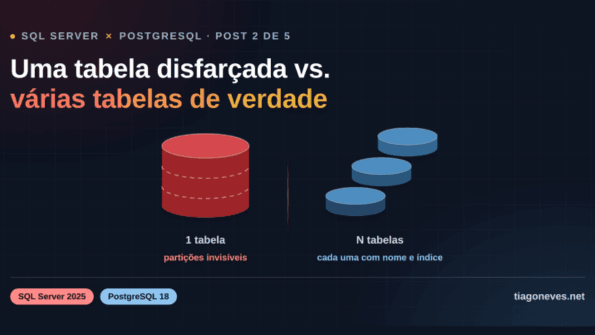
Uma tabela disfarçada vs. várias tabelas de verdade

C# – Entendendo o padrão Try
Como monitorar eventos da blockchain com ReactJS e Web3.js
 Luiz Fernando Duarte Junior
Spec-Driven Development: BMAD, OpenSpec e a Stack Agêntica
 José Carlos Macoratti
A IA terminou o trabalho. Agora começa o trabalho.
 Cezar Taurion
10 bibliotecas do iOS que você deve substituir antes de 2025
 Herlandro Hermogenes