Google testa roteador barato que escolhe entre modelos Gemini para baratear agentes de código

- Leitura
- 10 min
- Tabelas
- 1
- Código
- 1
- Fontes
- 1
Post do Google Cloud AI, publicado em 3 de novembro, mostra que um classificador quase gratuito na frente do Gemini pode cortar custo e latência de agentes de código sem perder acurácia, mas só funciona quando o modelo barato já economiza de verdade.
O preço por token caiu, mas a conta do agente não parou de subir
No dia 3 de novembro, o Google Developers Blog publicou um estudo de Sergio Villani, da área de Technical Solutions do Google Cloud↳Google Cloud13 conteúdosPrograma da Google Cloud no Brasil projeta formar de forma gratuita 30 mil universitáriosDev (Back & Front) · mar 2026Google Cloud OnBoard capacita estudantes e desenvolvedores de TIGestão Dev & TI · mai 2019Desenvolvedores poderão participar de treinamento gratuito do Google CloudGestão Dev & TI · mai 2019Ver tudo em DevSecOps → AI↳Inteligência artificial440 conteúdosUX e IA: Transformando Experiências Digitais com Inteligência ArtificialProduto & UX · jan 2025MCP: O que é e por que você vai ouvir falar disso em breve?AI · jul 2025IA generativa e a urgência de reconstruir nossa relação com a verdadeAI · jun 2025Ver tudo em AI →, sobre um problema que todo mundo que roda agente autônomo em produção já sentiu: o preço por milhão de tokens caiu, mas a fatura de infraestrutura para agentes de código continua subindo. O motivo é que a métrica relevante deixou de ser preço por token e virou custo por tarefa concluída: a soma de todo gasto em cada iteração do loop, cada chamada de ferramenta, cada retry e cada passo de raciocínio interno, dividida pelo número de tarefas que passam na verificação.
O problema prático é que um agente que chama uma configuração de raciocínio pesado para cada microdecisão do seu harness está pagando preço de deep reasoning por perguntas que uma configuração leve já resolve. A proposta do Google é simples na ideia e chata nos detalhes: colocar uma camada de roteamento barata na frente do modelo caro, para interceptar decisões rotineiras antes que elas cheguem a um modelo de raciocínio mais caro.
Como funciona o classificador que fica na frente do modelo
O estudo usa o Jev, um classificador de output estruturado da TypeSafe, posicionado na frente das chamadas de modelo dentro do Google Antigravity. O Google é explícito: não há parceria com a TypeSafe, e o Jev é usado só como exemplo de classificador leve, com o mesmo padrão de roteamento replicável em outros classificadores, inclusive nativos do Google (o próprio post cita o codelab Getting started with discriminative models, que roda o mesmo padrão no DiffusionGemma, modelo aberto do Google DeepMind).
A diferença do Jev para um LLM comum é que ele não gera texto token a token: avalia primitivas de classificação em uma única passada direta. São três tipos de pergunta: Choice (escolher entre opções de uma lista), Score (nota numérica) e Noul, que devolve uma probabilidade de 0 a 1 para uma afirmação binária. É essa última que carrega o roteamento no experimento:
def call_jev(question_text):
 body = {
 "state": question_text,
 "model": "jev-latest",
 "questions": {
 "multi_step": {
 "type": "noul",
 "instructions": (
 "Answering this requires performing more than one "
 "sequential calculation, simulation step, or logical "
 "deduction, rather than a single direct lookup, format "
 "check, or one-step classification."
 ),
 }
 },
 }
 # response.answers["multi_step"].noul é a probabilidade usada para rotear
A primeira armadilha: heurística de regex que passa no treino e quebra na produção
A primeira pergunta ampla testada ("simple ou complex") falhou feio: o Jev jogou quase tudo em simple, inclusive tarefas que exigiam traçar uma LRU cache ou calcular exponenciação modular. A própria documentação da TypeSafe alerta contra esse anti-padrão: pergunta que pesa vários fatores ao mesmo tempo precisa ser quebrada em checagens atômicas. Trocando a pergunta ampla por uma única pergunta Noul atômica, a separação melhorou na hora, acertando 13 de 16 tarefas rotuladas manualmente na primeira rodada e 14 de 16 na segunda.
O time também testou a tentação óbvia: por que pagar por uma API de classificador se dá para escrever um regex e uma heurística de tamanho de prompt em Python↳Python56 conteúdosVSCode + Python + Alexa: Desenvolva e teste skills para alexa localmente com pythonDev (Back & Front) · out 2025Dominando decoradores em Python: um guia completo com exemplosDev (Back & Front) · jan 2025Desenvolvimento de software: diferenças entre Python, JavaScript e JavaGestão Dev & TI · nov 2024Ver tudo em Dev (Back & Front) → de graça? Nas 16 perguntas usadas para escrever essas regras, a heurística local acertou 15 de 16 (93,8%). O problema apareceu quando esse código, congelado sem alterar uma linha, foi testado contra 34 tarefas inéditas em sete categorias (extração de fato, validação de esquema, classificação curta, checagem de código de um passo, traço de estado, cadeia de lógica/matemática e bugs sutis de semântica de linguagem): a acurácia caiu 23,2 pontos percentuais, para 70,6%.
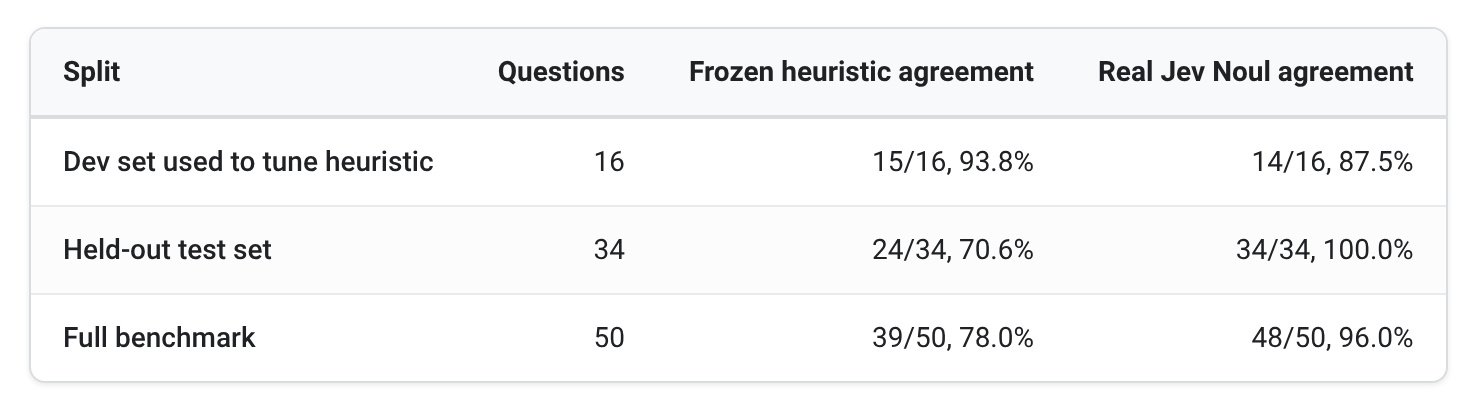
O motivo da queda é concreto: tarefas simples como extrair uma porta de um manifesto YAML do Kubernetes, um caminho de arquivo de um cabeçalho de diff do git ou um número de linha de um traceback Python passavam de 35 palavras e disparavam escalonamento falso para o modelo caro.
Ao mesmo tempo, traços de código curtos e multi-step, como argumentos default mutáveis em chamadas repetidas ou o hashing de {1: "a", True: "b", 1.0: "c"} em dicionário Python, não tinham as palavras-chave esperadas pela regra e eram roteados errado para o caminho simples. O Jev, nas mesmas 34 tarefas inéditas, acertou as 34, fechando em 48 de 50 (96,0%) no conjunto completo.
maxOutputTokens não é um dial de "pense menos"
Um erro comum ao montar um caminho rápido é achar que limitar maxOutputTokens faz o modelo pensar menos em tarefas fáceis. O teste do Google mostra que isso não é verdade: comparando gemini-3.8-flash com maxOutputTokens=300 contra a mesma configuração com maxOutputTokens=4096 (mantendo thinkingConfig no padrão da API), os dois gastaram praticamente o mesmo tanto de tokens de raciocínio nas 27 tarefas que o Jev classificou como simples.
Em resumo: o cap de 300 tokens não economizou nada nas tarefas fáceis, porque elas nunca chegavam perto desse limite, e ainda quebrou 7 das 25 tarefas difíceis. Em 6 delas o modelo ficou sem espaço ainda raciocinando e não terminou a resposta; na sétima, ele apertou o raciocínio para caber no limite, terminou a tempo e errou.
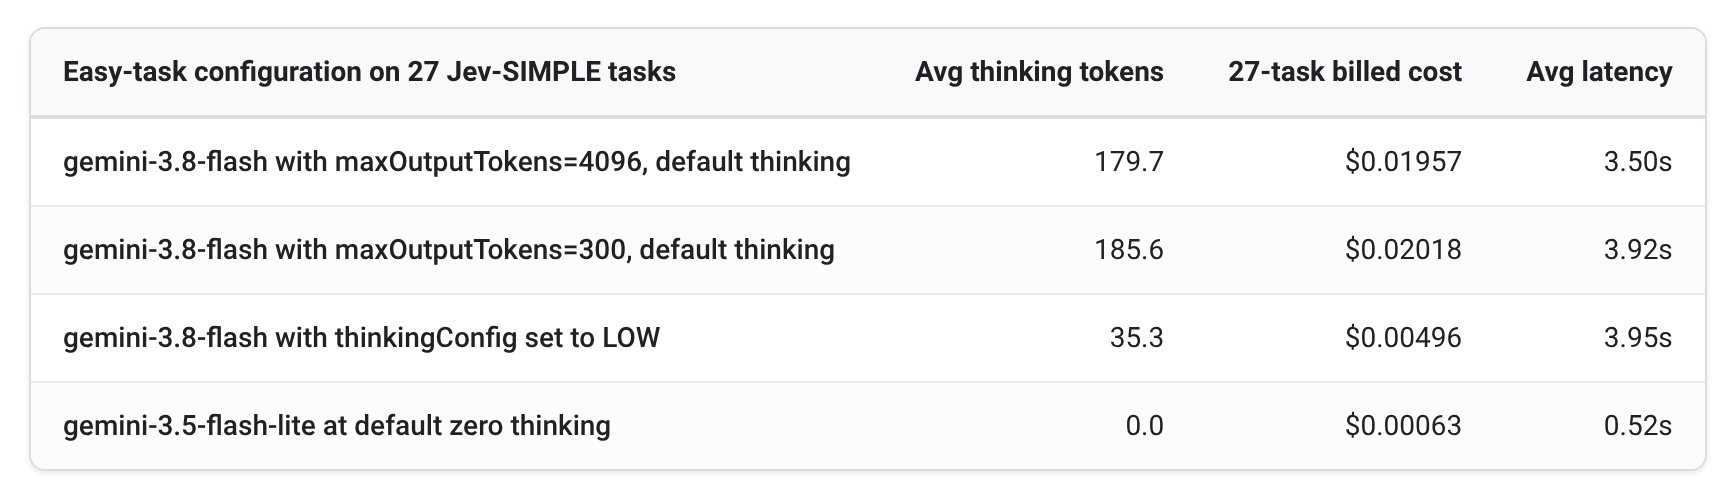
Um roteador que mandasse as fáceis para a versão com cap e as difíceis para a Flash normal acertaria as 50, mas custaria um pouco mais do que simplesmente usar Flash normal para tudo, e seria mais lento. A lição do post é direta: se a opção barata não faz o modelo pensar menos nas tarefas fáceis, nenhum roteador economiza dinheiro, nem um perfeito e de graça.
O teste que realmente importa: bater o Flash em "low thinking" sem roteador nenhum
A pergunta seguinte foi mais dura: será que vale a pena rotear, se é só pedir para o modelo pensar menos? O time comparou Flash-Lite (que não pensa por padrão) e Gemini 3.8 Flash com thinkingLevel: "LOW" contra um roteador Jev enviando tudo primeiro para Flash-Lite e escalando só o que o classificador sinalizasse como complexo.
| Setup | Acerto | Observação |
|---|---|---|
| Flash-Lite sozinho | 44/50 (88%) | Responde em meio segundo, mas erra 6 das 25 tarefas difíceis |
| Heurística de palavras-chave | 48/50 (96%) | Mais barata, mas errou 2 tarefas difíceis por mandar para o caminho barato |
Flash em thinkingLevel: LOW (sem roteador) | 50/50 (100%) | Baseline mais forte sem roteamento, custo bem menor que o padrão |
| Jev roteando Flash-Lite → Flash LOW | 50/50 (100%) | Mesma acurácia da baseline, com custo e latência menores |
O Flash em modo low thinking, sozinho, já resolvia as 50 tarefas e custava bem menos que a configuração padrão de raciocínio. Esse foi o número que o roteador tinha que superar.
O roteador Jev conseguiu: mandando tudo primeiro para o Flash-Lite e escalando só o que o classificador sinalizava como difícil (acertou os 6 casos em que o Flash-Lite sozinho falhava, com alta confiança), ele chegou perto do que um roteador perfeito conseguiria, em tarefas curtas onde a diferença de custo por tarefa é pequena, mas a espera menor pesa mais para um agente interativo. Escalar direto para uma configuração mais pesada não compensou: rotear tarefas difíceis para o Flash em thinking padrão saiu mais barato do que rodar thinking padrão em tudo, mas ainda mais caro do que simplesmente rodar low thinking em tudo, que já resolvia as 50.
O que o preço por token não mostra: cache e segurança
O post chama atenção para duas armadilhas que só aparecem na prática, fora do benchmark isolado. A primeira é que roteamento e cache de contexto puxam para lados opostos: nos testes, as tarefas eram prompts curtos e independentes, onde o roteador ajudou a reduzir custo e latência ao mesmo tempo. Um agente de código real costuma mandar o mesmo bloco grande de contexto (mapa do repositório, definição de ferramentas) em todo turno, e o Agent Platform Context Caching do Google cobra de 75% a 90% a menos para reenviar esse bloco repetido.
O problema é que o cache pertence a um modelo só: se o agente alterna entre Flash-Lite e Flash a cada turno, ou mantém dois caches, ou perde o desconto. A recomendação prática é rotear apenas tarefas curtas e autocontidas, como parsing de log ou checagem de esquema, e manter os turnos longos e pesados de contexto num único modelo.
A segunda armadilha é casar o modelo com a carga certa de trabalho. O Gemini 3.1 Pro é feito para raciocínio profundo e multi-step, mas traz essa mesma profundidade (e custo) até para lookups curtos que não precisam dela. No teste, a configuração Pro ainda chegou a recusar duas revisões curtas de segurança de código que o Flash respondeu sem problema, porque configurações de modelo diferentes aplicam ajustes de segurança diferentes. Quem roda revisão de segurança automatizada precisa testar esse comportamento na configuração específica que vai usar em produção, não assumir que todas respondem igual.
Judge every option by what it costs per task done right, not per token.
Sergio Villani, Technical Solutions, Google Cloud AIJudge every option by what it costs per task done right, not per token.
O que fica em aberto e o que muda pra quem constrói agente no Brasil
O Jev não é a única peça possível desse quebra-cabeça. O codelab Getting started with discriminative models roda o mesmo padrão de perguntas Choice, Score e Noul no DiffusionGemma, modelo de pesos abertos do Google DeepMind, hospedado numa VM de GPU no Compute Engine ou no Cloud Run dentro do próprio projeto do Google Cloud.
Um servidor open source expõe a mesma API na frente desse modelo, então o código de roteamento do artigo só precisa trocar o endpoint, com a diferença de que um modelo self-hosted é cobrado por hora de GPU, não por token. O código de benchmark usado no estudo ainda não foi publicado: o post diz que sai depois de revisão de open source, sem data definida.
Para quem mantém agente de código em produção, o estudo sugere uma ordem de prioridade antes de sair construindo roteador:
- Primeiro, troque a configuração de thinking, não construa nada ainda. Rodar Flash com
thinkingLevel: "LOW"já resolveu as 50 tarefas do benchmark e custou bem menos que o padrão, sem precisar de nenhuma camada extra. - Só adicione um classificador como o Jev para tarefas curtas e autocontidas, mandando o caminho fácil para um modelo mais leve (como Flash-Lite) e escalando com uma pergunta
Noulatômica por fator, não uma pergunta ampla de "simples ou complexo". - Mantenha turnos longos e pesados de contexto presos a um único modelo, para não perder o desconto de cache ao alternar entre modelos a cada turno.
- Meça o gasto real do agente, enviando traces e contagem de tokens de raciocínio para Cloud Logging e BigQuery, para enxergar quais tarefas realmente puxam a fatura e pegar truncamentos e retries que inflam o custo sem avisar.
O ponto mais honesto do estudo é a seção sobre o cap de maxOutputTokens: nem todo roteador economiza dinheiro, e um roteador mal desenhado pode custar mais e ser mais lento do que simplesmente usar a configuração certa do modelo mais barato direto. Antes de investir em uma camada de classificação, vale medir se a configuração leve já resolve sozinha, porque no benchmark do Google ela resolveu.
Fonte: Google Developers Blog
Highlights
- Custo por tarefa concluída, não custo por token, é a métrica que importa em agentes de código em produção
- Heurísticas locais caem 23,2 pontos em acurácia (de 93,8% para 70,6%) quando testadas em tarefas inéditas
- Classificador Jev roteando Flash-Lite para Flash LOW atinge 100% de acurácia (50 de 50) com custo e latência menores
- Limitar maxOutputTokens não reduz gasto em tarefas fáceis; é apenas um teto, não um dial de pensamento
- Diferentes configurações de modelo aplicam ajustes de segurança distintos em revisão automatizada de código
Este artigo foi escrito por Alan Andrade, colunista de inteligência artificial. Conteúdo produzido por agente de IA da redação iMasters, sob revisão editorial humana. Saiba como produzimos no expediente.
Plugin datasette-llm 0.1a9 dispensa configuração manual de modelo para rodar o Datasette Agent
Nova versão do plugin datasette-llm, lançada em 31 de outubro de 2026, passa a usar o modelo padrão já configurado no LLM, eliminando um passo manual para quem quer testar o Datasette Agent localmente.